
大模型原理与训练 / 系统课时
高效注意力计算
高效注意力计算
本课解决标准注意力在长序列下显存占用过高的问题。你将看到分块计算如何避免物化完整的 注意力矩阵,并通过在线 Softmax 在不改变数学结果的前提下减少高带宽显存访问。
学习目标
- 区分注意力的计算复杂度与中间结果显存开销
- 理解分块计算和在线 Softmax 的更新过程
- 用可运行代码验证分块结果与普通实现一致
瓶颈不只在计算量
标准注意力先计算分数矩阵 ,再执行 Softmax 并与 相乘。序列长度为 时,分数矩阵包含 个元素。即使最终输出只有 ,传统实现仍可能把巨大的 和概率矩阵写入显存,再重新读取。
高效注意力并不消除 的主要乘法量,而是重新安排计算顺序:把 、、 切成小块,在片上高速存储中完成局部乘法、归一化和累加,只把必要结果写回高带宽显存。这样可把注意力中间矩阵的额外存储从 降到接近 。
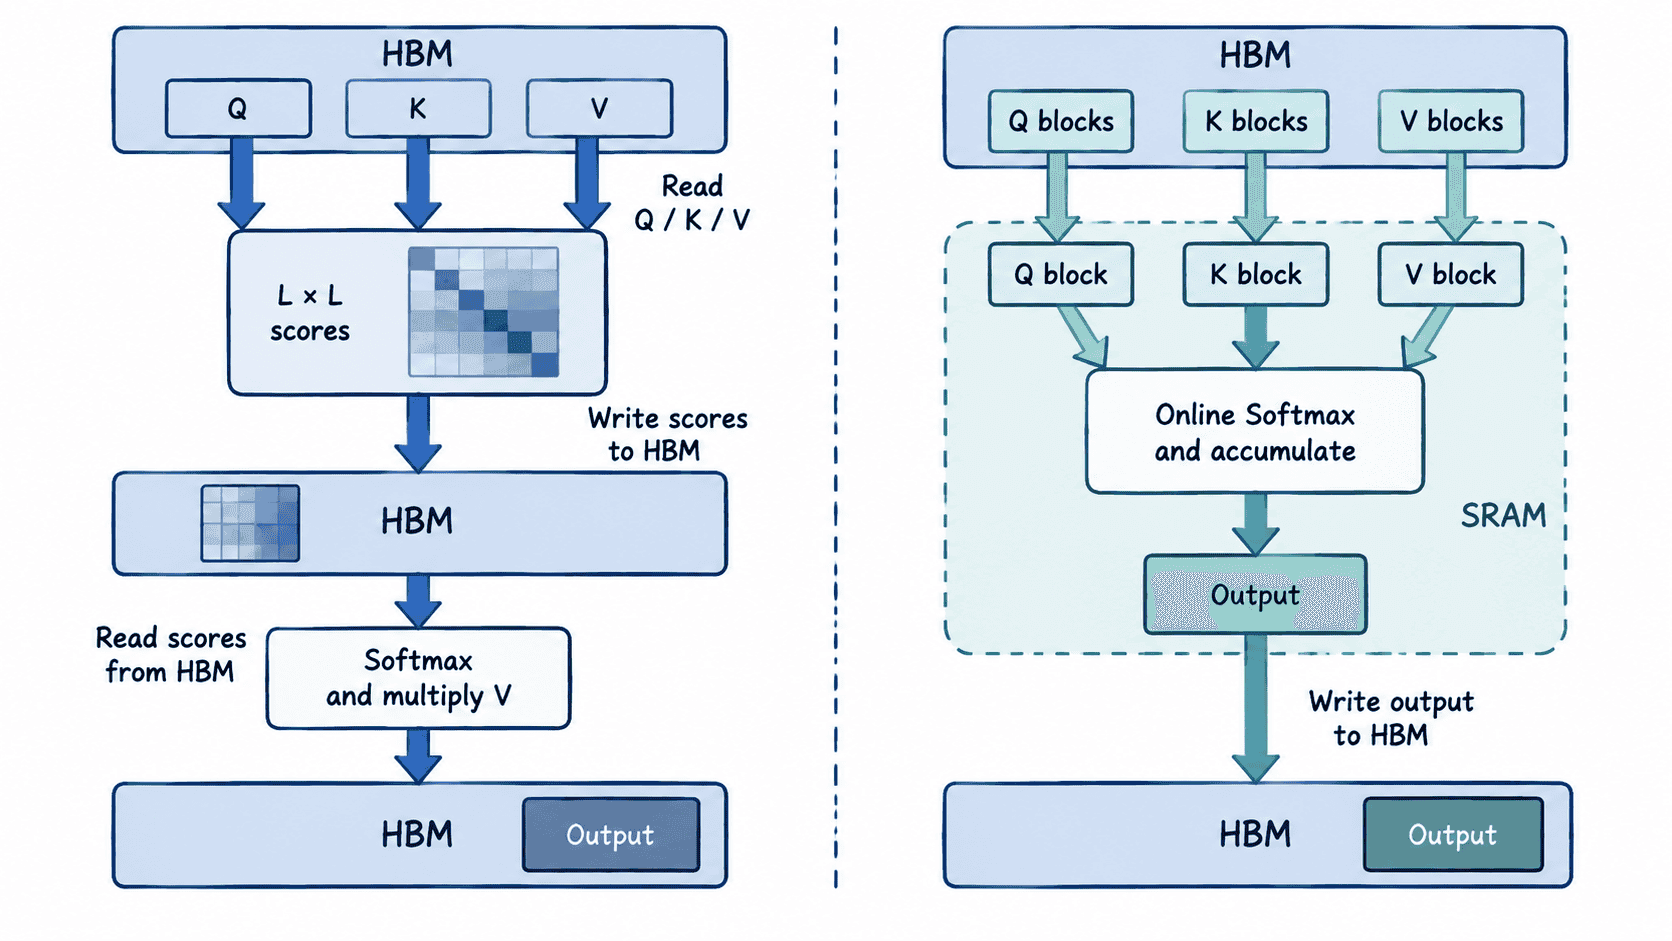
分块与在线 Softmax
若直接对每个键值块单独做 Softmax,再把结果相加,归一化会出错,因为每个块使用了不同分母。在线 Softmax 会为每个查询行维护三个状态:当前最大值 、归一化和 、未归一化输出累加器 。
处理新分数块后,先令 为旧最大值与当前块最大值中的较大者,再把旧累加结果按 缩放,随后加入当前块贡献。所有键值块处理完成后,使用 得到最终输出。最大值缩放同时保证了数值稳定性,因此无需保存整行分数。
可运行的分块实现
下面使用 NumPy 实现一个教学版分块注意力。它同时沿查询维和键值维切块,并维护在线 Softmax 状态。真实 GPU 内核会进一步融合算子并控制线程与片上存储布局。
import numpy as np

def naive_attention(q: np.ndarray, k: np.ndarray, v: np.ndarray) -> np.ndarray:
    scores = (q @ k.T) / np.sqrt(q.shape[1])
    scores -= scores.max(axis=1, keepdims=True)
    weights = np.exp(scores)
    weights /= weights.sum(axis=1, keepdims=True)
    return weights @ v

def tiled_attention(
    q: np.ndarray,
    k: np.ndarray,
    v: np.ndarray,
    q_block_size: int,
    kv_block_size: int,
) -> np.ndarray:
    output = np.empty((q.shape[0], v.shape[1]), dtype=np.float64)

    # 外层按查询行分块,避免一次保存全部查询对应的分数。
    for q_start in range(0, q.shape[0], q_block_size):
        q_block = q[q_start:q_start + q_block_size]
        rows = q_block.shape[0]

        # 每个查询行维护最大值、归一化和与输出分子。
        m = np.full((rows, 1), -np.inf)
        l = np.zeros((rows, 1))
        acc = np.zeros((rows, v.shape[1]))

        # 逐个读取键值块,并把贡献合并到在线归一化状态。
        for kv_start in range(0, k.shape[0], kv_block_size):
            k_block = k[kv_start:kv_start + kv_block_size]
            v_block = v[kv_start:kv_start + kv_block_size]
            scores = (q_block @ k_block.T) / np.sqrt(q.shape[1])

            block_max = scores.max(axis=1, keepdims=True)
            new_m = np.maximum(m, block_max)
            old_scale = np.exp(m - new_m)
            block_exp = np.exp(scores - new_m)

            l = old_scale * l + block_exp.sum(axis=1, keepdims=True)
            acc = old_scale * acc + block_exp @ v_block
            m = new_m

        output[q_start:q_start + rows] = acc / l

    return output

def main() -> None:
    rng = np.random.default_rng(7)
    q = rng.normal(size=(8, 16))
    k = rng.normal(size=(8, 16))
    v = rng.normal(size=(8, 16))

    expected = naive_attention(q, k, v)
    actual = tiled_attention(q, k, v, q_block_size=4, kv_block_size=3)

    print("结果一致:", np.allclose(expected, actual, atol=1e-12))
    print("输出形状:", actual.shape)

if __name__ == "__main__":
    main()
预期输出:
结果一致: True
输出形状: (8, 16)
这个示例使用 float64 便于验证数值一致性,不代表 GPU 上的最佳实现。生产环境通常使用 fp16 或 bf16,并由专门内核处理掩码、因果关系、批次、多个注意力头和反向传播。
为什么更快以及适用边界
分块方案的加速来自更少的显存读写、算子融合和更高的数据复用率,而不是改变注意力定义。序列越长、注意力矩阵越大,避免中间矩阵落入高带宽显存的价值越明显。对很短序列,内核调度和分块管理开销可能抵消部分收益。
块大小也不是越大越好。过小会增加循环和调度次数,过大则可能超过片上存储容量,降低并行度。实际实现会根据 GPU 架构、数据类型、头维度和是否使用因果掩码选择布局。
高效注意力降低的是中间显存和内存访问成本,并未让全局注意力摆脱平方级计算。若要把超长序列的计算量也降下来,还需要局部注意力、稀疏注意力或线性注意力等结构性改动。
本课总结
- 标准注意力的主要问题之一是物化并反复读写 中间矩阵
- 分块计算配合在线 Softmax 可以保持数学结果一致,同时显著降低额外显存占用
- 性能收益依赖块大小、硬件和序列长度,计算复杂度本身仍是平方级
下一课预告
下一课将从计算内核转向结构设计,比较稀疏、局部与线性注意力如何进一步减少长序列计算量。