
大模型原理与训练 / 系统课时
重复与长度控制
重复与长度控制
文本生成出现循环句、迟迟不结束或输出被截断,通常不是模型“坏了”,而是解码阶段缺少边界控制。本课将用一个可运行示例,把重复惩罚、停止标记和最大生成长度组合成稳定的生成策略。
学习目标
- 理解重复惩罚、停止标记和长度限制分别解决什么问题
- 掌握三类参数在生成循环中的执行顺序
- 能根据输出异常选择合适的控制参数
三类控制各自负责什么
重复惩罚会降低已经出现过的 token 再次被选中的概率,适合缓解短语循环;停止标记在生成到指定 token 或字符串时立即结束;长度限制则提供最终兜底,避免模型在未命中停止条件时无限继续。
| 控制方式 | 主要作用 | 常用参数 | 典型风险 |
|---|---|---|---|
| 重复惩罚 | 抑制已出现 token | repetition_penalty |
数值过高会让语句生硬 |
| 停止标记 | 命中边界后立即结束 | eos_token_id、stop |
标记分词不一致会失效 |
| 长度限制 | 限制最多生成多少内容 | max_new_tokens |
过小会截断完整句子 |
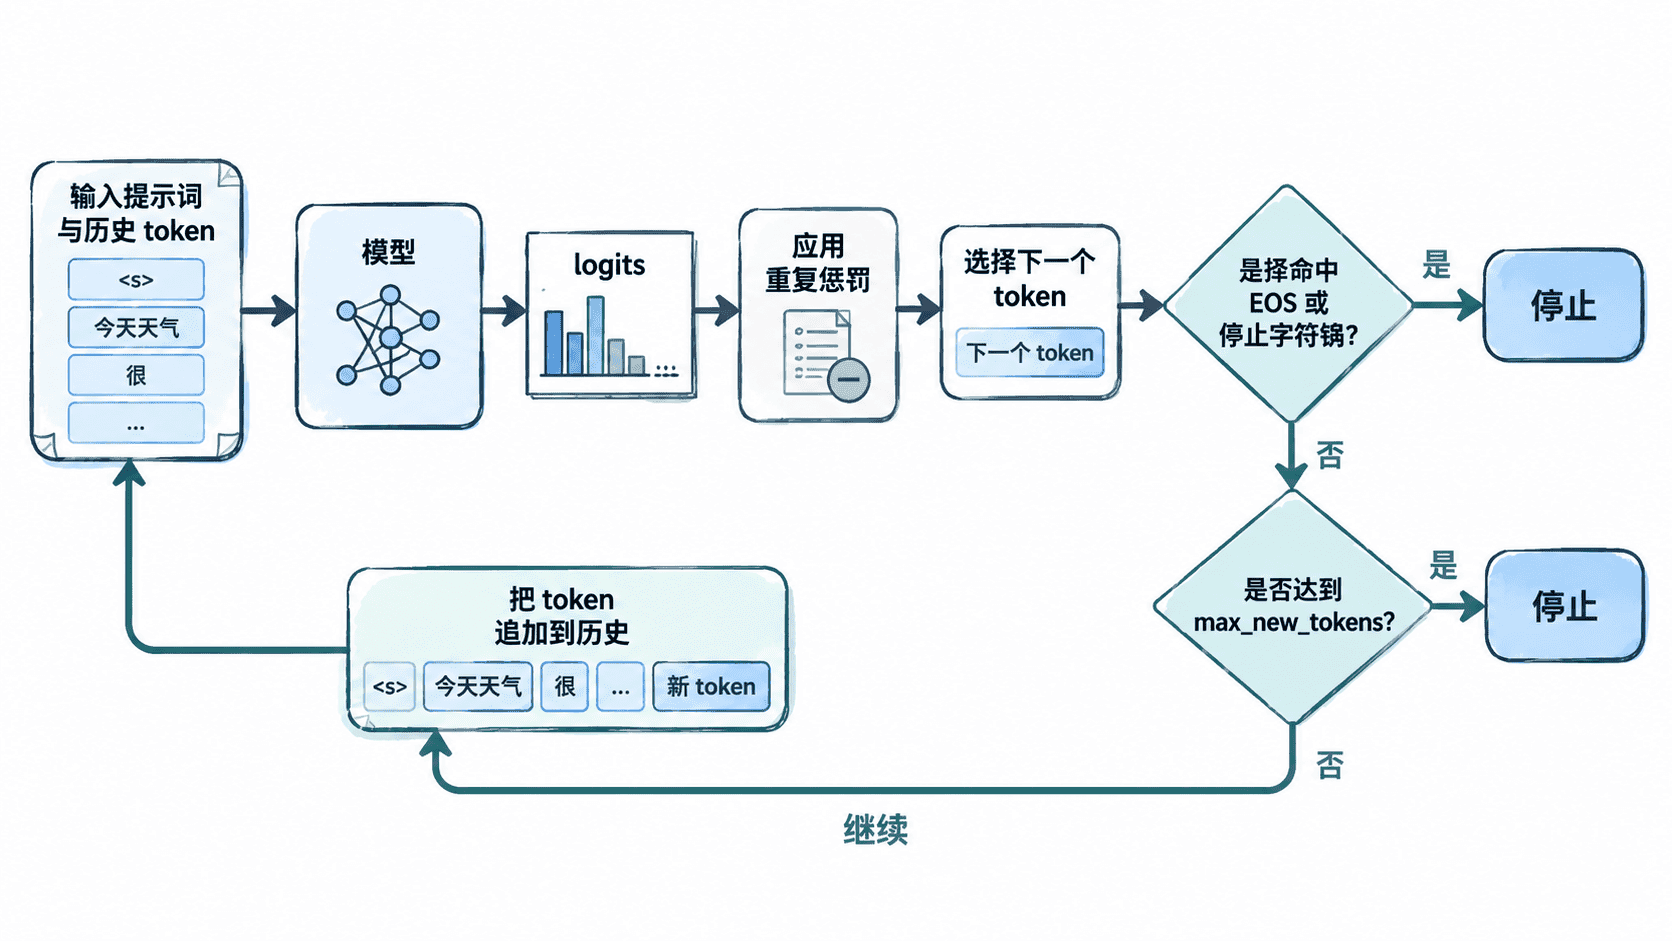
生成循环如何决定结束
一次生成通常先计算下一个 token 的分数,再对历史中出现过的 token 应用重复惩罚,然后选择候选 token。候选结果若是结束标记,或解码后的文本命中停止字符串,就立即终止;否则追加到序列,并检查新增 token 数是否达到上限。
max_new_tokens 只计算新生成的 token,更适合接口调用;max_length 往往包含提示词与生成结果,长提示词可能提前耗尽额度。两者同时存在时,应确认框架采用哪个限制,避免误判截断原因。
可运行示例
下面的 Python 程序用固定 logits 模拟三轮贪心解码。它不是完整语言模型,但完整展示了重复惩罚、EOS 停止和最大新增长度的执行位置。
from typing import Dict, List

VOCAB: Dict[int, str] = {
    0: "<eos>",
    1: "我",
    2: "喜欢",
    3: "学习",
    4: "很",
}

LOGITS_STEPS: List[List[float]] = [
    [-2.0, 0.5, 0.4, 3.0, 1.0],
    [-2.0, 0.3, 0.2, 3.1, 2.8],
    [3.2, 0.2, 0.1, 3.0, 2.9],
]

def apply_repetition_penalty(
    logits: List[float],
    seen_token_ids: set[int],
    penalty: float,
) -> List[float]:
    adjusted = logits.copy()
    for token_id in seen_token_ids:
        score = adjusted[token_id]
        # 正分数除以惩罚系数,负分数乘以惩罚系数,都会降低再次选择的机会。
        adjusted[token_id] = score / penalty if score > 0 else score * penalty
    return adjusted

def generate(
    prompt_ids: List[int],
    repetition_penalty: float = 1.2,
    max_new_tokens: int = 5,
    eos_token_id: int = 0,
) -> List[int]:
    generated: List[int] = []

    for logits in LOGITS_STEPS[:max_new_tokens]:
        seen = set(prompt_ids + generated)
        adjusted = apply_repetition_penalty(logits, seen, repetition_penalty)
        next_token_id = max(range(len(adjusted)), key=adjusted.__getitem__)

        # EOS 只负责结束,不加入最终可见文本。
        if next_token_id == eos_token_id:
            break

        generated.append(next_token_id)

    return generated

prompt = [1, 2]
new_tokens = generate(prompt)
text = " ".join(VOCAB[token_id] for token_id in prompt + new_tokens)

print(f"生成结果: {text}")
print(f"新增 token 数: {len(new_tokens)}")
预期输出
生成结果: 我 喜欢 学习 很
新增 token 数: 2
第三轮中 EOS 的分数最高,因此生成在达到 max_new_tokens=5 之前结束。若始终没有命中 EOS,循环仍会被最大新增长度截断。
参数边界与常见错误
重复惩罚通常应从接近 1.0 的数值小幅上调;过高会压制必要的代词、术语和标点。停止字符串必须按模型实际解码结果设置,尤其要检查前导空格、换行和多 token 分词。
长度限制只保证“停下来”,不保证句子完整。需要结构化输出时,应同时设计明确的结束标记,并在应用层验证 JSON、代码块或字段是否闭合,而不是只依赖最大长度。
本课总结
- 重复惩罚降低循环概率,但数值过高会损伤表达质量
- 停止标记负责正常结束,长度限制负责异常兜底
- 优先使用
max_new_tokens控制新增内容,并验证停止字符串的实际分词
下一课预告
下一课将学习 KV Cache,理解生成循环如何复用历史键和值,减少每一步对已生成内容的重复计算。