
大模型原理与训练 / 系统课时
构建推理接口
构建推理接口
本课把分词、模型推理和结果整理封装成一个可调用的 HTTP 服务。完成后,你将得到一个能校验参数、复用已加载模型、限制并发并返回生成耗时的最小推理接口。
学习目标
- 设计清晰的推理请求与响应结构
- 使用 FastAPI 封装完整的文本生成链路
- 通过健康检查和接口调用验证服务可用性
明确接口边界与处理链路
一个可维护的推理接口不应让路由函数直接堆满模型细节。请求进入后,应依次完成参数校验、分词、张量迁移、模型生成、解码和响应组装;模型与分词器则在进程启动时加载一次,避免每个请求重复占用时间和显存。
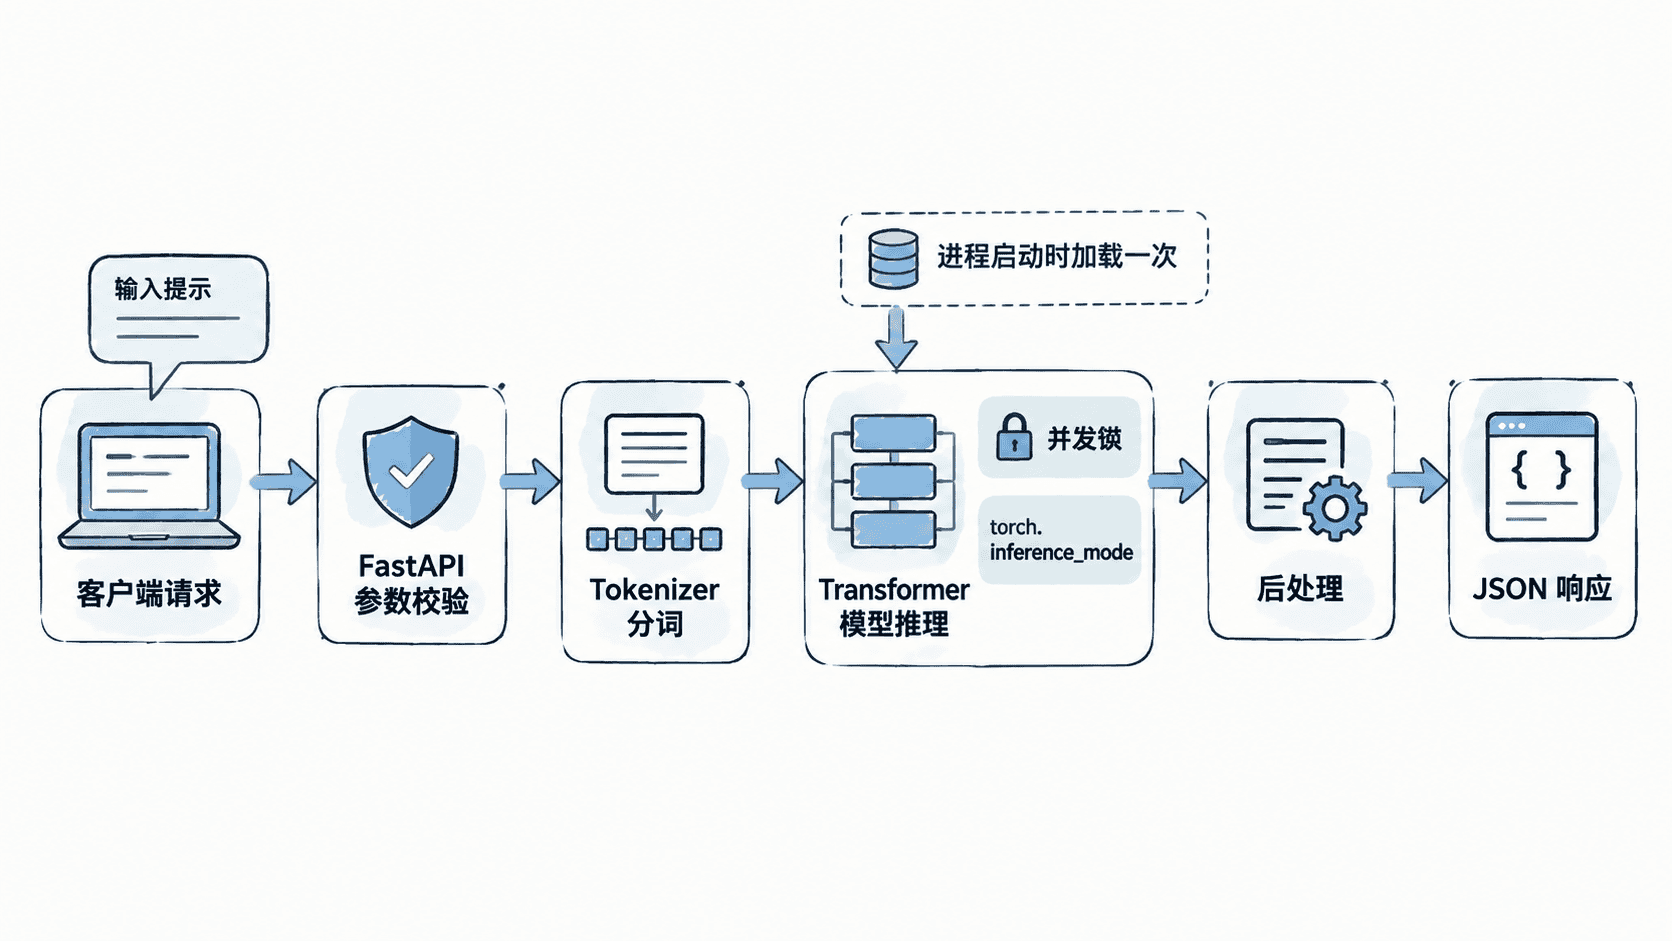
请求参数只暴露业务真正需要控制的选项,例如提示词、最大生成长度、温度和 top_p。设备选择、张量搬运、模型对象和异常堆栈属于服务内部实现,不应由调用方传入或直接返回。
实现最小 FastAPI 服务
先安装运行依赖。示例使用 distilgpt2,便于在 CPU 或单张 GPU 上验证接口结构;替换模型时,接口契约可以保持不变。
python -m pip install fastapi "uvicorn[standard]" torch transformers预期输出
Successfully installed <PACKAGES>将下面的完整代码保存为 app.py。代码在启动阶段加载模型,使用 torch.inference_mode() 关闭梯度记录,并通过异步锁避免多个请求同时争抢同一张设备。
import asyncio
import logging
import time
from contextlib import asynccontextmanager

import torch
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_NAME = "distilgpt2"
DEVICE = "cuda" if torch.cuda.is_available() else "cpu"

logger = logging.getLogger("inference-api")
tokenizer = None
model = None
generate_lock = asyncio.Lock()

class GenerateRequest(BaseModel):
    prompt: str = Field(min_length=1, max_length=2000)
    max_new_tokens: int = Field(default=64, ge=1, le=128)
    temperature: float = Field(default=0.0, ge=0.0, le=2.0)
    top_p: float = Field(default=0.9, gt=0.0, le=1.0)

class GenerateResponse(BaseModel):
    text: str
    generated_tokens: int
    latency_ms: float

@asynccontextmanager
async def lifespan(app: FastAPI):
    global tokenizer, model

    # 模型只在进程启动时加载一次,避免请求内重复初始化。
    tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
    if tokenizer.pad_token_id is None:
        tokenizer.pad_token = tokenizer.eos_token

    model = AutoModelForCausalLM.from_pretrained(MODEL_NAME)
    model.to(DEVICE)
    model.eval()
    yield

app = FastAPI(title="Transformer Inference API", lifespan=lifespan)

def generate_text(request: GenerateRequest) -> GenerateResponse:
    if tokenizer is None or model is None:
        raise RuntimeError("model is not initialized")

    inputs = tokenizer(
        request.prompt,
        return_tensors="pt",
        truncation=True,
        max_length=512,
    ).to(DEVICE)

    generate_options = {
        "max_new_tokens": request.max_new_tokens,
        "do_sample": request.temperature > 0,
        "pad_token_id": tokenizer.pad_token_id,
    }
    if request.temperature > 0:
        generate_options["temperature"] = request.temperature
        generate_options["top_p"] = request.top_p

    started_at = time.perf_counter()
    with torch.inference_mode():
        output_ids = model.generate(**inputs, **generate_options)
    latency_ms = (time.perf_counter() - started_at) * 1000

    prompt_length = inputs["input_ids"].shape[1]
    generated_ids = output_ids[0, prompt_length:]
    text = tokenizer.decode(generated_ids, skip_special_tokens=True)

    return GenerateResponse(
        text=text,
        generated_tokens=int(generated_ids.shape[0]),
        latency_ms=round(latency_ms, 2),
    )

@app.get("/health")
async def health() -> dict[str, str]:
    return {"status": "UP", "model": MODEL_NAME, "device": DEVICE}

@app.post("/generate", response_model=GenerateResponse)
async def generate(request: GenerateRequest) -> GenerateResponse:
    try:
        # 推理属于阻塞任务,放入工作线程,避免阻塞事件循环。
        async with generate_lock:
            return await asyncio.to_thread(generate_text, request)
    except RuntimeError as exc:
        logger.exception("model inference failed")
        if torch.cuda.is_available():
            torch.cuda.empty_cache()
        raise HTTPException(status_code=500, detail="model inference failed") from exc
预期结果
app.py 可通过 Python 语法检查;服务启动后提供 GET /health 与 POST /generate 两个接口。启动并调用接口
启动服务时,开发环境可以使用单进程。单卡部署不要盲目增加 worker,因为每个 worker 都会各自加载一份模型。
python -m uvicorn app:app --host 0.0.0.0 --port 8000预期输出
INFO: Application startup complete.
INFO: Uvicorn running on http://0.0.0.0:8000
另开终端发送生成请求。动态生成文本、token 数和耗时会因设备、模型缓存和输入内容不同而变化。
curl -s http://127.0.0.1:8000/generate -H "Content-Type: application/json" -d '{"prompt":"Transformer models can","max_new_tokens":32,"temperature":0}'预期输出
{"text":"<GENERATED_TEXT>","generated_tokens":<TOKEN_COUNT>,"latency_ms":<LATENCY_MS>}处理输入、并发与异常边界
输入长度必须和生成预算一起控制。示例把提示词截断到 512 个 token,并把 max_new_tokens 限制为 128,从而避免单个请求无限占用计算资源;生产环境还应根据模型上下文窗口校验“输入 token 数加生成 token 数”是否越界。
异步接口并不等于模型可以无限并发。单张 GPU 上同时执行多个 generate() 往往会抬高显存峰值并恶化尾延迟,因此示例先用锁串行化推理。需要更高吞吐量时,应改用动态批处理或专用推理引擎,而不是简单移除锁。
服务端不应把底层异常原文直接返回客户端。显存不足、模型未初始化和输入越界应记录完整日志,再映射为稳定的 HTTP 状态码与错误结构;网关层还应补充请求超时、请求体大小限制和追踪 ID。
验收接口是否可上线
最小验收至少覆盖健康检查、正常生成、空提示词、超长参数和并发请求。健康检查只能证明进程存活;更严格的就绪检查还应确认模型已经加载,并可执行一次极短的探针推理。
上线前确认同一输入在 temperature=0 时结果可复现,接口返回的 token 数与实际生成一致,连续请求不会持续增加显存。随后再记录首词延迟、生成速度和吞吐量,作为容量规划依据。
本课总结
- 推理接口应把参数校验、分词、生成、解码和响应组装分成清晰链路
- 模型必须在启动阶段复用,并使用推理模式、输入上限和并发控制保护资源
- 健康检查与真实生成请求要分别验证,不能只凭端口可访问判断服务可用
下一课预告
下一课将建立可重复的性能压测方法,分别测量首词延迟、解码速度、批量吞吐量和峰值显存,并学习如何根据指标定位瓶颈。