
大模型原理与训练 / 系统课时
多头注意力输出映射
多头注意力输出映射
多个注意力头会分别提取不同关系,但这些结果不能直接作为模块输出。本课从张量形状出发,说明如何先拼接各头,再通过输出矩阵完成信息混合,并准确计算这一层的参数规模。
学习目标
- 说清多头结果从拼接到线性投影的完整过程
- 根据头数、单头维度和模型维度推导张量形状
- 计算输出映射及完整多头注意力的主要参数量
为什么拼接后还要映射
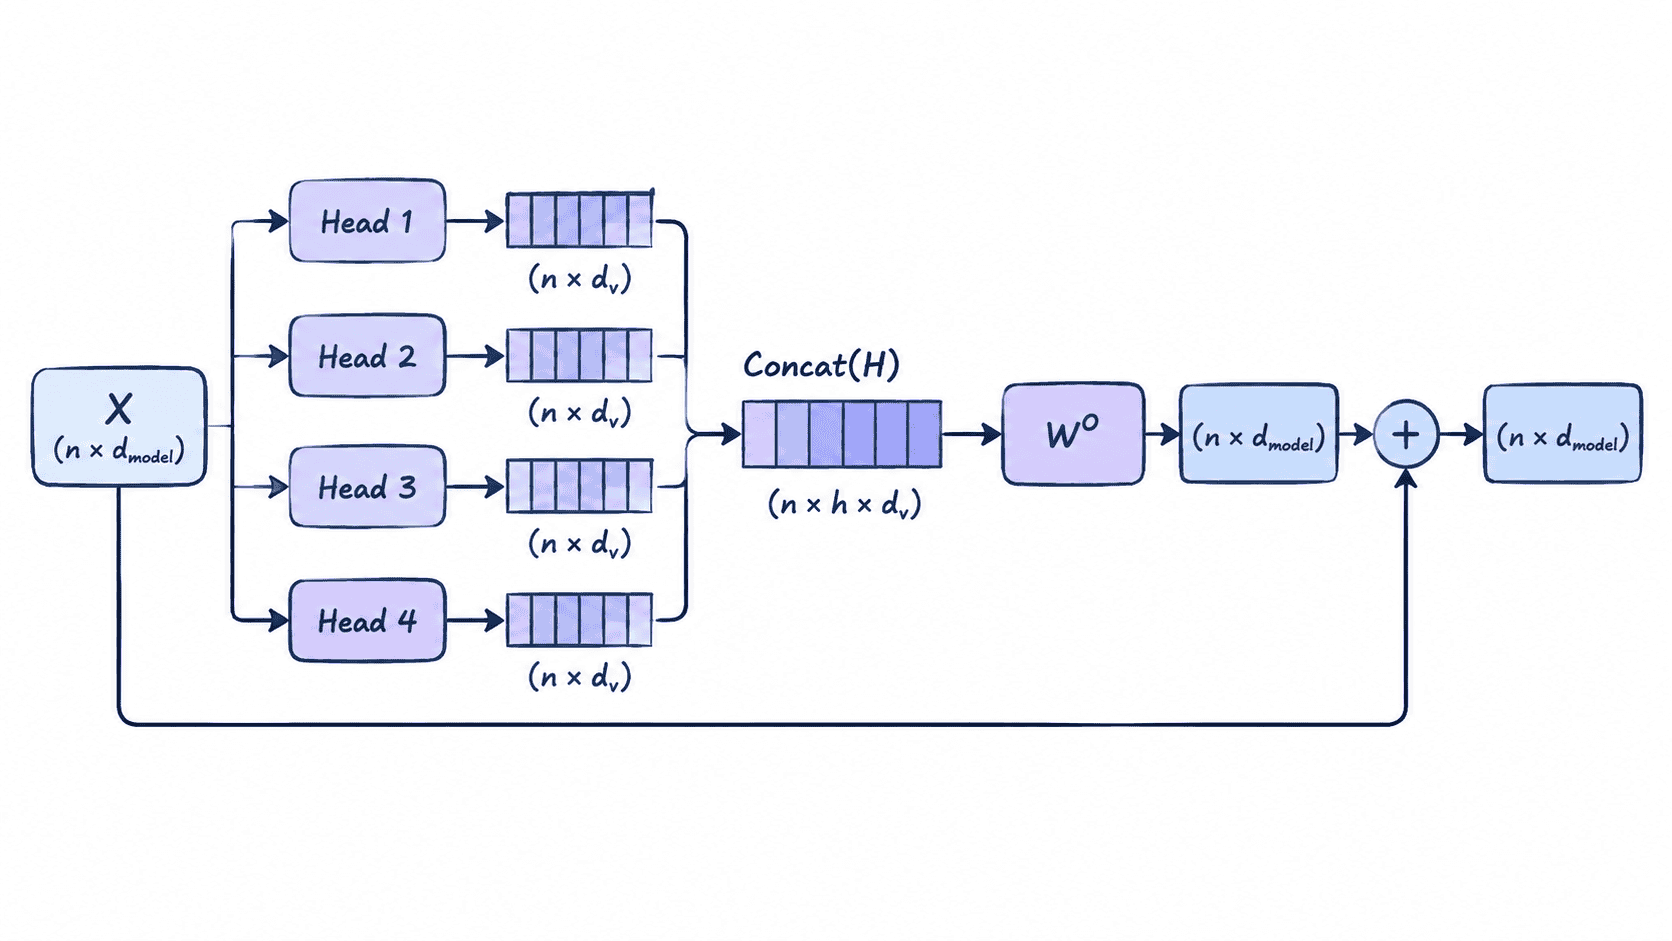
设第 个注意力头的输出为 。多头注意力先把所有头沿最后一个维度拼接,再乘输出矩阵:
拼接只负责保留各头的信息,不会主动建立头与头之间的组合关系。矩阵 会重新混合这些特征,并把结果投影回模型统一使用的 维,使残差连接可以执行 。
张量形状如何变化
若批量大小为 、序列长度为 、头数为 、单头值向量维度为 ,则每个头的输出形状是 。拼接后得到:
因此输出矩阵必须满足:
标准 Transformer 通常令 ,所以 。此时拼接前后总特征宽度没有增加,只是把同一宽度拆给多个头并行学习。
参数规模怎么算
输出映射的权重参数量为 ,若包含偏置,再加 。当 时:
例如 、、,拼接宽度仍为 ,则 有 个权重,加上 个偏置,共 个参数。
下面的可运行示例验证形状与参数量:
python
d_model = 512
num_heads = 8
d_v = 64

concat_dim = num_heads * d_v
weight_params = concat_dim * d_model
bias_params = d_model

print(f"拼接维度: {concat_dim}")
print(f"W^O 形状: ({concat_dim}, {d_model})")
print(f"输出映射参数量: {weight_params + bias_params}")
预期输出:
text
拼接维度: 512
W^O 形状: (512, 512)
输出映射参数量: 262656
实际模型还包含 、、 三组投影。忽略偏置且各投影总宽度均为 时,多头注意力四个线性映射的参数量约为 ,其中输出映射占四分之一。
容易混淆的两个点
拼接不是求和或平均。求和会让不同头在进入输出层前丢失各自的特征位置,而拼接会完整保留每个头的输出,再交给 学习如何组合。
输出矩阵也不是每个头独立拥有一份。所有头先拼接,再共享同一个 ;因此它正是跨头信息交互的关键位置。
本课总结
- 多头输出先沿特征维拼接,再由 混合并投影回
- 标准设置下 ,输出映射参数量约为
- 拼接保留各头信息,线性投影负责学习跨头组合并适配残差连接
下一课预告
下一课将学习正弦位置编码,理解 Transformer 如何在没有循环结构的情况下表示词元顺序与相对距离。
按自己的节奏,确认真正理解。