
大模型原理与训练 / 系统课时
编码器与解码器架构
编码器与解码器架构
Transformer 可以按任务需求组合成编码器、解码器或编码器—解码器三类架构。本课将从信息可见范围、数据流向和输出方式入手,帮助你判断不同结构各自适合解决什么问题。
学习目标
- 区分编码器与解码器的基本职责
- 说明三类 Transformer 架构的数据流和注意力差异
- 根据任务目标选择合适的架构类型
两种基本职责:理解与生成
编码器负责把输入序列转换为包含上下文信息的表示。它通常允许每个位置同时查看前后文,因此更适合回答“这段输入表达了什么”“每个位置属于什么类别”之类的问题。
解码器负责按顺序生成输出。生成第 个词元时,只能查看已经出现的前 个词元,不能提前看到未来答案。这个限制通过因果掩码实现,保证训练阶段与实际生成过程保持一致。
三类架构如何组成
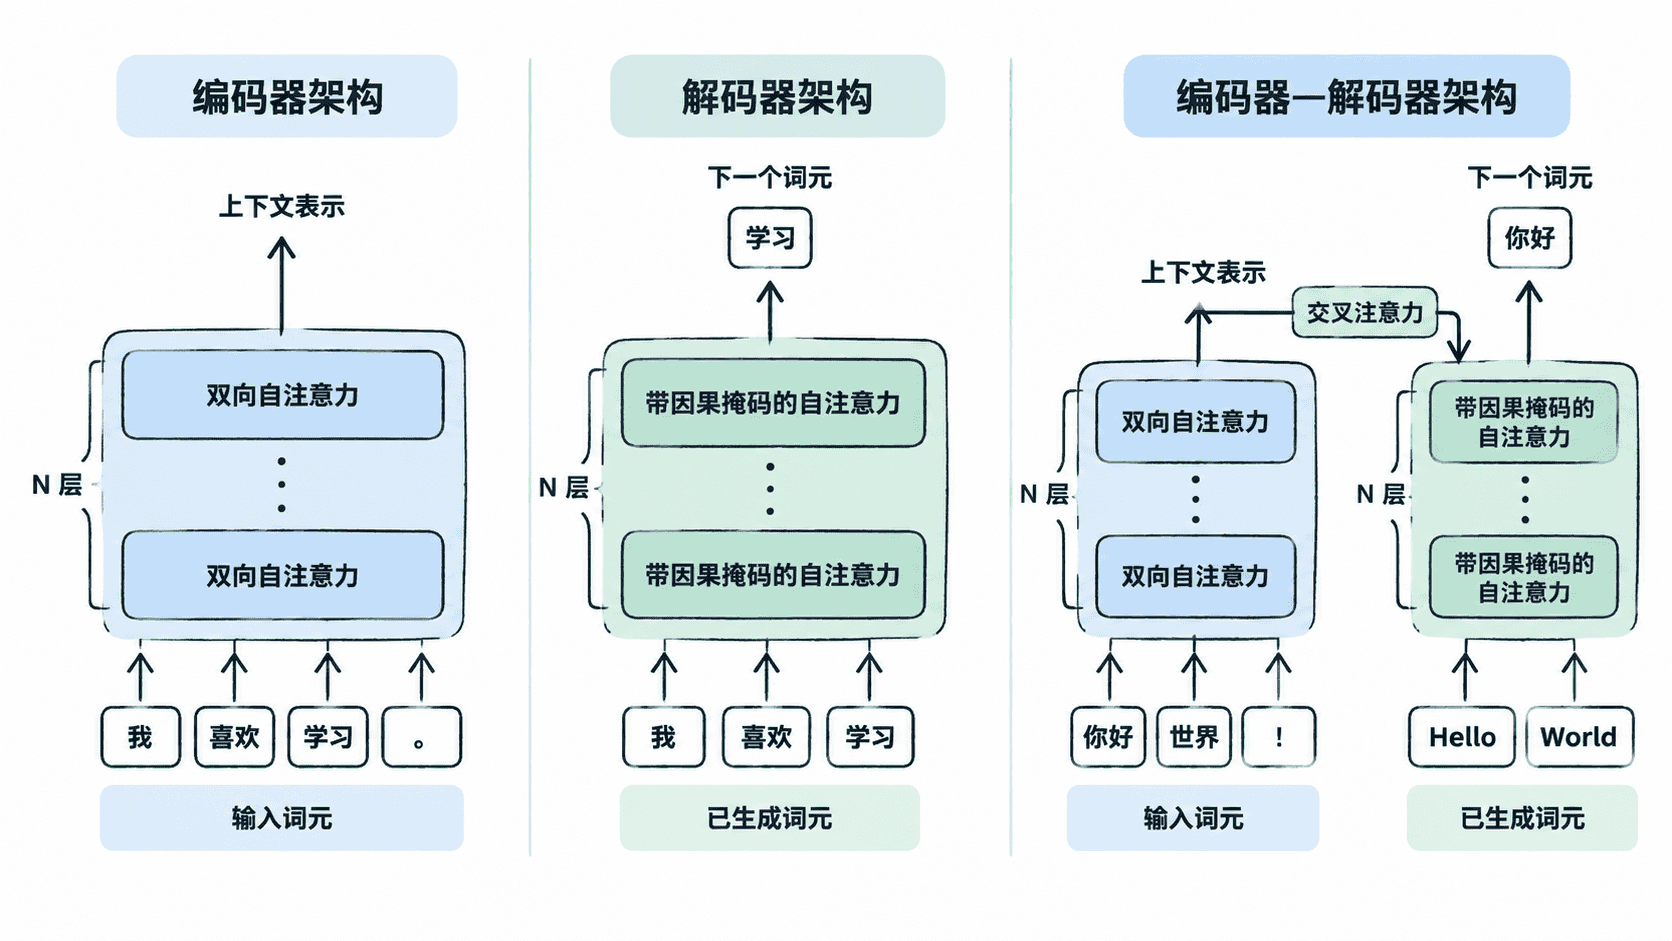
编码器架构
编码器架构只保留编码器堆栈。每层通常包含双向自注意力和前馈网络,输出的每个位置都融合了完整上下文。它适合文本分类、序列标注、信息抽取、相似度计算和向量表示等“理解输入”的任务。
解码器架构
解码器架构只保留解码器堆栈,核心是带因果掩码的自注意力。模型根据已有上下文预测下一个词元,再把新词元追加到序列中继续预测。它适合开放式文本生成、代码补全和对话生成等任务。
编码器—解码器架构
这类结构先由编码器读取完整输入,再由解码器逐步生成输出。解码器除了使用因果自注意力,还会通过交叉注意力读取编码器表示,因此特别适合输入与输出边界明确的转换任务,如翻译、摘要和格式转换。
三类结构的关键差异可以归纳如下:
| 架构 | 输入可见范围 | 主要输出 | 典型任务 |
|---|---|---|---|
| 编码器 | 同时查看前后文 | 上下文表示或标签 | 分类、抽取、检索 |
| 解码器 | 只能查看已生成内容 | 下一个词元 | 续写、对话、代码生成 |
| 编码器—解码器 | 编码器看完整输入,解码器看历史输出并读取编码结果 | 条件生成序列 | 翻译、摘要、结构转换 |
如何选择架构
先判断任务最终需要“理解结果”还是“连续生成”。如果输出是类别、标签、向量或输入片段位置,优先考虑编码器;如果目标是根据上下文不断续写,优先考虑解码器;如果存在清晰的输入序列和目标输出序列,并且输出必须紧密依赖输入,编码器—解码器通常更直接。
架构名称只描述主体结构,并不代表能力边界绝对固定。例如,解码器也能通过提示完成分类,但它仍以生成下一个词元的方式给出答案。选型时应同时考虑任务形式、训练数据、推理速度和部署成本,而不是只看模型名称。
本课总结
- 编码器使用双向上下文,重点是把输入转换为高质量表示
- 解码器使用因果掩码,重点是根据历史内容逐步生成
- 编码器—解码器通过交叉注意力连接输入理解与条件生成
下一课预告
下一课将继续深入 Transformer 的内部模块,拆解自注意力层如何从输入表示计算出查询、键、值和最终输出。