
大模型原理与训练 / 系统课时
性能压测
性能压测
本课建立一套可重复的 Transformer 推理基准,区分首个可显示文本延迟、解码速度、批量吞吐量和峰值显存。完成后,你可以用统一口径比较不同设备、精度与批大小。
学习目标
- 正确定义 TTFT、生成速度、吞吐量和显存峰值
- 编写可运行的本地模型压测脚本
- 根据指标组合判断预填充、解码或显存瓶颈
统一四类核心指标
首词延迟 TTFT 表示从请求开始到客户端收到首个可显示文本片段的时间,可写为 。它主要受输入长度、预填充计算、排队时间和服务开销影响,是交互体验最敏感的指标。
生成速度关注首个片段之后的持续解码能力。输出 token 数为 时,可用 近似计算每秒生成 token 数。吞吐量则面向整个测试窗口,统计总输出 token 数除以总墙钟时间。
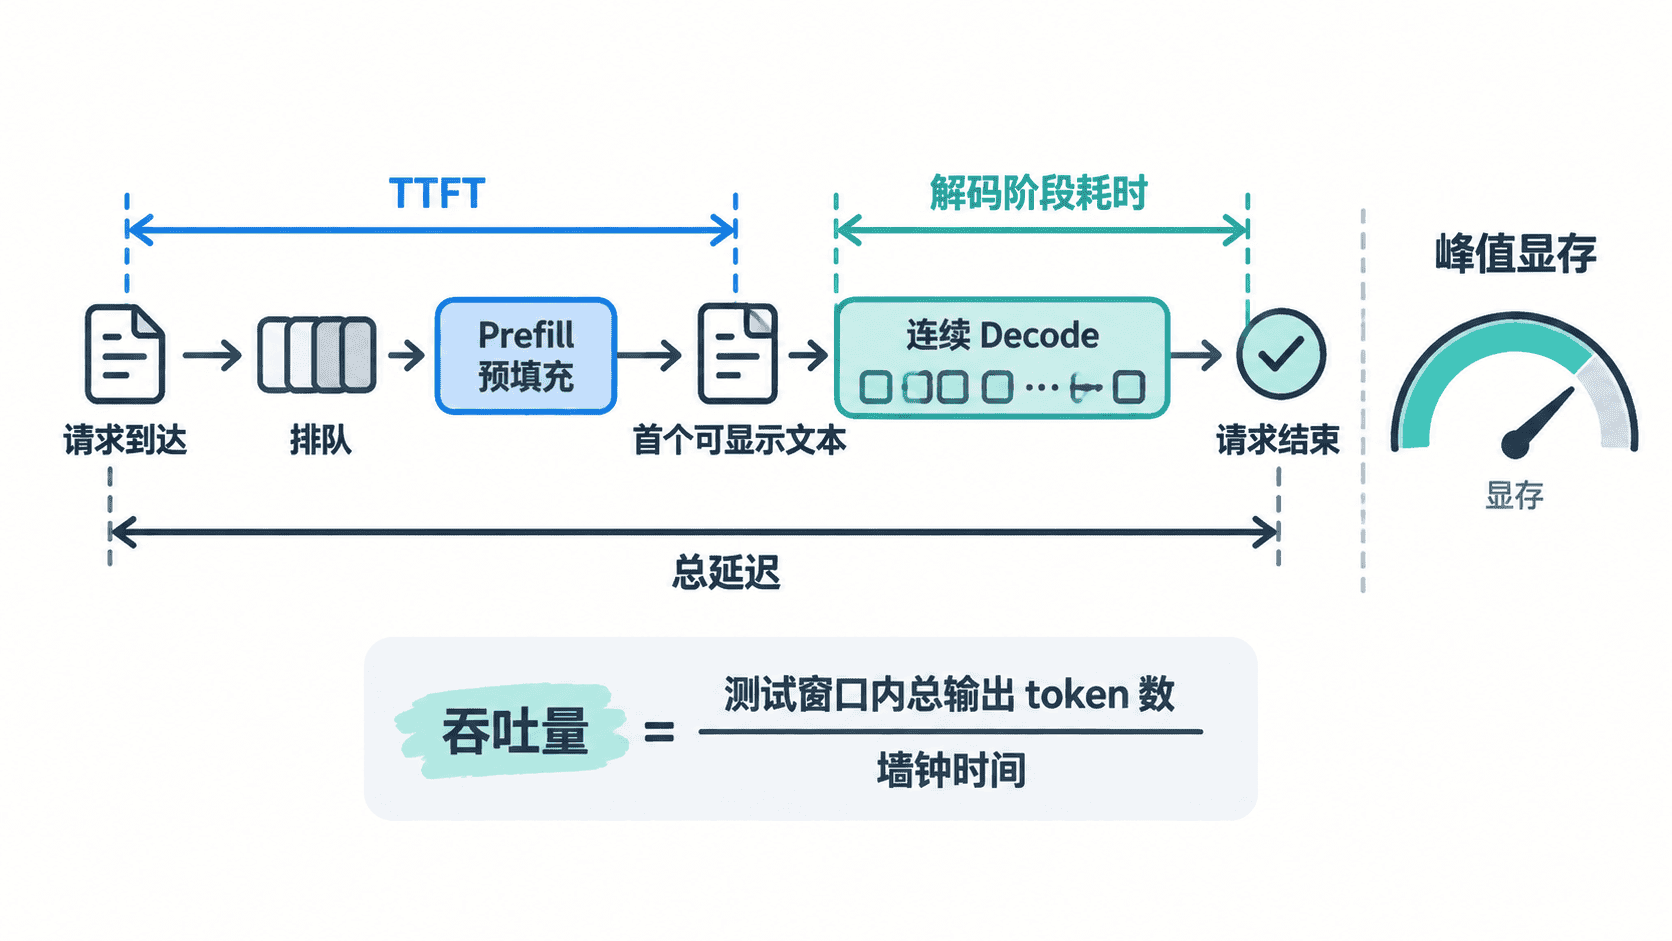
显存指标应区分“当前占用”和“峰值占用”。模型加载后已有基础占用,压测期间的峰值还会包含激活、KV Cache、临时张量与批处理开销,因此必须在模型完成预热后重置峰值统计。
固定测试条件
性能数字只有在测试条件一致时才可比较。至少固定模型版本、设备、数据类型、输入长度、输出长度、批大小和生成策略;关闭随机采样可以减少波动,预热则用于排除首次加载算子、缓存和内核初始化的影响。
同一组配置建议重复运行至少 5 次,并报告中位数或 P95,而不是只记录最快一次。GPU 测量前后还要调用同步操作,否则 CPU 计时可能早于异步 CUDA 计算结束,得到偏小的延迟。
实现本地基准脚本
先安装依赖。示例继续使用 distilgpt2,在有 CUDA 时自动使用 GPU,否则在 CPU 上运行。
python -m pip install torch transformers预期输出
Successfully installed <PACKAGES>将下面代码保存为 benchmark.py。脚本先预热模型,再重复测量单请求 TTFT 与解码速度,并测试批大小为 1、2、4 时的持续 token 吞吐量和峰值显存。
import json
import threading
import time
from statistics import median

import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    TextIteratorStreamer,
)

MODEL_NAME = "distilgpt2"
DEVICE = "cuda" if torch.cuda.is_available() else "cpu"
PROMPT = "Transformer inference performance depends on"
MAX_NEW_TOKENS = 32
REPEATS = 5

def sync_device() -> None:
    if DEVICE == "cuda":
        torch.cuda.synchronize()

def peak_memory_mb() -> float:
    if DEVICE != "cuda":
        return 0.0
    return torch.cuda.max_memory_allocated() / 1024**2

def reset_peak_memory() -> None:
    if DEVICE == "cuda":
        torch.cuda.reset_peak_memory_stats()

def measure_single(model, tokenizer) -> dict[str, float]:
    inputs = tokenizer(PROMPT, return_tensors="pt").to(DEVICE)
    streamer = TextIteratorStreamer(
        tokenizer,
        skip_prompt=True,
        skip_special_tokens=True,
    )
    result: dict[str, torch.Tensor] = {}

    def worker() -> None:
        with torch.inference_mode():
            result["output_ids"] = model.generate(
                **inputs,
                max_new_tokens=MAX_NEW_TOKENS,
                min_new_tokens=MAX_NEW_TOKENS,
                do_sample=False,
                pad_token_id=tokenizer.pad_token_id,
                streamer=streamer,
            )

    reset_peak_memory()
    sync_device()
    started_at = time.perf_counter()
    thread = threading.Thread(target=worker)
    thread.start()

    first_piece_at = None
    for piece in streamer:
        # Streamer 产生首个非空片段时,记录用户可见首包时间。
        if piece and first_piece_at is None:
            first_piece_at = time.perf_counter()

    thread.join()
    sync_device()
    finished_at = time.perf_counter()

    output_ids = result["output_ids"]
    input_tokens = inputs["input_ids"].shape[1]
    generated_tokens = output_ids.shape[1] - input_tokens
    first_piece_at = first_piece_at or finished_at

    decode_seconds = max(finished_at - first_piece_at, 1e-9)
    decode_tokens = max(generated_tokens - 1, 0)

    return {
        "ttft_ms": (first_piece_at - started_at) * 1000,
        "decode_tokens_per_second": decode_tokens / decode_seconds,
        "peak_allocated_mb": peak_memory_mb(),
    }

def measure_batch(model, tokenizer, batch_size: int) -> dict[str, float]:
    prompts = [PROMPT] * batch_size
    inputs = tokenizer(
        prompts,
        return_tensors="pt",
        padding=True,
        truncation=True,
        max_length=512,
    ).to(DEVICE)

    reset_peak_memory()
    sync_device()
    started_at = time.perf_counter()
    with torch.inference_mode():
        output_ids = model.generate(
            **inputs,
            max_new_tokens=MAX_NEW_TOKENS,
            min_new_tokens=MAX_NEW_TOKENS,
            do_sample=False,
            pad_token_id=tokenizer.pad_token_id,
        )
    sync_device()
    elapsed = time.perf_counter() - started_at

    generated_per_sequence = (
        output_ids.shape[1] - inputs["input_ids"].shape[1]
    )
    total_generated = output_ids.shape[0] * generated_per_sequence

    return {
        "throughput_tokens_per_second": total_generated / elapsed,
        "peak_allocated_mb": peak_memory_mb(),
    }

def main() -> None:
    tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
    tokenizer.padding_side = "left"
    if tokenizer.pad_token_id is None:
        tokenizer.pad_token = tokenizer.eos_token

    model = AutoModelForCausalLM.from_pretrained(MODEL_NAME)
    model.to(DEVICE)
    model.eval()

    # 预热不计入正式结果,避免首次执行开销污染数据。
    warmup = tokenizer("warmup", return_tensors="pt").to(DEVICE)
    with torch.inference_mode():
        model.generate(
            **warmup,
            max_new_tokens=8,
            do_sample=False,
            pad_token_id=tokenizer.pad_token_id,
        )
    sync_device()

    single_runs = [
        measure_single(model, tokenizer) for _ in range(REPEATS)
    ]

    batch_results = []
    for batch_size in (1, 2, 4):
        runs = [
            measure_batch(model, tokenizer, batch_size)
            for _ in range(REPEATS)
        ]
        batch_results.append(
            {
                "batch_size": batch_size,
                "throughput_tokens_per_second_p50": round(
                    median(
                        run["throughput_tokens_per_second"]
                        for run in runs
                    ),
                    2,
                ),
                "peak_allocated_mb_max": round(
                    max(run["peak_allocated_mb"] for run in runs),
                    2,
                ),
            }
        )

    report = {
        "model": MODEL_NAME,
        "device": DEVICE,
        "single_request": {
            "ttft_ms_p50": round(
                median(run["ttft_ms"] for run in single_runs),
                2,
            ),
            "decode_tokens_per_second_p50": round(
                median(
                    run["decode_tokens_per_second"]
                    for run in single_runs
                ),
                2,
            ),
            "peak_allocated_mb_max": round(
                max(run["peak_allocated_mb"] for run in single_runs),
                2,
            ),
        },
        "batch_results": batch_results,
    }
    print(json.dumps(report, indent=2))

if __name__ == "__main__":
    main()
预期结果
脚本输出一个 JSON 报告,包含 model、device、single_request 和 batch_results;具体延迟、吞吐量与显存数值取决于实际硬件和运行环境。运行基准测试。首次执行还会下载模型文件,正式比较时应在模型已缓存后重新运行。
python benchmark.py预期输出
{
  "model": "distilgpt2",
  "device": "<cpu|cuda>",
  "single_request": {
    "ttft_ms_p50": <TTFT_MS>,
    "decode_tokens_per_second_p50": <DECODE_TPS>,
    "peak_allocated_mb_max": <PEAK_MB>
  },
  "batch_results": [
    {
      "batch_size": 1,
      "throughput_tokens_per_second_p50": <THROUGHPUT_TPS>,
      "peak_allocated_mb_max": <PEAK_MB>
    }
  ]
}
解读指标组合
TTFT 高而解码速度正常,通常说明输入较长、预填充计算重、请求排队或服务层开销较大。TTFT 正常但解码速度低,更可能是显存带宽、量化实现、设备性能或单 token 调度效率限制。
批大小增加后吞吐量上升而单请求延迟变差,属于常见权衡;若吞吐量几乎不升但显存快速增长,说明当前模型、精度或执行后端没有从批处理获益。峰值显存接近设备上限时,还要留出框架缓存和突发请求余量,不能把压测峰值直接当作安全容量。
TextIteratorStreamer 记录的是首个非空可显示片段,而不是底层严格意义上的单 token 完成时刻。这个口径更接近用户看到首字的体验;比较不同实现时必须保持同一 streamer 和解码策略。
形成可复现的压测结论
最终报告应同时写明硬件型号、驱动与框架版本、模型提交版本、精度、输入 token 数、输出 token 数、批大小、并发度、预热次数和重复次数。缺少这些条件,单独给出“每秒多少 token”没有可比性。
模型侧基准用于判断计算上限,服务上线前还应在 HTTP 层补测排队时间、序列化开销、P50/P95/P99 延迟、错误率和请求吞吐量。两层数据相减,才能区分模型瓶颈与服务框架瓶颈。
本课总结
- TTFT、解码速度、吞吐量和峰值显存描述的是不同阶段,不能相互替代
- 压测必须固定输入输出长度、批大小、精度与生成策略,并经过预热和重复运行
- 指标要组合解读:延迟定位交互瓶颈,吞吐量评估容量,显存峰值决定安全并发边界
下一课预告
下一课将把接口与压测结果用于部署决策,进一步讨论批处理、量化、缓存和多实例扩缩容等工程优化方法。