
大模型原理与训练 / 系统课时
训练与推理差异
训练与推理差异
训练和推理使用同一套解码器参数,却采用完全不同的输入组织方式。本课会把教师强制、因果掩码、并行训练与逐词生成串成一条完整流程,帮助你准确判断两阶段的计算边界和常见误区。
学习目标
- 说明教师强制如何构造解码器输入与监督标签
- 区分训练阶段的序列并行和推理阶段的时间步串行
- 理解训练推理不一致带来的暴露偏差及缓解思路
两个阶段解决的问题不同
训练阶段已经拥有完整目标序列,任务是让模型在每个位置预测下一个词;推理阶段没有标准答案,只能把刚生成的词重新送回解码器,继续预测后续内容。两者共享参数,但可用信息不同。
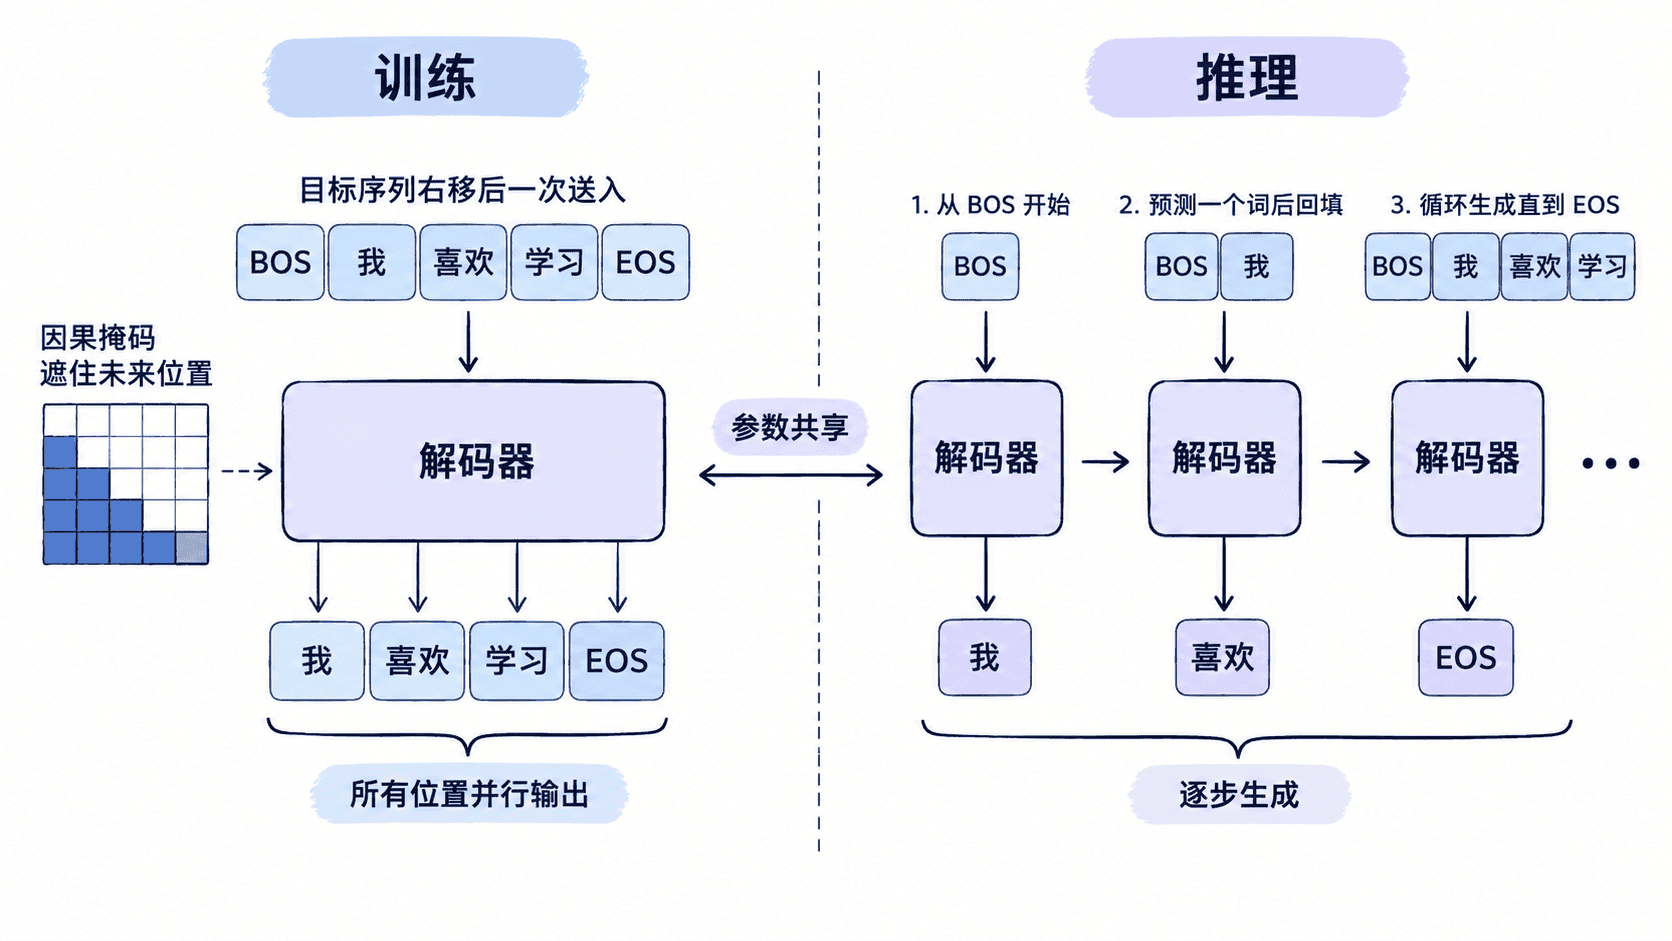
训练阶段:教师强制与并行计算
假设目标文本是 I like AI <EOS>。训练时先在开头加入 <BOS>,再把序列错开一位:
| 用途 | 序列 |
|---|---|
| 解码器输入 | <BOS> I like AI |
| 监督标签 | I like AI <EOS> |
这种把真实前缀交给模型的方式称为教师强制。虽然完整输入一次进入解码器,但因果掩码会阻止位置访问右侧词,因此每个位置只能依据合法前缀进行预测。各位置的注意力可以同时计算,所以训练能充分利用 GPU 并行能力。
推理阶段:把预测结果作为下一步输入
推理从 <BOS> 开始。模型先预测第一个词,再将该词追加到当前序列,重复前向计算,直到生成 <EOS>、达到最大长度或触发其他停止条件。
时间步之间存在真实依赖:第 3 个词必须等待第 2 个词产生,因此单条序列无法像训练那样一次得到全部结果。KV Cache 可以复用历史注意力中的键和值,减少重复计算,但不能消除逐步生成的依赖关系。
为什么会出现暴露偏差
训练时,模型看到的历史词通常来自真实答案;推理时,历史词来自模型自身。一旦某一步预测错误,后续步骤仍要基于这个错误继续生成,偏差可能逐渐累积,这就是暴露偏差。
常见缓解方式包括计划采样、标签平滑、序列级训练以及更高质量的数据与解码策略。不过在标准 Transformer 训练中,教师强制仍是主流,因为它稳定、易并行且计算效率高。
三个容易混淆的结论
教师强制不等于偷看未来。是否泄漏未来由因果掩码决定,而不是由目标序列是否完整提供决定。
并行训练也不表示词之间没有依赖。依赖关系由掩码后的注意力建模,只是多个位置的矩阵运算可以同时执行。
推理可以批量处理多条序列,但每条序列内部的时间步仍然要按顺序推进。不同样本生成长度不一致时,还要处理已结束样本的掩码与提前停止。
本课总结
- 训练通过目标序列右移和教师强制,同时计算所有位置的下一词预测
- 推理必须把模型输出回填为下一步输入,因此时间步天然串行
- 因果掩码防止未来信息泄漏,训练推理输入差异则可能带来暴露偏差
下一课预告
下一课将把编码器、解码器和交叉注意力连接起来,构建一个可用于翻译与摘要任务的完整序列到序列模型。