
大模型原理与训练 / 系统课时
Auto 类加载模型
Auto 类加载模型
面对 BERT、RoBERTa、DistilBERT 等不同架构,手动选择具体类容易写错。Auto 类会读取仓库配置并自动映射到合适实现,本课将完成一次文本分类加载、推理和结果验证。
学习目标
- 理解 Auto 类依据配置选择具体实现的机制
- 能为基础特征、分类和生成任务选择正确的 AutoModel 接口
- 完成分词、模型推理与标签解析
Auto 类解决什么问题
AutoTokenizer 和 AutoModel 不是实际的网络架构,而是工厂接口。它们先读取仓库中的配置,再根据 model_type 或架构映射表实例化具体类。
例如,同一段加载代码可以处理 BERT 或 DistilBERT,而不必把类名写死。这样更适合根据模型 ID 切换模型,也能减少“分词器与模型架构不匹配”的问题。
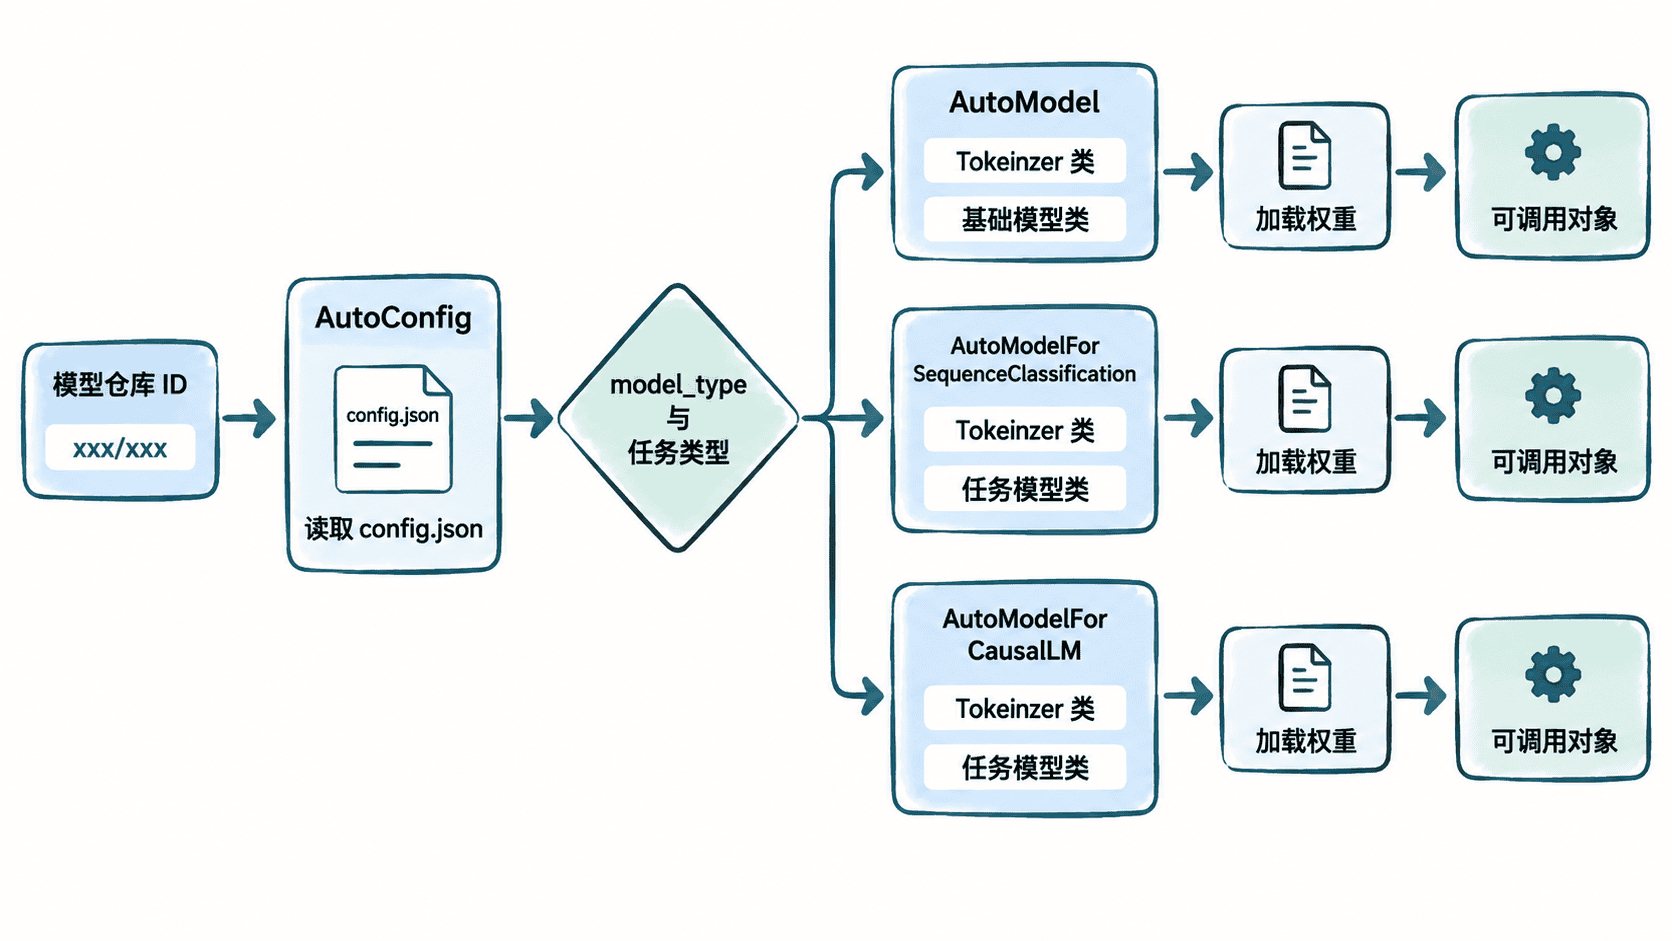
选择正确的 AutoModel 接口
只需要隐藏状态或句向量时,使用 AutoModel。它返回基础网络输出,不会直接给出分类标签或生成文本。
有明确任务时,应选择带任务头的接口。文本分类使用 AutoModelForSequenceClassification,抽取式问答使用 AutoModelForQuestionAnswering,因果语言模型生成使用 AutoModelForCausalLM。接口选错时,常见表现是输出字段不符合预期,或加载任务头时出现权重不匹配。
完成一次文本分类推理
运行前需要安装 transformers 与 torch,并确保首次运行时可以访问模型仓库。下面示例加载一个已经完成情感分类微调的 DistilBERT 模型,对英文句子进行分类。
import torch
from transformers import (
    AutoModelForSequenceClassification,
    AutoTokenizer,
)

model_id = "distilbert/distilbert-base-uncased-finetuned-sst-2-english"

tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForSequenceClassification.from_pretrained(model_id)
model.eval()

text = "This course is clear and practical."
inputs = tokenizer(text, return_tensors="pt", truncation=True)

with torch.inference_mode():
    outputs = model(**inputs)
    predicted_id = int(outputs.logits.argmax(dim=-1).item())

label = model.config.id2label[predicted_id]

print(f"tokenizer={tokenizer.__class__.__name__}")
print(f"model={model.__class__.__name__}")
print(f"label={label}")
预期输出
tokenizer=DistilBertTokenizerFast
model=DistilBertForSequenceClassification
label=POSITIVE
首次运行会下载配置、分词器和权重,耗时取决于网络与缓存状态;后续运行通常直接复用本地缓存。不同 transformers 版本可能显示等价的快速分词器类名,但预测标签应为 POSITIVE。
从加载到输出发生了什么
AutoTokenizer.from_pretrained() 读取分词器配置与词表,把文本转换成 input_ids 和 attention_mask。AutoModelForSequenceClassification.from_pretrained() 读取模型配置,创建 DistilBERT 分类模型,再加载对应权重。
推理时,model(**inputs) 返回包含 logits 的结果对象。argmax 选出分数最高的类别编号,最后通过 model.config.id2label 转换为可读标签。不要把类别编号直接写死,因为不同模型的标签映射可能不同。
关键边界与排查
模型和分词器应使用同一个 model_id 与版本。若分别加载不同仓库,可能出现词表不一致、特殊标记缺失或输入尺寸异常。
只做推理时应调用 model.eval(),并使用 torch.inference_mode() 关闭梯度记录。对于生成模型,还要确认使用的是 AutoModelForCausalLM 或与架构匹配的生成接口,而不是基础 AutoModel。
离线环境需要提前缓存全部文件,并在加载时指定本地目录。若提示无法连接仓库,先确认文件是否完整,再检查代码是否误把远程模型 ID 当成本地路径。
本课总结
- Auto 类根据仓库配置自动选择具体的分词器和模型实现
- 基础特征提取使用
AutoModel,具体任务应选择对应的AutoModelFor...接口 - 分词器、模型、版本和标签映射必须保持一致,推理时还要关闭训练行为与梯度记录
下一课预告
下一课将进一步处理批量输入、填充与截断,并把模型输出转换成可复用的推理函数。