
大模型原理与训练 / 系统课时
Transformer 的核心思路
Transformer 的核心思路
Transformer 要解决的核心问题,是让模型在处理序列时既能直接关注远距离信息,又能充分利用并行计算。本课从全局依赖、并行计算和注意力机制三个角度,建立对其设计思想的整体认识。
学习目标
- 说明 Transformer 为什么不依赖逐步递归计算
- 理解自注意力如何建立任意位置之间的联系
- 解释全局依赖、并行计算与多头注意力如何协同
问题:顺序计算限制了效率与依赖范围
传统循环网络通常按照词序逐步更新隐藏状态,第 个位置必须等待第 个位置完成。这样的结构天然适合表达顺序,但训练阶段难以把整个序列同时送入同一层计算,长距离信息还要经过多次状态传递。
Transformer 改变了这个思路:不再让信息沿时间步逐个传递,而是让序列中的所有位置在同一层直接交换信息。于是,“谁与谁相关”不再由传播距离决定,而由注意力权重决定。
全局依赖:自注意力直接连接任意位置
自注意力会把每个位置映射为查询 、键 和值 。查询与所有键计算相似度,再用归一化后的权重汇总对应的值:
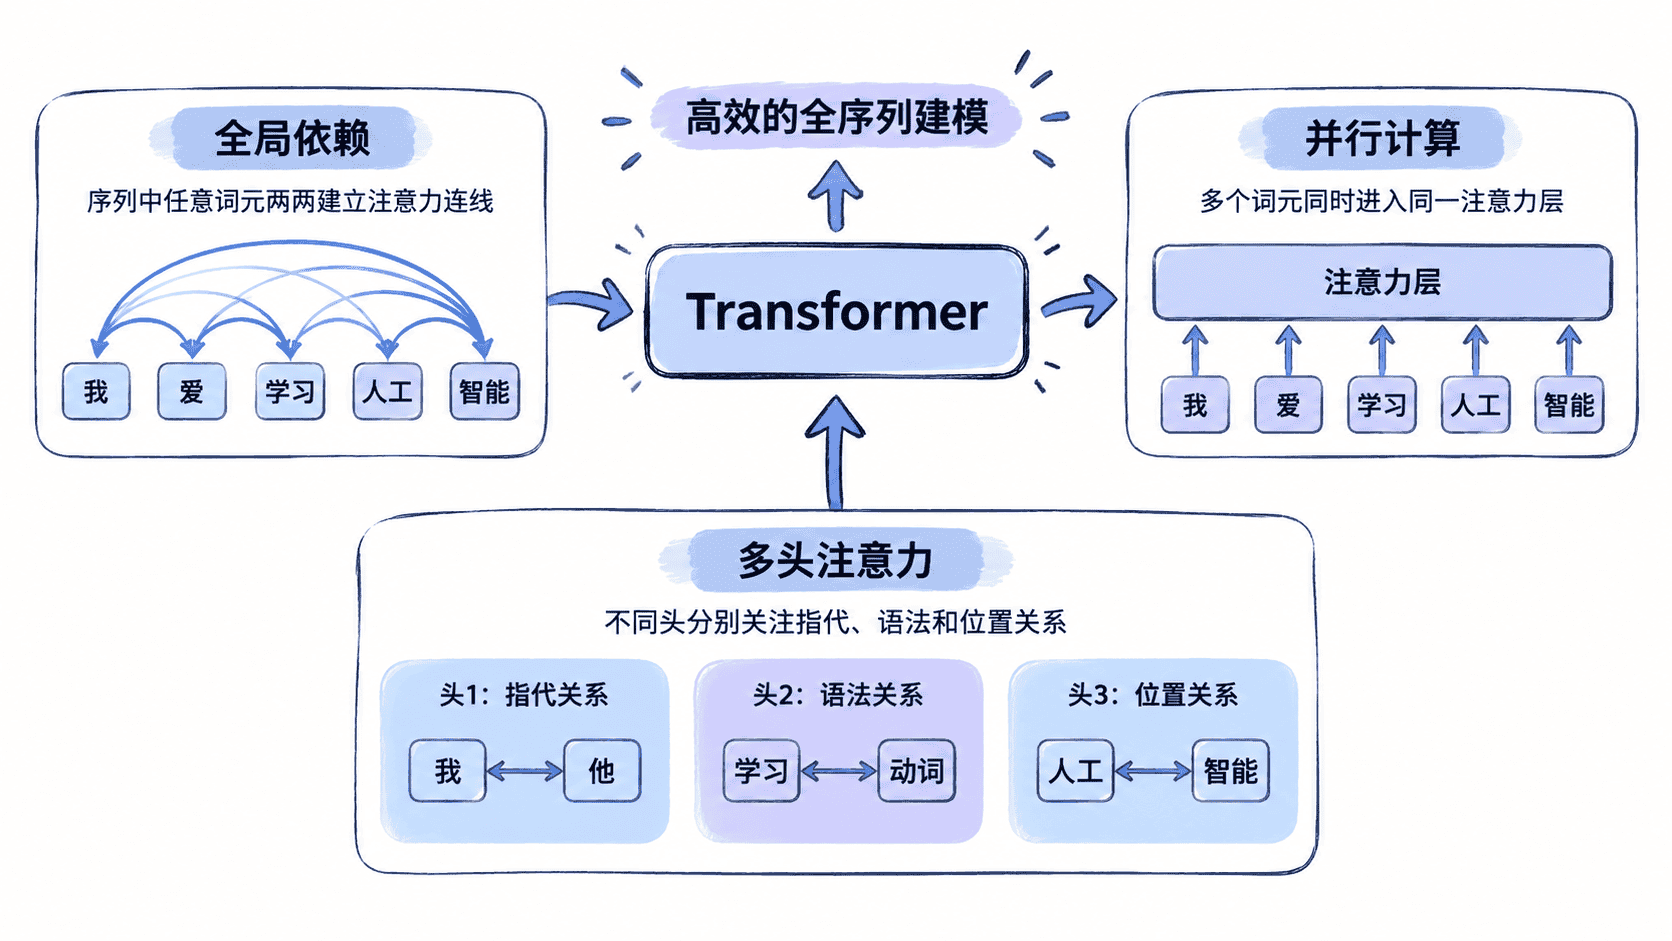
因此,一个词可以在单层中直接关注句首、句尾或中间任意位置。多头注意力还会把表示拆分到多个子空间,使不同头分别学习指代、语法、位置或主题等关系,而不是只形成一组单一权重。
并行计算:一次处理完整序列
自注意力不要求第一个位置先算完、第二个位置再开始。训练时,同一层可以同时计算全部位置的查询、键和值,再通过矩阵运算得到注意力结果。这种结构更适合 GPU 等并行硬件,也能显著缩短深层模型的训练链路。
并行计算也带来一个新问题:模型本身不再天然知道词的先后顺序。因此,输入表示通常要加入位置编码,让模型区分“猫追狗”和“狗追猫”这类词相同但顺序不同的序列。
三个核心思路如何协同
全局依赖解决“远处信息能否直接访问”,注意力机制解决“应该关注谁以及关注多少”,并行计算解决“能否高效完成整层运算”。三者组合后,Transformer 可以在一次层计算中完成全序列的信息交互。
这种设计并非没有代价。标准自注意力需要计算长度为 的序列中所有位置对,时间和显存开销通常随 增长,因此超长文本需要稀疏注意力、分块或压缩等进一步优化。
本课总结
- 自注意力让任意位置能够在单层中直接交换信息
- Transformer 去除逐步递归依赖,使序列训练可以高度并行
- 多头注意力和位置编码分别补充多种关系建模与顺序信息
下一课预告
下一课将把这些核心思路放入具体结构中,比较编码器、解码器和编码器—解码器三类架构的组成方式与适用任务。