
大模型原理与训练 / 系统课时
可学习位置嵌入
可学习位置嵌入
可学习位置嵌入用一张可训练参数表为每个序列位置分配向量,再与词元嵌入相加。本文会完成一个可运行的 PyTorch 实现,并说明它为何存在最大长度限制、怎样验证越界,以及何时适合采用这种方案。
学习目标
- 理解可学习位置嵌入的参数结构与相加方式
- 使用 PyTorch 实现位置查表、广播相加和长度检查
- 判断固定长度、扩展长度与训练数据之间的取舍
它解决什么问题
自注意力会根据内容计算词元之间的关系,但单独的注意力计算不会自动区分“第一个词”和“最后一个词”。因此,模型需要把位置信息注入输入表示,让相同词元出现在不同位置时得到不同表示。
可学习位置嵌入直接维护一个形状为 的参数矩阵,其中 是支持的最大序列长度, 是模型维度。长度为 的输入只取前 行,并与词元嵌入逐位置相加:
这里的 会参与反向传播,因此模型可以根据任务数据自行学习哪些位置差异最重要。
参数表如何参与前向计算
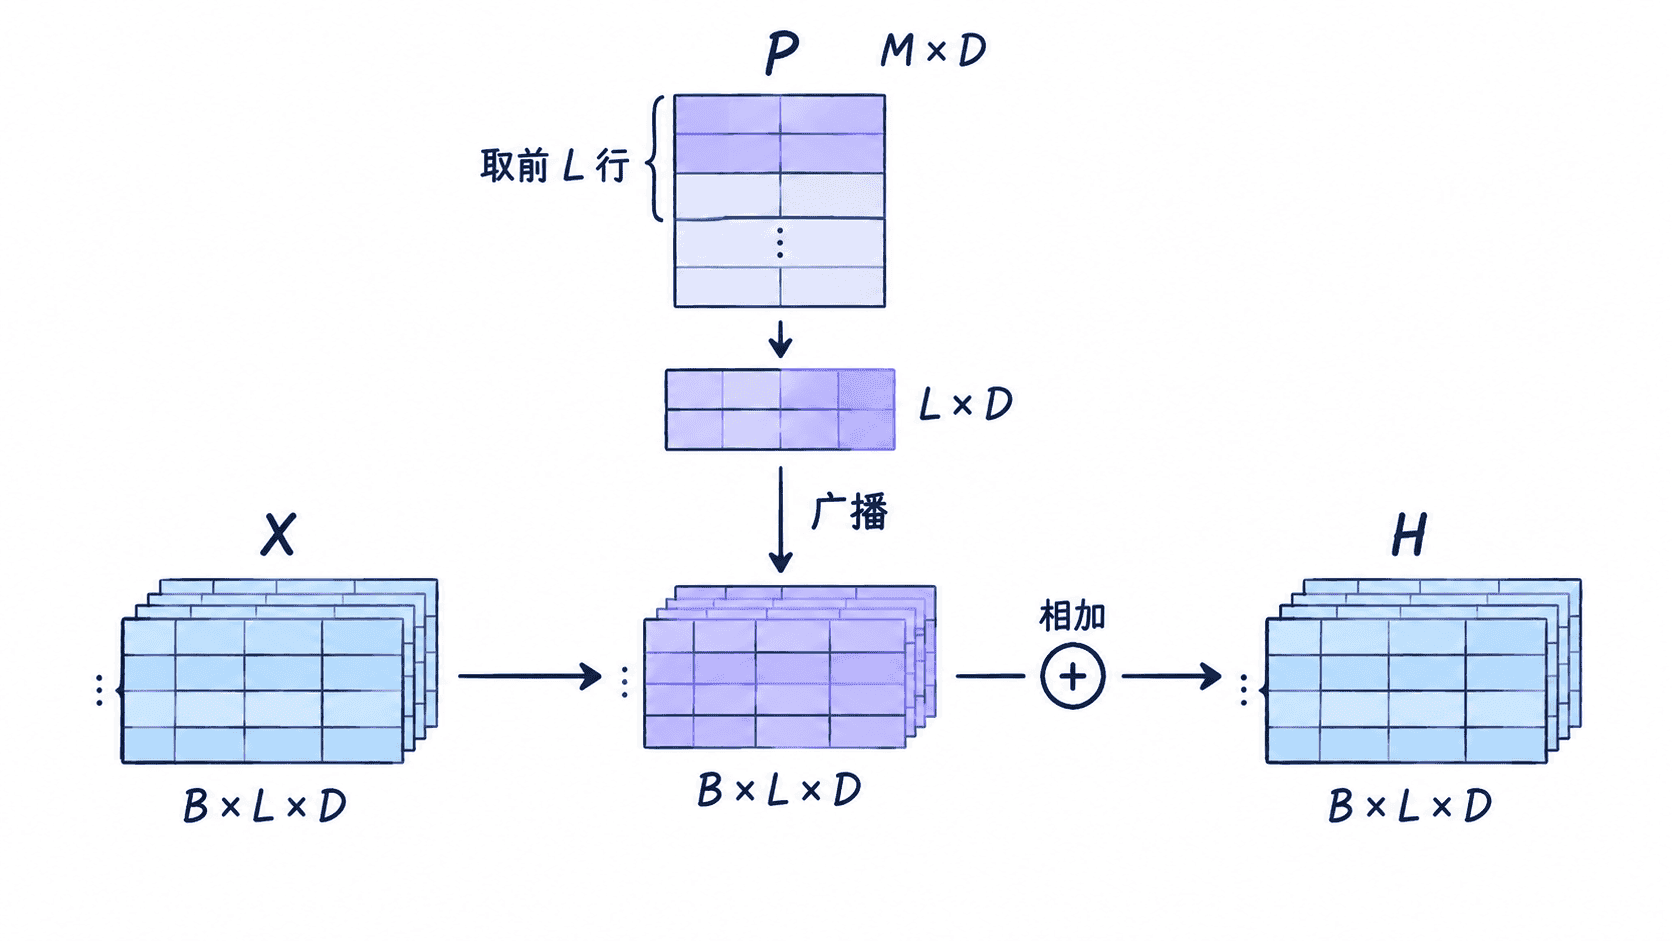
同一批样本共享位置编号,所以位置张量通常先生成形状为 L 的索引,再查表得到 L × D,最后在批次维上自动广播。位置索引表示序列槽位,而不是词元编号;即使两个位置上的词相同,它们取到的位置向量也不同。
PyTorch 实现与长度检查
下面的模块接收形状为 B × L × D 的词元嵌入。它在前向传播时主动检查长度,避免底层查表抛出难以定位的索引错误。
import torch
from torch import nn

class LearnablePositionalEmbedding(nn.Module):
    def __init__(self, max_length: int, d_model: int) -> None:
        super().__init__()
        self.max_length = max_length
        self.position_embedding = nn.Embedding(max_length, d_model)

    def forward(self, token_embeddings: torch.Tensor) -> torch.Tensor:
        if token_embeddings.ndim != 3:
            raise ValueError("输入必须是 [batch, length, d_model]")

        batch_size, length, d_model = token_embeddings.shape
        if d_model != self.position_embedding.embedding_dim:
            raise ValueError("输入维度与位置嵌入维度不一致")
        if length > self.max_length:
            raise ValueError(
                f"序列长度 {length} 超过最大长度 {self.max_length}"
            )

        # 所有样本共享 0 到 length - 1 的位置编号
        position_ids = torch.arange(
            length, device=token_embeddings.device
        )
        position_vectors = self.position_embedding(position_ids)

        # [length, d_model] 会沿 batch 维自动广播
        return token_embeddings + position_vectors

torch.manual_seed(7)
module = LearnablePositionalEmbedding(max_length=8, d_model=4)
inputs = torch.randn(2, 5, 4)
outputs = module(inputs)

print("output shape:", tuple(outputs.shape))

try:
    module(torch.randn(2, 9, 4))
except ValueError as exc:
    print(type(exc).__name__ + ":", exc)
预期输出:
output shape: (2, 5, 4)
ValueError: 序列长度 9 超过最大长度 8实际训练时,position_embedding.weight 会与其他模型参数一起被优化。若输入包含填充位置,通常仍可完成位置相加,再由注意力掩码阻止有效词元关注填充键;如果后续模块要求填充位置严格为零,还需要在相加后额外乘以有效位置掩码。
最大长度为何不能自然外推
参数表只有 0 到 M-1 这些已定义行,超过 的位置没有可查向量。直接扩大 nn.Embedding 虽然能增加行数,但新增行没有经过原训练过程,不能视为模型已经学会更长序列。
迁移已有模型时,可以复制旧权重并随机初始化新增位置,或对位置表做插值后继续训练。两种做法都需要在目标长度上重新验证效果,不能只凭张量形状正确就认定扩展成功。
适用场景与选择建议
可学习位置嵌入适合最大长度明确、训练与推理长度接近、并且有足够数据学习位置规律的任务。它实现简单,也允许模型形成任务相关的位置偏好。
如果系统必须处理远超训练长度的输入,固定大小的绝对位置表会成为明显限制。此时应优先考虑具有长度外推设计的位置方案,而不是在上线阶段临时扩大参数表。
本课总结
- 可学习位置嵌入本质上是一个形状为
最大长度 × 模型维度的可训练查找表 - 前向计算只取当前序列所需的位置向量,并沿批次维广播后与词元嵌入相加
- 扩大参数表只能解决索引范围,不能自动获得长序列上的有效位置能力
下一课预告
下一课将把查询、键和值投影、分头计算、掩码广播和输出合并整合为一个完整的多头注意力模块。