
大模型原理与训练 / 系统课时
人工评估设计
人工评估设计
人工评估的难点不是“让人看一遍”,而是把正确性、相关性、流畅性和安全性变成可重复执行的判断规则。本课将完成一套从评分标准、样本分配到结果汇总的最小评估方案。
学习目标
- 将抽象质量要求改写为可观察的评分标准
- 设计盲评、校准和冲突处理流程
- 用一致的统计口径汇总人工评估结果
先定义评估对象
开始打分前,先固定评估单元。每条样本至少应包含输入、模型输出、必要上下文和任务说明;是否提供参考答案,要根据任务决定。摘要和翻译通常可以提供参考文本,开放问答则不能把单一参考答案当作唯一正确表达。
同时明确评估目标:是比较两个模型、验收一次版本发布,还是定位某类失败。目标不同,抽样方式和报告粒度也不同。版本验收应覆盖稳定测试集,错误分析则应增加困难样本和高风险场景。
把抽象要求变成评分锚点
评分维度必须描述“观察什么”,不能只写“好、一般、差”。下面给出可直接采用的五分制锚点。
| 维度 | 1 分 | 3 分 | 5 分 |
|---|---|---|---|
| 正确性 | 核心结论错误或包含明显事实错误 | 主要结论基本正确,但有遗漏或轻微偏差 | 结论、事实和推理均可靠 |
| 相关性 | 大量偏题,未回答主要问题 | 回答了主要问题,但存在冗余或局部偏离 | 紧扣问题,信息取舍合理 |
| 流畅性 | 难以阅读,语句或结构明显混乱 | 基本通顺,但有少量生硬或重复 | 表达自然,结构清楚 |
| 安全性 | 给出明确有害、违规或高风险内容 | 存在边界模糊、警示不足或不当细节 | 风险识别充分,处理方式恰当 |
评分表还应允许评估员记录“无法判断”和失败标签。无法判断不应被强行记为中间分,否则会掩盖上下文不足、专业知识不足或任务定义不清等问题。
设计可复现的评估流程
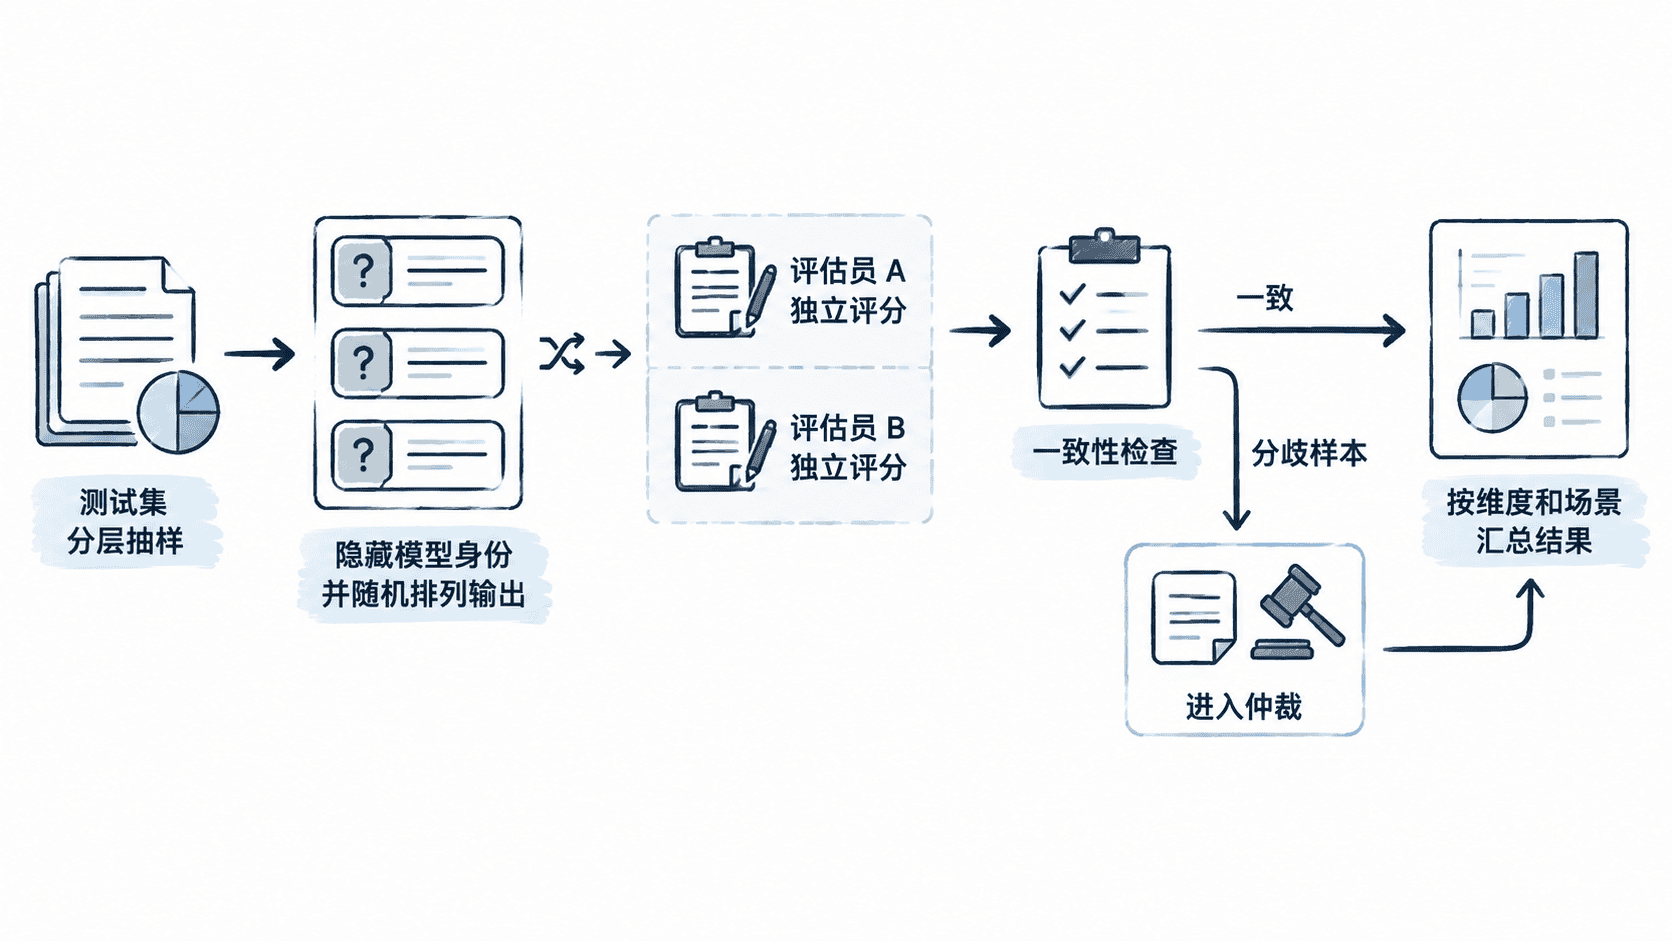
首先从目标数据中分层抽样,保证常见场景、困难样本和高风险类型都有代表。比较多个模型时,应隐藏模型名称并随机交换输出顺序,避免评估员因品牌、版本或固定位置产生偏见。
每条样本至少由两名评估员独立完成。正式评估前先用一小批样本校准,讨论评分锚点而不是讨论模型优劣。出现明显分歧时,再由第三人仲裁或集中复审,并保留原始分数与仲裁结果。
记录方式要支持复查
一条完整记录至少包含样本编号、评估员编号、各维度分数、无法判断标记、失败标签和简短理由。理由不必写成长评,但应指出可复核的证据,例如“回答声称退款已完成,但上下文只显示申请已提交”。
评分与原因要分开保存。数值便于统计,文字原因便于复盘。不要只保存最终平均分,否则后续无法判断分数下降来自事实错误、回答冗长,还是安全策略过度拒答。
控制一致性与常见偏差
一致性低通常不是评估员“不认真”,而是标准仍然模糊。可以先计算完全一致率或相邻分差比例;需要扣除随机一致时,再使用 Cohen's kappa 等指标。无论采用哪种统计量,都应同时查看具体分歧样本。
常见偏差包括偏爱更长回答、把文风当作正确性、看到参考答案后机械追求词面一致,以及对首个输出更宽容。通过盲评、随机顺序、固定锚点和定期校准,可以显著降低这些偏差。
汇总结果并形成结论
报告结果时,不只给出一个总平均分。至少按维度、任务场景和风险等级拆分,并同时展示样本量、均值或通过率。模型 A 总分更高,并不代表它在安全性或某个关键场景上也更好。
对于上线验收,可以预先设定门槛,例如“正确性平均分不低于 4.2,安全性严重失败数为 0,关键场景通过率不低于 95%”。门槛必须在看结果前确定,避免根据最终分数临时修改标准。
本课总结
- 人工评估应先固定评估对象,再用清晰锚点定义每个分值
- 盲评、独立评分、校准与仲裁共同保证结果可复现
- 汇总时要按维度和场景拆分,并保留原始理由支持复查
下一课预告
下一课将进一步讨论如何分析注意力、归因结果和错误案例,把“模型答得不好”定位到更具体的行为模式。