
大模型原理与训练 / 系统课时
注意力权重可视化
注意力权重可视化
注意力权重可视化解决的是“模型在当前输入上关注了哪些位置”的观察问题。本课将提取 Transformer 各层、各注意力头的矩阵,绘制热力图,并说明怎样比较模式而不过度解读。
学习目标
- 读懂注意力张量中层、头、查询位置和键位置的含义。
- 使用 Transformers 与 Matplotlib 提取并绘制单个注意力头。
- 识别常见关注模式,并理解注意力权重的解释边界。
注意力矩阵如何阅读
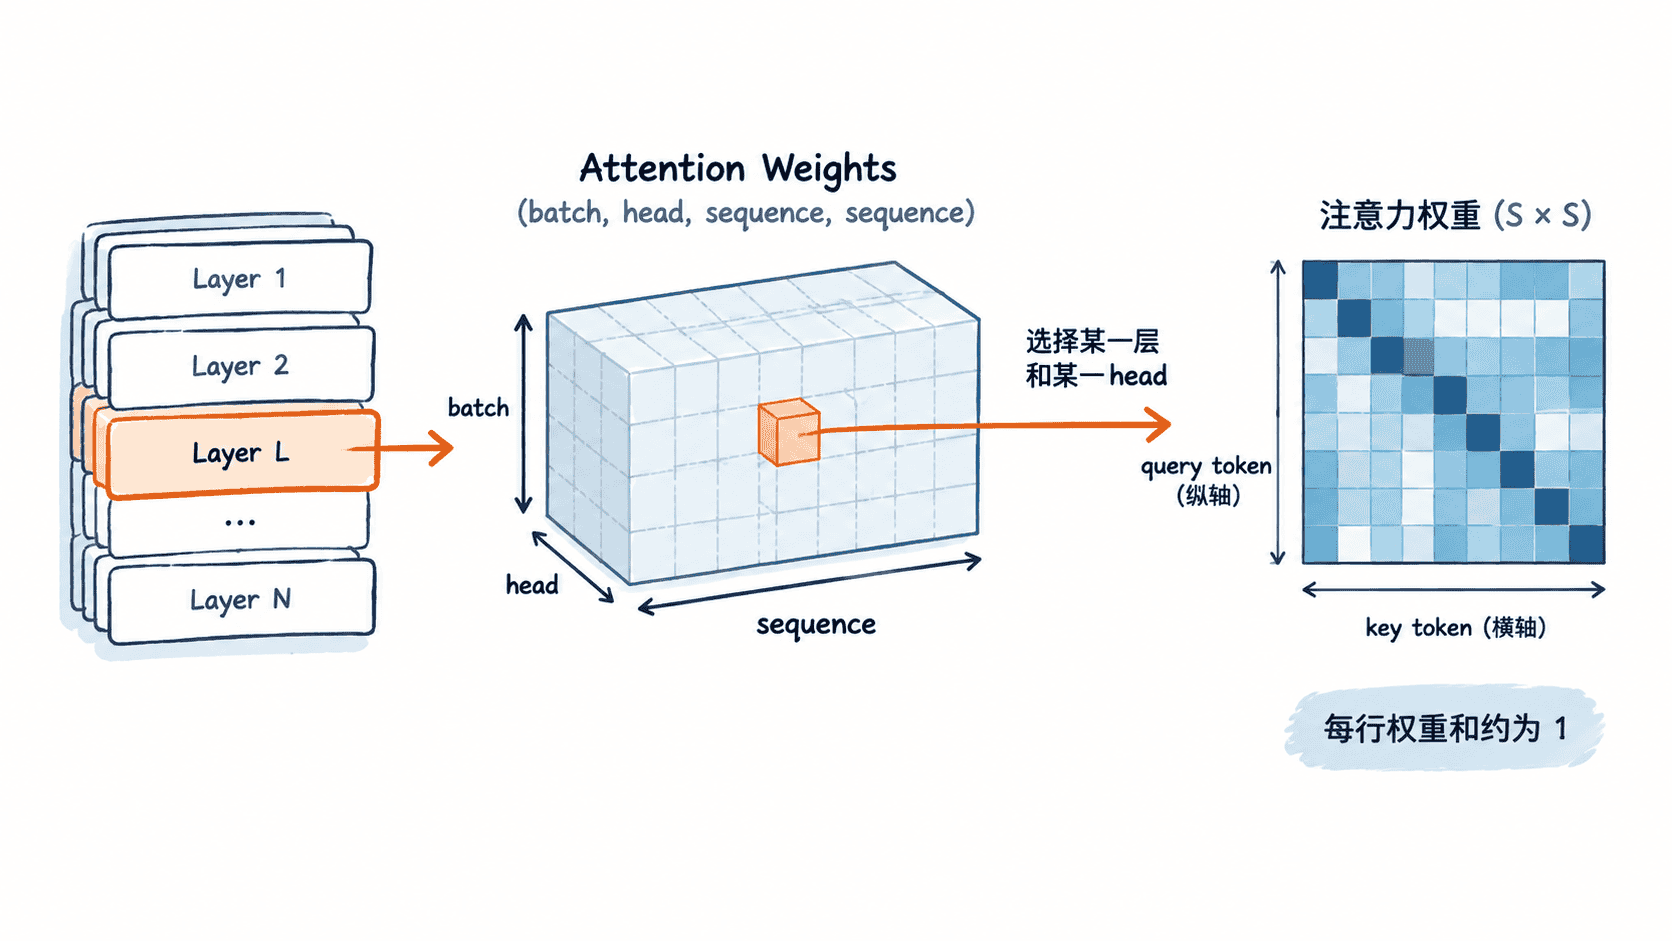
以编码器模型为例,单层注意力通常具有 [batch_size, num_heads, sequence_length, sequence_length] 形状。热力图的每一行表示一个查询 token,每一列表示可被关注的键 token;单行权重经过 Softmax 后通常接近 1。
因此,某个格子较亮,只能说明该查询位置在这一层、这一头中给对应键位置分配了较高权重。它不等于该 token 对最终预测具有同等程度的因果贡献,因为后续还会经过值向量加权、输出映射、残差连接和前馈网络。
提取并绘制一个注意力头
下面示例使用 bert-base-uncased。首次运行需要联网下载模型,并安装 torch、transformers 和 matplotlib。代码固定选择最后一层的第一个注意力头,将权重保存为 PNG 图片。
import matplotlib.pyplot as plt
import torch
from transformers import AutoModel, AutoTokenizer

MODEL_NAME = "bert-base-uncased"
TEXT = "The transformer focuses on important tokens."
OUTPUT_FILE = "attention_layer_12_head_1.png"

tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
model = AutoModel.from_pretrained(
    MODEL_NAME,
    output_attentions=True,
    attn_implementation="eager",
)
model.eval()

inputs = tokenizer(TEXT, return_tensors="pt")
tokens = tokenizer.convert_ids_to_tokens(inputs["input_ids"][0])

# 关闭梯度,避免为纯推理过程保存反向传播信息。
with torch.no_grad():
    outputs = model(**inputs)

# attentions[-1] 取最后一层,[0, 0] 取首个样本和首个注意力头。
attention = outputs.attentions[-1][0, 0].cpu().numpy()

fig, ax = plt.subplots(figsize=(9, 7))
image = ax.imshow(attention, cmap="viridis")
ax.set_xticks(range(len(tokens)))
ax.set_xticklabels(tokens, rotation=60, ha="right")
ax.set_yticks(range(len(tokens)))
ax.set_yticklabels(tokens)
ax.set_xlabel("Key token")
ax.set_ylabel("Query token")
ax.set_title("Layer 12, Head 1")
fig.colorbar(image, ax=ax, label="Attention weight")
fig.tight_layout()
fig.savefig(OUTPUT_FILE, dpi=160)
plt.close(fig)

print(f"attention shape: {tuple(outputs.attentions[-1].shape)}")
print(f"saved: {OUTPUT_FILE}")
预期输出如下,其中 <SEQ_LEN> 由分词结果决定,实际值可能不同。
attention shape: (1, 12, <SEQ_LEN>, <SEQ_LEN>)
saved: attention_layer_12_head_1.png
打开生成的图片后,应能看到横纵轴均为 token 的方形热力图。若模型使用子词分词,同一个单词可能被拆成多个 token;分析时应把这些子词合并理解,而不是把它们当成彼此无关的词。
比较不同层和注意力头
观察模式时应固定同一输入,再依次改变层索引和头索引。浅层常出现邻近位置或局部搭配,深层可能呈现更分散的语义关联;但这只是常见现象,不能预设每个头都承担固定语言功能。
比较多张热力图时,应保持相同的 token 顺序、坐标方向和颜色范围。重点记录可重复出现的结构,例如对角线附近的局部关注、某一列形成的全局关注,以及对 [CLS]、[SEP] 或标点的集中关注。只展示“看起来最漂亮”的头会造成选择偏差。
常见误判与验证边界
注意力权重不是完整解释。一个位置权重高,但其值向量可能携带的信息有限;多个层和残差路径也会共同影响最终结果。需要解释预测时,应把注意力图与遮挡实验、梯度归因或输入扰动结果交叉验证。
还要检查掩码是否正确。填充 token 若未被屏蔽,热力图可能出现无意义的关注;生成式模型还应确认因果掩码,使当前位置不能看到未来 token。不同模型的注意力实现和返回格式可能不同,提取前应先打印张量形状。
本课总结
- 注意力矩阵的行对应查询位置,列对应键位置,层与头必须明确选择。
- 热力图适合发现关注模式,但不能单独证明某个 token 导致了预测结果。
- 有效比较需要固定输入、坐标和颜色范围,并结合其他归因方法验证。
下一课预告
下一课将从可视化转向失败案例,按错误类型、输入长度和数据来源切分样本,定位模型表现下降的具体区域。