
大模型原理与训练 / 系统课时
序列填充与截断
序列填充与截断
Transformer 的批次计算要求同一张量中的序列长度一致。本课将把长短不一的词元编号统一到固定长度,并说明填充方向、截断方向和最大长度应如何选择。
学习目标
- 解释为什么批次中的序列需要统一长度
- 独立实现右填充、左填充与双向截断
- 根据模型限制和数据分布设置最大长度
为什么长度必须统一
一条文本可能只有几个词元,另一条可能有数百个词元。批次通常表示为形状为 [batch_size, sequence_length] 的二维张量,因此同一批次中的每一行必须等长。
短序列需要补入专用的 PAD 词元,长序列则需要删除超出最大长度的部分。填充位置不属于真实输入,后续还要通过注意力掩码把它们排除。
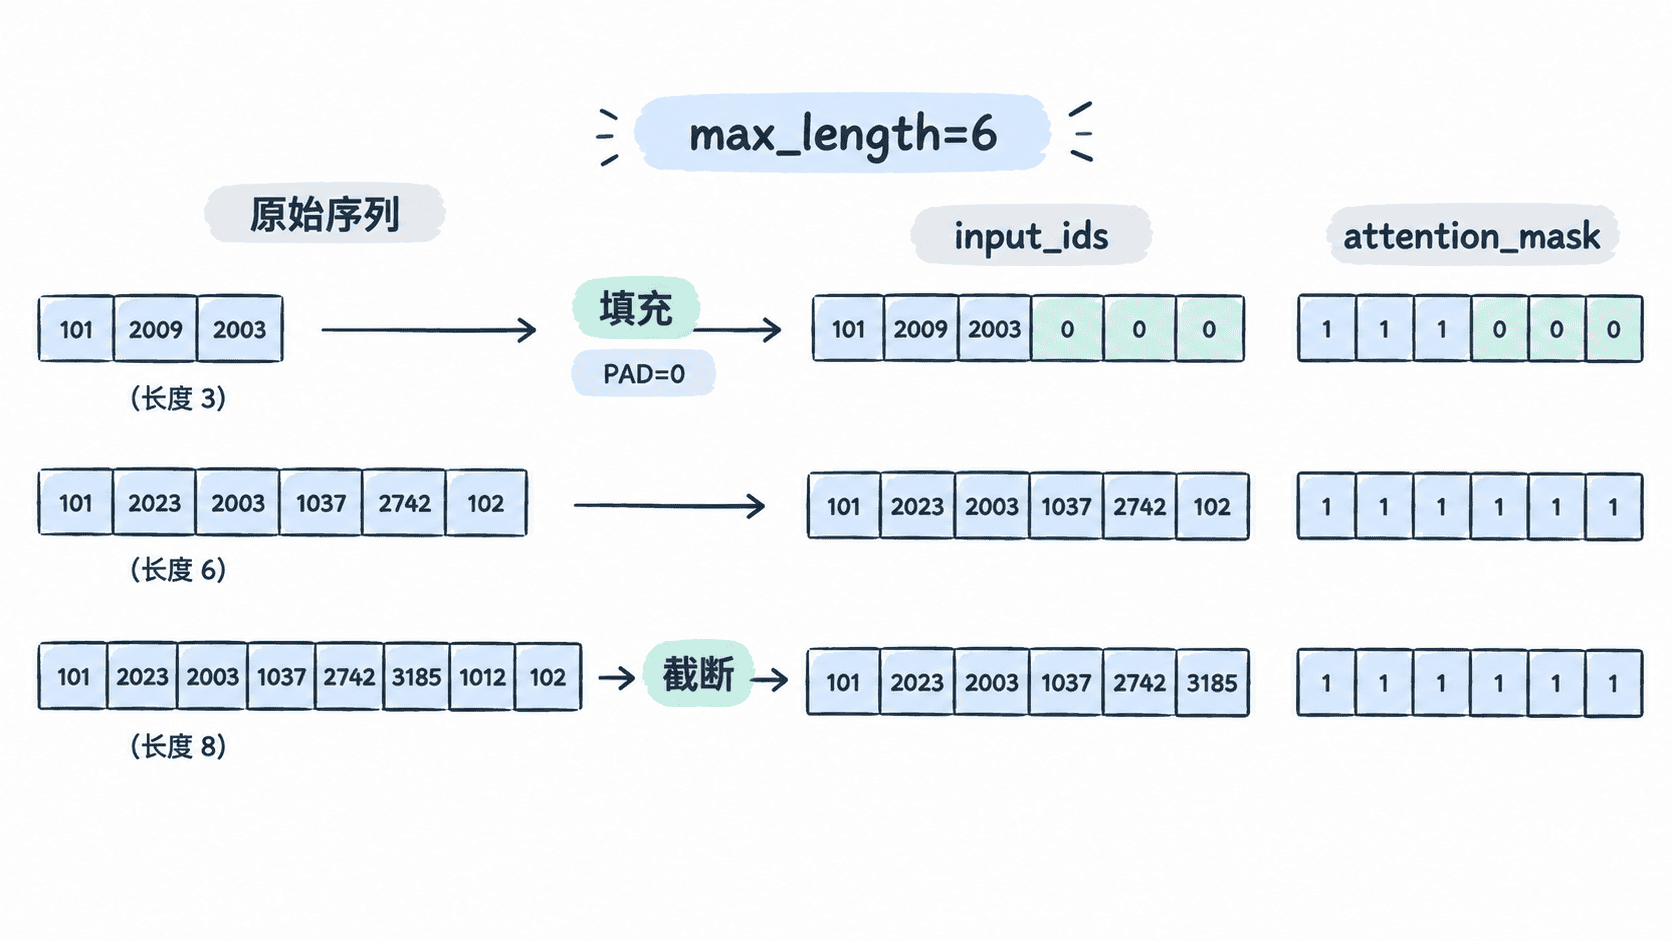
填充与截断规则
| 规则 | 含义 | 常见用途 |
|---|---|---|
| 右填充 | 在序列末尾补 PAD |
编码器模型和多数分类任务 |
| 左填充 | 在序列开头补 PAD |
部分因果语言模型的批量生成 |
| 右截断 | 保留开头,删除末尾 | 标题分类、前文信息更重要的任务 |
| 左截断 | 删除开头,保留末尾 | 对话或日志中近期内容更重要的任务 |
填充方向和截断方向不是同一个概念。例如,可以右填充短序列,同时左截断长序列。实际项目应先确定任务最需要保留哪一端的信息,再固定策略。
用 Python 完成统一长度处理
下面的程序不依赖第三方库,输入词元编号后返回统一长度的 input_ids 和对应的 attention_mask。
python
from typing import Sequence

PAD_ID = 0

def normalize_sequence(
    token_ids: Sequence[int],
    max_length: int,
    padding_side: str = "right",
    truncation_side: str = "right",
) -> tuple[list[int], list[int]]:
    if max_length <= 0:
        raise ValueError("max_length 必须大于 0")
    if padding_side not in {"left", "right"}:
        raise ValueError("padding_side 只能是 left 或 right")
    if truncation_side not in {"left", "right"}:
        raise ValueError("truncation_side 只能是 left 或 right")

    ids = list(token_ids)

    # 先截断,避免填充后再判断真实长度
    if len(ids) > max_length:
        ids = ids[:max_length] if truncation_side == "right" else ids[-max_length:]

    mask = [1] * len(ids)
    pad_count = max_length - len(ids)

    if padding_side == "right":
        return ids + [PAD_ID] * pad_count, mask + [0] * pad_count
    return [PAD_ID] * pad_count + ids, [0] * pad_count + mask

samples = [[11, 12, 13], [21, 22, 23, 24, 25, 26, 27]]

for index, sample in enumerate(samples, start=1):
    input_ids, attention_mask = normalize_sequence(sample, max_length=5)
    print(f"样本{index}: input_ids={input_ids}")
    print(f"样本{index}: attention_mask={attention_mask}")
预期输出:
text
样本1: input_ids=[11, 12, 13, 0, 0]
样本1: attention_mask=[1, 1, 1, 0, 0]
样本2: input_ids=[21, 22, 23, 24, 25]
样本2: attention_mask=[1, 1, 1, 1, 1]
第一个样本被右填充两个位置;第二个样本原有七个词元,因此保留前五个。若改为左截断,第二个样本会保留 [23, 24, 25, 26, 27]。
最大长度如何确定
最大长度首先不能超过模型的位置上限。随后应统计训练数据的长度分布,例如选择能覆盖 95% 样本的长度,而不是直接采用最长样本。
长度越大,单批次显存和计算量越高,标准自注意力的计算还会随序列长度近似平方增长。长度过小则会截掉任务所需信息,因此应在覆盖率、速度和显存之间折中,并在验证集上比较效果。
本课总结
- 填充把短序列补到固定长度,截断把长序列限制在最大长度内
- 填充方向与截断方向应依据模型类型和任务信息位置分别选择
- 最大长度应同时满足模型上限、数据覆盖率和计算资源约束
下一课预告
下一课将把统一长度后的多个样本组成批次,并同时构造输入编号、注意力掩码和标签张量。
按自己的节奏,确认真正理解。