
大模型原理与训练 / 系统课时
词表与特殊标记
词表与特殊标记
词表把文本中的词元转换成模型可处理的整数编号,特殊标记则负责补齐、分隔、启动生成或承载分类信息。本课将建立一套清晰的判断方法,帮助你理解这些标记为何存在,以及它们怎样影响输入和输出。
学习目标
- 理解词表、词元编号与特殊标记之间的关系
- 说清
[UNK]、[PAD]、开始、结束和分类标记的用途 - 避免把特殊标记当作普通文字或忽略对应掩码
词表解决什么问题
模型不能直接计算“苹果”“支付”这类字符串,它接收的是整数序列。分词器先把文本拆成词元,再根据词表为每个词元查找唯一编号。例如,同一个词元只要使用同一份词表,就会稳定地映射到同一个 ID。
词表大小是有限的,因此它不仅决定模型能够直接识别哪些词元,也决定嵌入矩阵需要多少行。训练、微调和推理必须使用与模型匹配的词表,否则同一个编号可能代表完全不同的内容。
五类常见特殊标记
| 标记类型 | 常见写法 | 主要作用 |
|---|---|---|
| 未知词 | [UNK]、<unk> |
词元不在词表中时提供回退编号 |
| 填充 | [PAD]、<pad> |
将不同长度的序列补到同一长度 |
| 开始 | [BOS]、<s> |
告诉生成模型序列从这里开始 |
| 结束 | [EOS]、</s> |
表示生成或输入序列已经结束 |
| 分类 | [CLS] |
提供一个用于汇总整段信息的位置 |
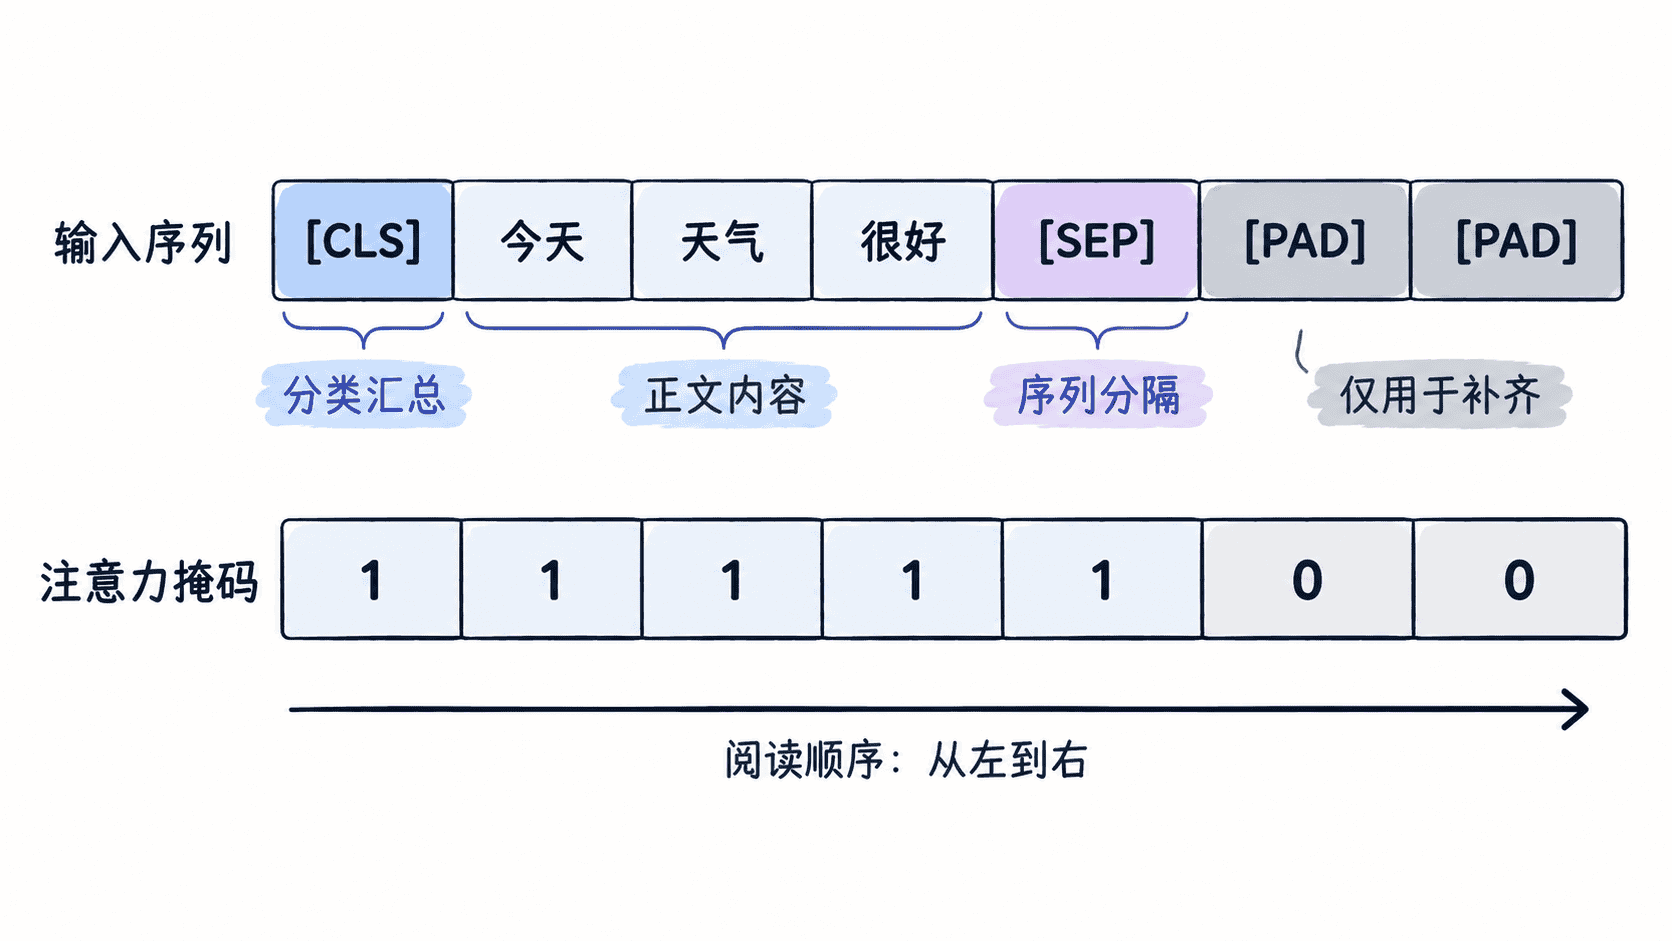
子词或字节级分词器通常能把生词拆得更细,因此 [UNK] 出现得较少,但并不代表所有模型都可以删除它。[PAD] 只负责形状对齐,模型还需要注意力掩码,才能避免把填充位置当作真实内容。
不同模型怎样使用它们
编码器模型常在序列开头放置 [CLS],并把它经过多层计算后的向量交给分类头。自回归生成模型更关注开始和结束标记:开始标记提供首个输入位置,结束标记则告诉解码过程何时停止。
标记名称并不统一。某些模型使用 <s> 和 </s>,某些模型用 [SEP] 分隔句子,还有些模型根本没有 [CLS]。判断用途时应查看分词器配置和模型文档,而不是只凭标记长相推断。
常见误区
不要把 [PAD] 与“空字符串”等同。即使填充值看起来没有语义,只要掩码配置错误,它仍可能参与注意力计算并污染结果。也不要手工替换或新增特殊标记后直接推理,因为新增标记需要扩展嵌入矩阵,并让对应向量经过训练。
[EOS] 表示序列结束,[SEP] 更常用于分隔片段,两者在部分模型中可能复用同一个编号,但逻辑角色仍应结合具体任务理解。
本课总结
- 词表负责把词元稳定映射为整数编号,必须与模型保持一致
- 特殊标记承担未知词回退、批量补齐、序列边界和分类汇总等职责
- 填充标记必须配合注意力掩码,特殊标记也不能脱离模型约定随意修改
下一课预告
下一课将进入词元嵌入,观察这些离散编号如何通过嵌入矩阵变成可训练的连续向量。