
大模型原理与训练 / 系统课时
相对位置偏置
相对位置偏置
本课解决注意力机制如何直接表达“相隔多远”这一问题。你将掌握相对距离、距离分桶、每头偏置与注意力分数之间的关系,并能区分偏置和掩码的职责。
学习目标
- 理解相对位置偏置加入注意力分数的计算位置
- 掌握距离分桶与偏置查表的完整流程
- 分清相对位置偏置、因果掩码和内容相似度
偏置加在什么位置
标准缩放点积注意力先计算查询与键的内容相似度:
相对位置偏置在 Softmax 之前加入一个只由位置关系决定的值:
其中 可以由相对距离 查表得到,也可以由一个固定函数计算。正偏置提高某个位置被关注的倾向,负偏置降低该倾向,但最终权重仍由内容分数、位置偏置和掩码共同决定。
从距离到偏置的流程
对查询位置 和键位置 ,模型先计算有方向的相对距离 。距离为负表示键在查询左侧,距离为正表示键在右侧;在自回归模型中,右侧位置通常还会被因果掩码禁止访问。
若每一个可能距离都单独保存参数,长序列会需要很大的偏置表。常见做法是把距离映射到有限数量的桶:近距离使用更细的刻度,远距离逐渐合并,从而兼顾局部精度和长程覆盖。
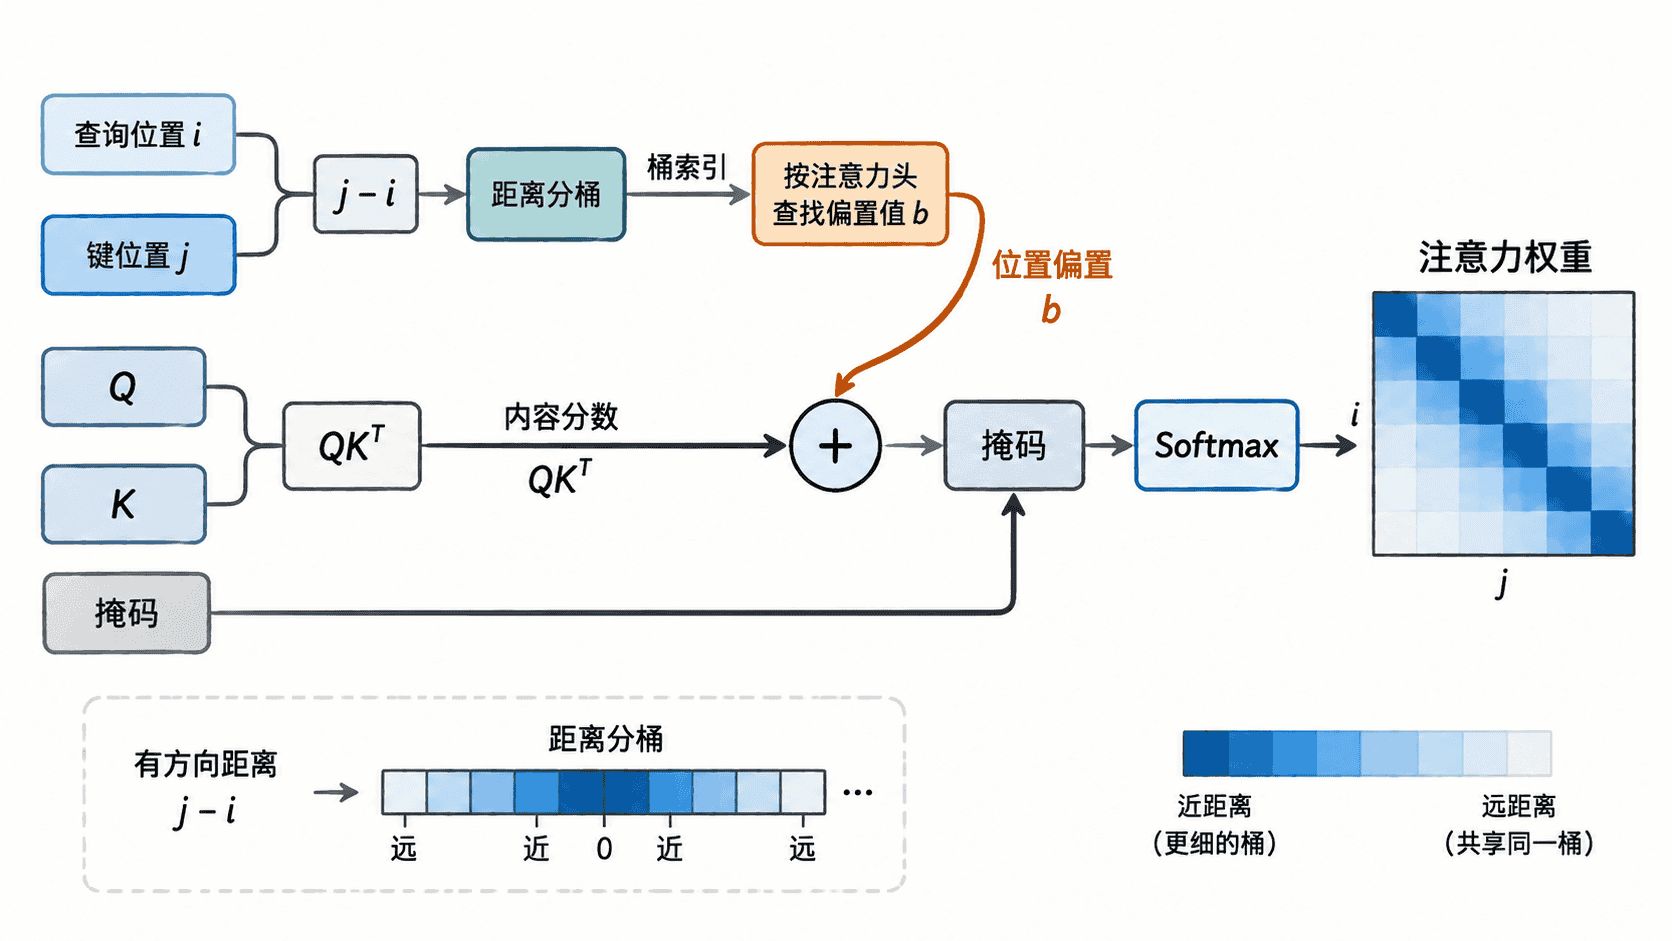
整个流程可以概括为“算距离、做分桶、查偏置、加分数、再归一化”。偏置一般按注意力头分别学习,因此不同头可以形成不同的位置偏好,例如一个头更关注相邻词元,另一个头更关注较远的上下文。
距离分桶为什么有效
自然语言中的精确近距离通常很重要。例如距离 1 和距离 2 可能分别对应相邻修饰关系与跨词关系,因此应保留不同桶。距离达到几十或几百后,模型往往只需要知道“较远”或“非常远”,不必为每个距离保存独立参数。
一种典型策略是让小距离线性分桶,让大距离按对数尺度合并。这样,固定数量的桶就能覆盖较长序列。超过最大范围的距离通常进入最后一个桶,因此参数量不会随输入长度线性增长。
在双向编码器中,正负距离通常分别建桶,以区分左侧和右侧。在因果解码器中,未来位置已被掩码,偏置主要描述当前词元与历史词元之间的距离。
偏置、掩码与内容分数的区别
内容分数回答“这两个词元在语义上是否相关”;相对位置偏置回答“这个距离是否值得优先关注”;掩码回答“这个位置是否允许被看到”。三者在 Softmax 前汇合,但职责不能互相替代。
因果掩码通常把非法位置加上极大的负值,使其归一化后权重接近零。相对位置偏置则是柔性的学习偏好,不应被当作访问控制。即使某个距离的偏置很低,只要没有被掩码,它仍可能因内容高度相关而获得较大权重。
常见形式与选择要点
可学习查表偏置适合让模型自行发现距离模式,距离分桶可以控制参数规模。线性距离偏置则使用与距离成比例的固定斜率,结构更简单,并可能改善长序列外推。
选择方案时应关注模型方向性、最大上下文长度和是否需要长度外推。无论采用哪种形式,都应确认偏置张量能够正确广播到“批次、注意力头、查询长度、键长度”对应的分数形状,避免把距离方向或维度顺序写反。
本课总结
- 相对位置偏置在 Softmax 前加入注意力分数,直接调节不同距离的关注倾向
- 距离分桶用精细近距离和合并远距离控制参数量,并可按注意力头分别学习
- 偏置是柔性偏好,掩码是访问限制,二者不能混用
下一课预告
下一课将继续比较位置建模方案,观察旋转编码、可学习偏置与线性偏置在结构和长上下文能力上的差异。