
大模型原理与训练 / 系统课时
旋转位置编码
旋转位置编码
本课解决 Transformer 如何在不直接相加位置向量的情况下感知词元距离的问题。你将理解 RoPE 如何旋转查询与键,并看清注意力分数为何会自然包含相对位置信息。
学习目标
- 理解 RoPE 对向量成对维度执行旋转的基本方式
- 推导查询与键的点积为何只依赖相对位置
- 识别 RoPE 的使用位置、优势与常见边界
从绝对位置到旋转角度
普通绝对位置编码通常把位置向量与词元表示相加。RoPE 则不改写词元表示本身,而是在计算注意力前,根据词元位置旋转查询向量 和键向量 。位置越靠后,累积旋转角度越大。
对于向量中的第 对维度,可将 看成二维平面上的一个点。位置 对应的旋转角为 ,变换写成:
不同维度对使用不同频率 。高频维度对短距离变化更敏感,低频维度可以表示更长范围的位置关系。
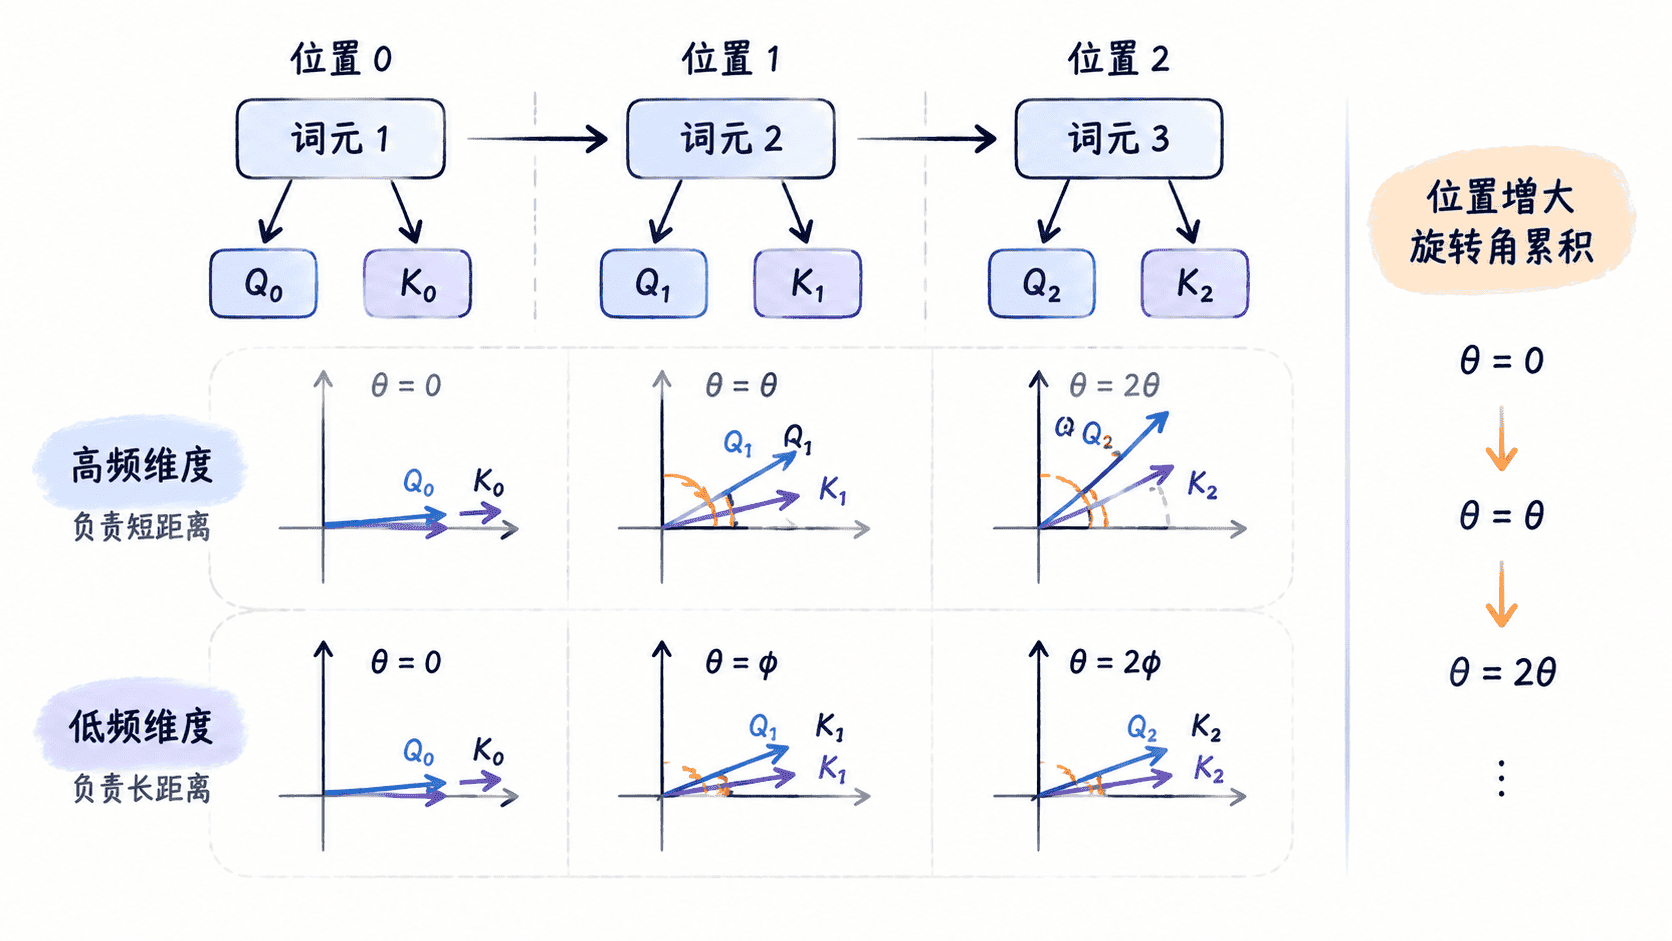
图中最重要的关系不是某个向量最终朝向哪里,而是两个位置对应的旋转角之差。这个角度差会直接进入查询与键的相似度计算。
相对位置如何进入点积
设原始查询和键分别为 、,它们位于位置 和 。经过旋转后,注意力中的点积为:
由于 ,最终结果只与位置差 有关。模型仍然使用标准点积注意力,但点积已经同时编码了内容相似度与相对距离。
例如,位置 2 的查询关注位置 5 的键时,旋转差对应距离 3。把整段序列同时向后平移,只要两个词元的距离不变,这部分位置关系就保持一致。
RoPE 放在注意力的哪里
RoPE 通常应用在每个注意力头的 和 上,然后再计算缩放点积与 Softmax。值向量 一般不旋转,因为它负责承载被聚合的内容,而位置关系主要用于决定“关注谁”。
处理顺序可以概括为:线性投影得到 、、,按位置旋转 、,计算注意力分数,应用掩码与 Softmax,最后对 加权求和。RoPE 不改变注意力矩阵的基本计算接口,因此容易集成进现有 Transformer。
优势与使用边界
RoPE 把相对位置信息融入点积,既保留了绝对位置对应的旋转状态,又让查询与键之间的关系显式依赖距离。它不需要额外生成一张位置偏置矩阵,对自回归模型尤其自然。
实现时需要注意三点:注意力头维度通常应为偶数,便于按二维成对旋转;训练长度之外的外推效果并非自动可靠;长上下文模型常会配合频率缩放或位置插值,减缓高位置处角度变化过快的问题。
RoPE 与“直接给注意力分数加偏置”不是同一种机制。前者先改变 、 的几何方向,后者在点积之后额外调整分数,两者都能表达相对位置,但作用位置不同。
本课总结
- RoPE 将向量维度两两分组,并按词元位置执行不同频率的二维旋转
- 查询与键旋转后的点积包含 ,因此自然依赖相对距离
- RoPE 通常只作用于 、,长上下文场景还需考虑频率缩放与外推边界
下一课预告
下一课将学习相对位置偏置,理解模型如何把词元距离映射为可学习偏置,并直接加入注意力分数。