
大模型原理与训练 / 系统课时
误差样本分析
误差样本分析
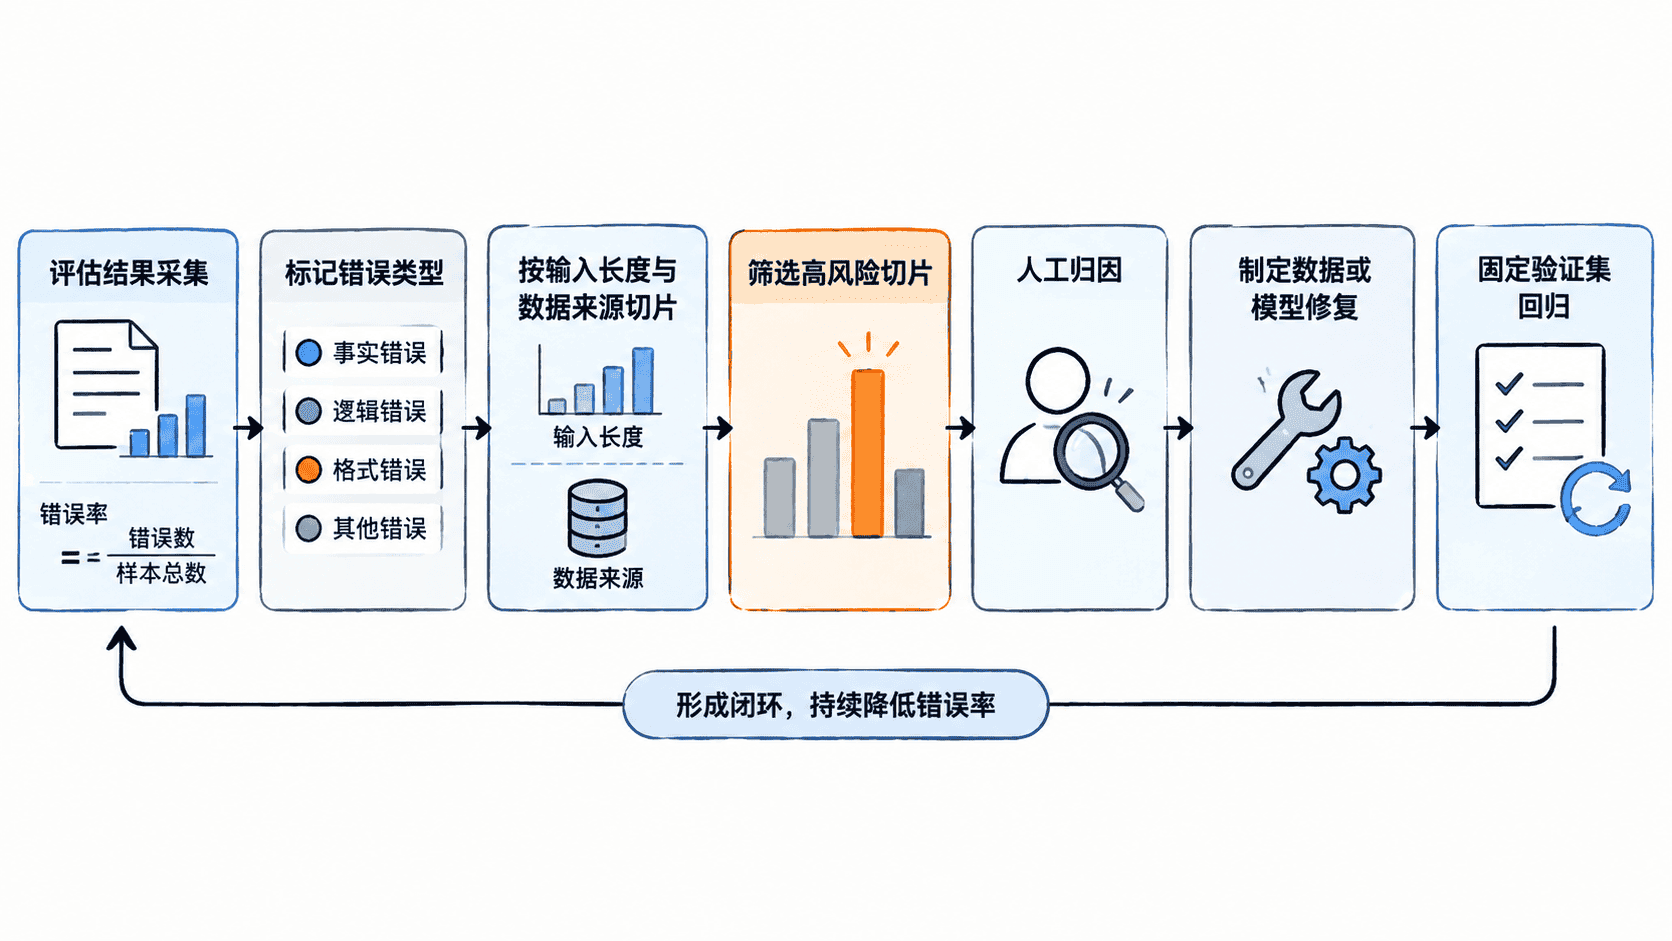
误差样本分析解决的是“总体指标下降后,究竟哪些输入失败、为什么失败、应先修什么”的问题。本课将建立错误类型与数据切片,使用可运行代码统计输入长度和来源分布,并把统计结果转化为修复动作。
学习目标
- 为预测结果补充可追踪的错误类型和样本属性。
- 按输入长度、数据来源与标签混淆关系计算错误率。
- 从高风险切片中归纳根因,并设计可验证的修复方案。
先建立可分析的样本记录
一条评估记录至少应包含样本 ID、真实标签、预测标签、模型分数、输入长度和数据来源。输入长度最好使用模型实际 token 数,而不是字符数;数据来源可以是端、渠道、时间段、语言或业务场景。
分析时不要只保存错误样本。错误率的分母来自全部样本,若缺少正确样本,就只能统计错误数量,无法判断某个切片是真的更差,还是仅仅样本更多。
定义错误类型和分析切片
二分类任务可以把错误分成假阳性与假阴性。多分类任务更适合记录 真实标签 → 预测标签 的混淆对,例如 退款咨询 → 投诉,因为不同混淆对通常对应不同修复策略。
切片维度要与可采取的动作相连。长度切片可以暴露截断或长距离依赖问题,来源切片可以发现渠道分布漂移,时间切片可以识别新业务或新词汇。切片过细会造成样本量太小,因此每个结果都应同时报告样本数和错误率。
用代码定位高风险切片
下面示例构造一组二分类评估记录,标记错误类型,并分别统计长度区间和数据来源的错误率。真实项目中可将 rows 替换为从评估文件读取的数据,但应保留相同字段。
import pandas as pd

rows = [
    {"sample_id": "S01", "true_label": 1, "pred_label": 1, "length": 8, "source": "app"},
    {"sample_id": "S02", "true_label": 1, "pred_label": 0, "length": 42, "source": "app"},
    {"sample_id": "S03", "true_label": 0, "pred_label": 1, "length": 15, "source": "web"},
    {"sample_id": "S04", "true_label": 0, "pred_label": 0, "length": 63, "source": "web"},
    {"sample_id": "S05", "true_label": 1, "pred_label": 0, "length": 95, "source": "partner"},
    {"sample_id": "S06", "true_label": 0, "pred_label": 1, "length": 108, "source": "partner"},
    {"sample_id": "S07", "true_label": 1, "pred_label": 1, "length": 28, "source": "web"},
    {"sample_id": "S08", "true_label": 0, "pred_label": 0, "length": 36, "source": "app"},
    {"sample_id": "S09", "true_label": 1, "pred_label": 0, "length": 130, "source": "partner"},
    {"sample_id": "S10", "true_label": 0, "pred_label": 0, "length": 12, "source": "web"},
]
df = pd.DataFrame(rows)

df["is_error"] = df["true_label"] != df["pred_label"]
df["error_type"] = "correct"
df.loc[
    (df["true_label"] == 1) & (df["pred_label"] == 0),
    "error_type",
] = "false_negative"
df.loc[
    (df["true_label"] == 0) & (df["pred_label"] == 1),
    "error_type",
] = "false_positive"

# 分桶边界应结合模型最大长度和业务样本分布制定。
df["length_group"] = pd.cut(
    df["length"],
    bins=[0, 32, 64, 128, float("inf")],
    labels=["short", "medium", "long", "extra_long"],
)

length_report = (
    df.groupby("length_group", observed=True)
    .agg(sample_count=("sample_id", "count"), error_rate=("is_error", "mean"))
    .reset_index()
)
source_report = (
    df.groupby("source", observed=True)
    .agg(sample_count=("sample_id", "count"), error_rate=("is_error", "mean"))
    .reset_index()
)

print("error samples")
print(df.loc[df["is_error"], ["sample_id", "error_type"]].to_string(index=False))
print("\nby length")
print(length_report.round(2).to_string(index=False))
print("\nby source")
print(source_report.round(2).to_string(index=False))
预期输出如下。列间空格可能因 pandas 版本略有差异,但样本数和错误率应一致。
error samples
sample_id     error_type
      S02 false_negative
      S03 false_positive
      S05 false_negative
      S06 false_positive
      S09 false_negative

by length
length_group  sample_count  error_rate
       short             4        0.25
      medium             3        0.33
        long             2        1.00
  extra_long             1        1.00

by source
 source  sample_count  error_rate
    app             3        0.33
partner             3        1.00
    web             4        0.25
这组数据表明长输入和 partner 来源值得优先检查,但样本量很小,不能直接得出稳定结论。真实评估中应设置最小样本数门槛,并查看置信区间或在更大样本上复现。
从统计结果追到根因
高错误率切片只是定位入口。接下来应抽取代表性样本,给每条错误补充可执行的根因标签,再汇总根因占比。标签应描述能够被修复的问题,而不是写成“模型能力不足”这类无法行动的结论。
| 观察到的现象 | 可能根因 | 优先验证动作 |
|---|---|---|
| 长输入错误率高 | 关键内容被截断 | 检查 token 长度、截断方向和最大长度 |
| 某来源持续偏高 | 数据分布或字段格式变化 | 对比训练集与该来源的特征分布 |
| 假阴性集中 | 阈值偏高或正类覆盖不足 | 查看分数分布并补充正类样本 |
| 标签混淆固定出现 | 类别边界模糊或标注不一致 | 复核标注规范与混淆样本 |
人工复核时应同时记录输入、真实标签、预测标签、分数、根因和处理建议。若发现标签本身错误,应先修正评估数据,再判断模型问题,避免用错误标签指导训练。
验证修复是否真正有效
修复后必须在固定验证集上重新评估,并单独查看原高风险切片。只看总体准确率可能掩盖局部退化,例如长文本改善了,但短文本假阳性明显增加。
验收条件应在修改前定义,例如“partner 来源至少 200 条样本,错误率下降 5 个百分点,同时总体 F1 不下降”。用于分析和调参的样本不能混入最终测试集,否则会产生评估泄漏。
本课总结
- 误差分析必须保留全部样本,同时报告错误数量、样本数和错误率。
- 长度、来源和标签混淆切片用于定位问题,人工根因标签用于决定修复动作。
- 修复效果要在固定验证集和原高风险切片上同时回归,避免总体指标掩盖局部退化。
下一课预告
下一课将进一步结合归因结果与评估指标,建立可重复的模型回归检查流程,判断新版本是否满足上线条件。