
大模型原理与训练 / 系统课时
缩放点积注意力
缩放点积注意力
本课解决一个关键问题:为什么注意力分数不能直接送入 Softmax,而要先除以 。你将从方差变化理解缩放因子的来源,并通过可运行示例观察它如何减轻分布过度尖锐和梯度不稳定。
学习目标
- 解释缩放因子 的统计来源
- 说明缩放对 Softmax 分布和梯度的影响
- 独立完成缩放点积注意力的分数计算
缩放因子从哪里来
设查询向量 和键向量 的每个分量相互独立、均值为 0、方差为 1。点积由 个乘积项相加,因此其方差会随维度近似增长为 ,标准差则增长为 。
当 很大时,分数绝对值更容易变大。Softmax 会把较大的差异进一步放大,使概率接近 0 或 1。此时多数位置的梯度很小,模型更新会变得困难。
将分数除以 后,分数的典型尺度重新回到接近 1:
这一步不是为了改变分数排序,而是控制分数进入 Softmax 前的数值范围。
计算链路与示例
缩放点积注意力先计算 ,再按键向量维度缩放,随后对每一行做 Softmax。每一行得到一个查询位置面向全部键位置的注意力分布。
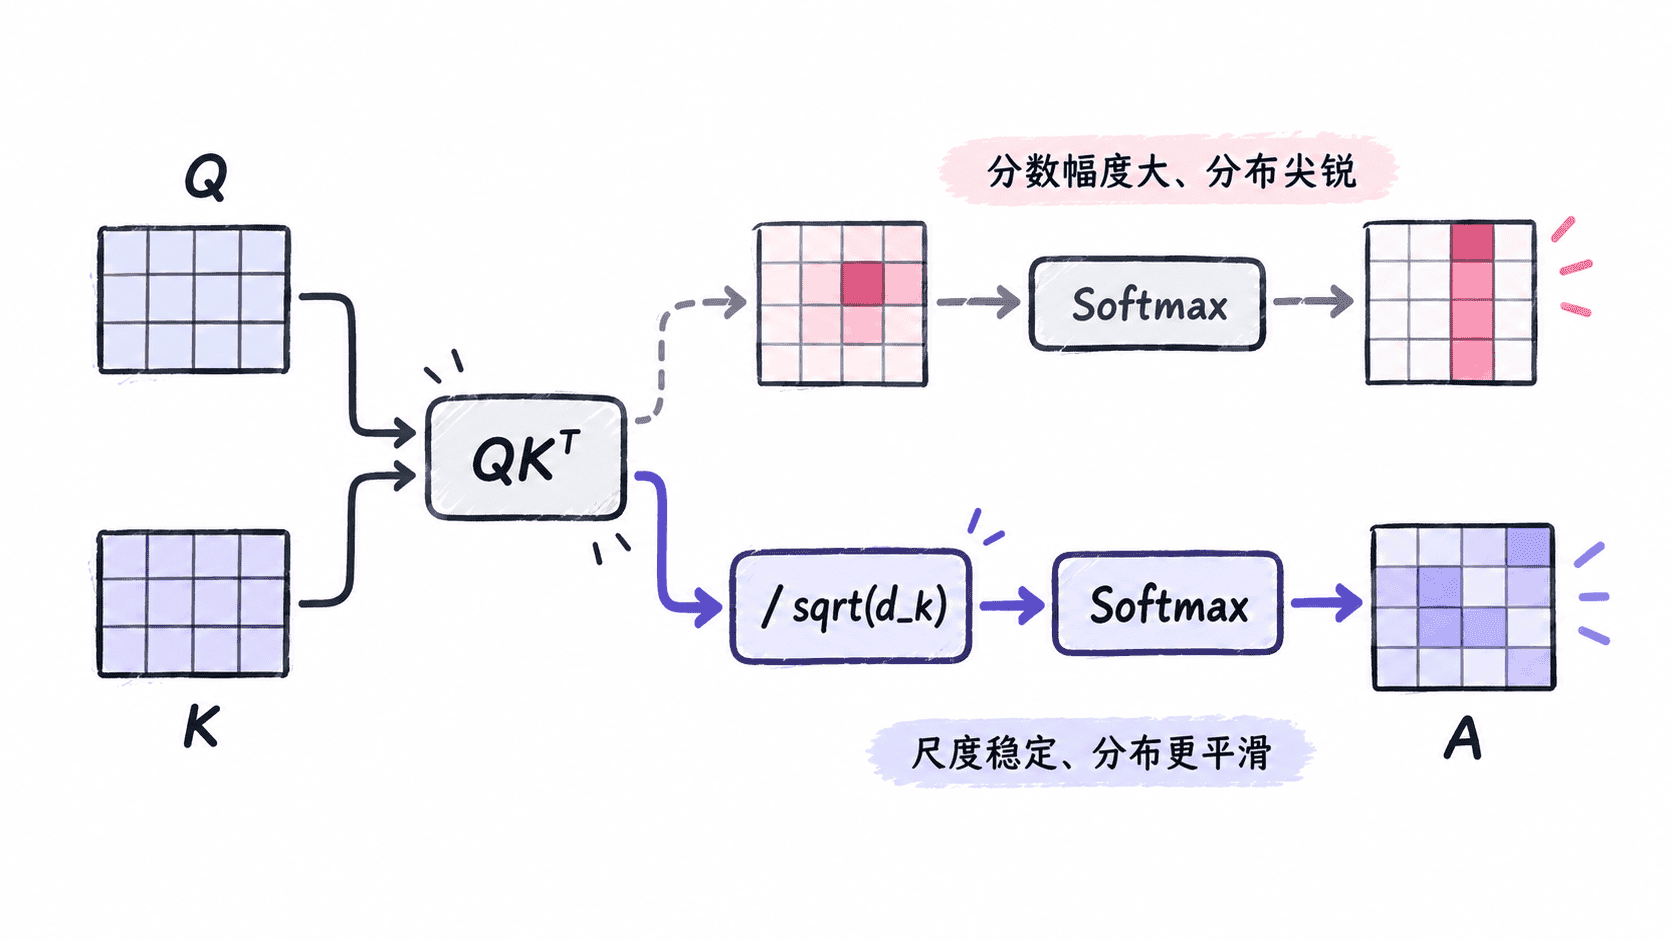
下面使用相同的查询和键,比较缩放前后的 Softmax 结果:
python
import math

def softmax(values):
    max_value = max(values)
    exps = [math.exp(value - max_value) for value in values]
    total = sum(exps)
    return [value / total for value in exps]

def dot(left, right):
    return sum(a * b for a, b in zip(left, right))

def main():
    q = [1.0, 1.0, 1.0, 1.0]
    keys = [
        [1.0, 1.0, 1.0, 1.0],
        [1.0, 1.0, 1.0, 0.0],
        [1.0, 0.0, 0.0, 0.0],
    ]

    # 原始点积会随维度增加而扩大。
    scores = [dot(q, key) for key in keys]
    scaled_scores = [score / math.sqrt(len(q)) for score in scores]

    # 分别观察未缩放和缩放后的注意力分布。
    print("raw:", [round(value, 4) for value in softmax(scores)])
    print("scaled:", [round(value, 4) for value in softmax(scaled_scores)])

if __name__ == "__main__":
    main()
预期输出:
text
raw: [0.7054, 0.2595, 0.0351]
scaled: [0.5465, 0.3315, 0.122]
缩放没有改变三个键的相关性顺序,但降低了最高权重的垄断程度。实际模型中的分数维度更高,这种稳定尺度的作用会更加明显。
使用边界
- 分母使用键向量维度 ,不是序列长度、Value 维度或模型总维度
- 缩放必须发生在 Softmax 之前;对概率缩放会破坏概率和为 1 的性质
- Softmax 中减去行最大值用于防止指数溢出,但不能替代 的方差控制作用
本课总结
- 点积方差随 增长,除以 可以稳定分数尺度
- 缩放能降低 Softmax 过早饱和的风险,让梯度更易传播
- 标准计算顺序是 、缩放、按行 Softmax
下一课预告
下一课将使用本课得到的注意力权重,对 Value 向量进行加权求和,形成每个位置的上下文相关表示。
按自己的节奏,确认真正理解。