
大模型原理与训练 / 系统课时
Softmax 概率归一化
Softmax 概率归一化
Softmax 用来把一组任意实数分数转换为总和为 1 的概率分布。本课将从公式、计算过程和数值稳定性三个角度理解它,并用一个可运行示例验证“减去最大值”不会改变结果,却能避免指数溢出。
学习目标
- 理解 Softmax 的输入、输出及概率归一化过程
- 能手工计算一个小向量的 Softmax 结果
- 掌握减去最大值的数值稳定性写法
Softmax 在解决什么问题
模型常输出一组未归一化分数,通常称为 logits。例如分类器对三个类别给出 [2.0, 1.0, 0.1],这些值既可能为负,也不要求总和为 1,不能直接当作概率。
Softmax 先对每个分数取指数,再除以所有指数值之和。对向量 ,第 个输出为:
指数运算保证结果为正,除以总和则保证所有输出之和等于 1。较大的输入会获得更高概率,而且输入差距会被指数函数进一步放大。
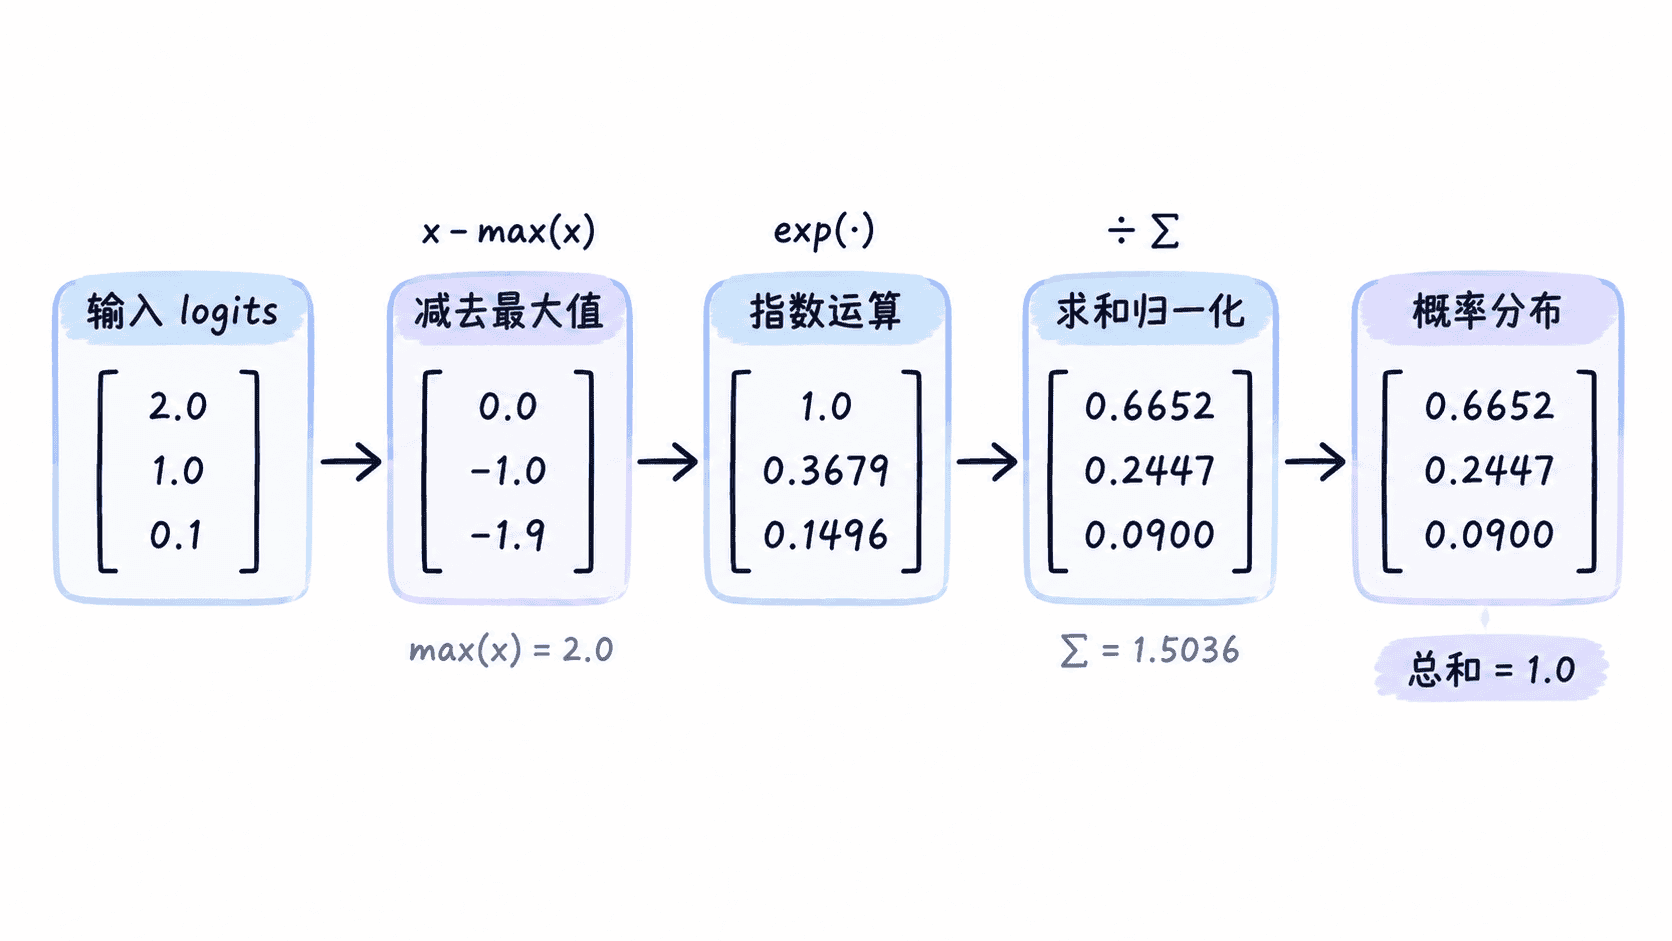
手工理解计算过程
以 [2.0, 1.0, 0.1] 为例,指数值约为 [7.389, 2.718, 1.105],总和约为 11.212。分别除以总和后,概率约为 [0.659, 0.242, 0.099]。
这里要注意两点:Softmax 保留分数的相对顺序,但输出差值不是线性缩放;给所有输入同时加上或减去同一个常数,最终概率不会改变。
为什么要减去最大值
直接计算 可能溢出。例如某个 logit 为 1000 时,常见浮点类型无法表示 。稳定写法先令 ,再计算:
分子和分母同时乘了相同因子 ,所以数学结果不变。减去最大值后,最大的指数项变成 ,其余项不大于 1,从而显著降低溢出风险。
用 Python 验证
下面的示例实现稳定版 Softmax,并同时测试普通输入和极大输入。
import math

def softmax(values: list[float]) -> list[float]:
    if not values:
        raise ValueError("values must not be empty")

    # 减去最大值,避免 exp 在大输入上溢出
    max_value = max(values)
    exponents = [math.exp(value - max_value) for value in values]
    total = sum(exponents)

    return [value / total for value in exponents]

def main() -> None:
    normal = softmax([2.0, 1.0, 0.1])
    large = softmax([1000.0, 999.0, 998.0])

    print([round(value, 4) for value in normal])
    print([round(value, 4) for value in large])
    print(round(sum(normal), 10))

if __name__ == "__main__":
    main()
预期输出:
[0.659, 0.2424, 0.0986]
[0.6652, 0.2447, 0.09]
1.0
实际末位可能因浮点舍入略有差异,但概率和应接近 1。
使用时的关键边界
Softmax 通常沿“类别”或“候选项”所在的维度计算,而不是把整个张量一次性压平。在注意力机制中,它常用于把每个查询位置对应的一行相似度分数转换为权重。
Softmax 只表达相对偏好,并不自动保证概率已经校准。输入差距过大时,输出会非常尖锐;差距很小时,输出则更接近均匀分布。
本课总结
- Softmax 通过指数运算和归一化把 logits 转换为正数且总和为 1 的分布
- 给所有输入加减同一常数不会改变结果
- 工程实现应先减去最大值,避免指数溢出
下一课预告
下一课将学习张量形状与广播,重点理解批次、序列、特征和注意力头等维度如何组织与自动扩展。