
大模型原理与训练 / 系统课时
批次数据与掩码
批次数据与掩码
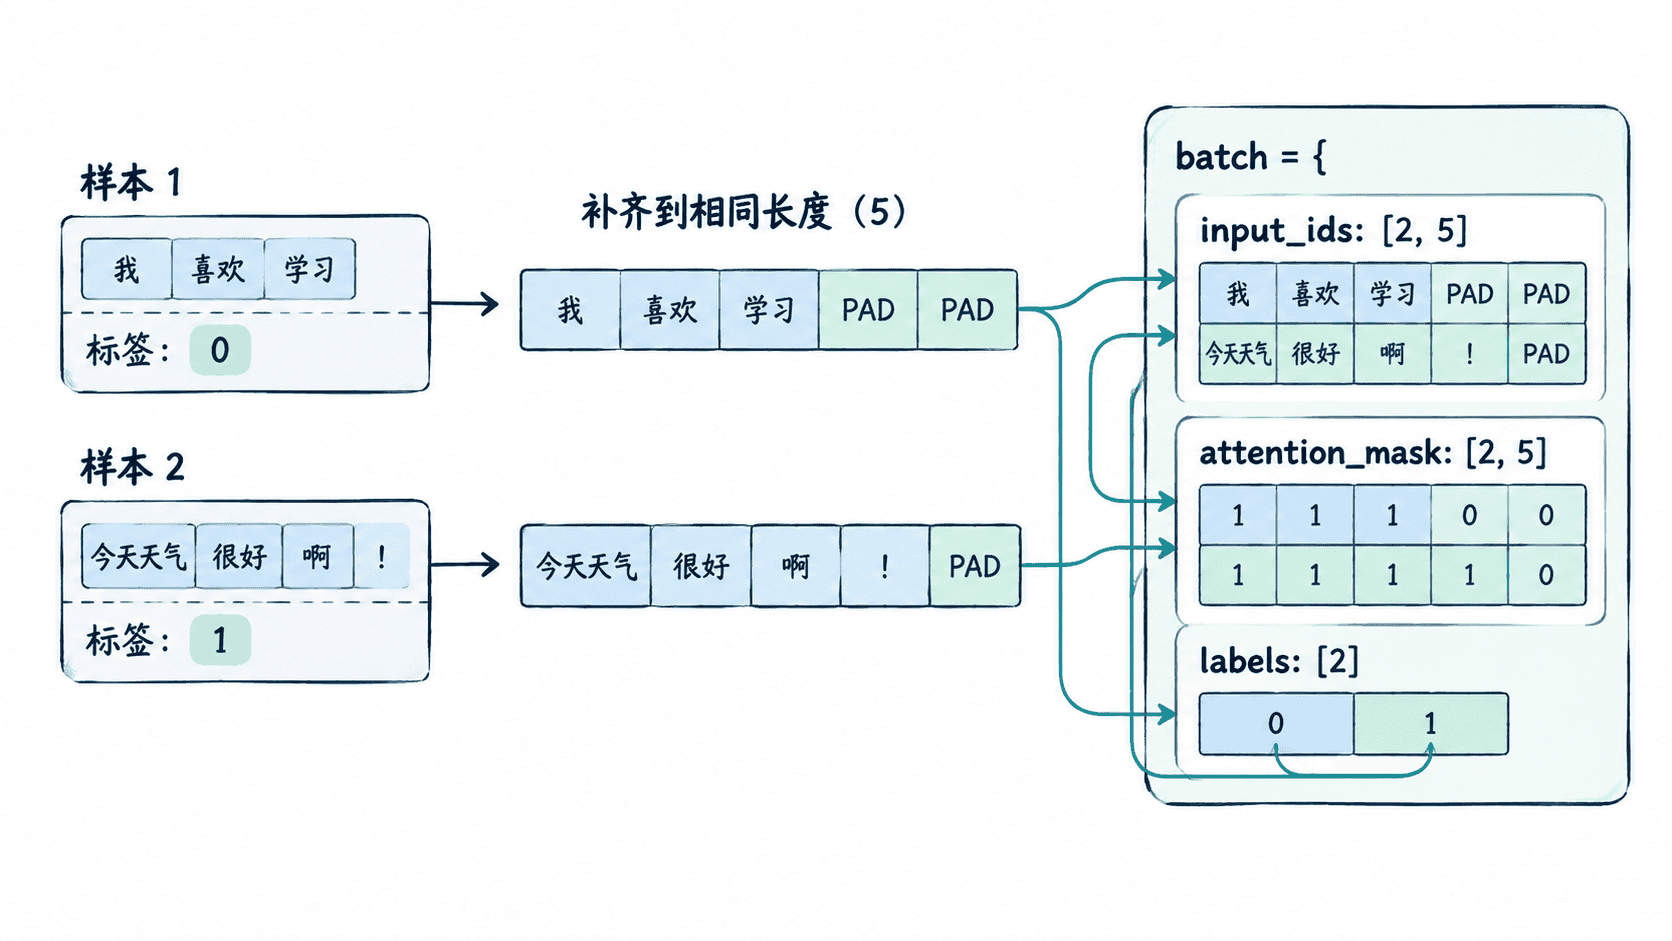
完成填充和截断后,还需要把多个样本组织成模型可接收的批次。本课将构造 input_ids、attention_mask 和 labels,并用张量形状检查数据是否正确。
学习目标
- 说明批次中三个核心张量各自承担的职责
- 构造形状一致的输入编号、注意力掩码和标签
- 根据任务类型判断标签张量的正确形状
三个张量与形状
文本分类批次通常包含三个键。input_ids 保存词元编号,attention_mask 用 1 标记真实词元、用 0 标记填充位置,labels 保存每个样本的类别编号。
若批次大小为 、统一序列长度为 ,文本分类时常见形状如下:
| 张量 | 形状 | 作用 |
|---|---|---|
input_ids |
[B, L] |
模型的离散输入编号 |
attention_mask |
[B, L] |
指示哪些位置可参与注意力计算 |
labels |
[B] |
每个样本对应一个分类标签 |
构造一个可运行批次
下面使用 PyTorch 构造一个二分类批次。示例假设 0 是专用填充编号,运行环境已安装 PyTorch。
python
from typing import Dict

import torch

PAD_ID = 0

def build_batch(
    sequences: list[list[int]],
    labels: list[int],
) -> Dict[str, torch.Tensor]:
    if not sequences:
        raise ValueError("sequences 不能为空")
    if len(sequences) != len(labels):
        raise ValueError("样本数与标签数必须一致")

    max_length = max(len(sequence) for sequence in sequences)
    input_rows: list[list[int]] = []
    mask_rows: list[list[int]] = []

    # 每个样本补到当前批次的最长长度
    for sequence in sequences:
        pad_count = max_length - len(sequence)
        input_rows.append(sequence + [PAD_ID] * pad_count)
        mask_rows.append([1] * len(sequence) + [0] * pad_count)

    batch = {
        "input_ids": torch.tensor(input_rows, dtype=torch.long),
        "attention_mask": torch.tensor(mask_rows, dtype=torch.long),
        "labels": torch.tensor(labels, dtype=torch.long),
    }

    # PAD 位置必须与 mask=0 一一对应
    expected_mask = batch["input_ids"].ne(PAD_ID).long()
    assert torch.equal(batch["attention_mask"], expected_mask)
    return batch

batch = build_batch(
    sequences=[[31, 32, 33], [41, 42, 43, 44, 45]],
    labels=[0, 1],
)

for name, tensor in batch.items():
    print(f"{name}: shape={tuple(tensor.shape)}, dtype={tensor.dtype}")

print(batch["attention_mask"])
print("mask check: passed")
预期输出:
text
input_ids: shape=(2, 5), dtype=torch.int64
attention_mask: shape=(2, 5), dtype=torch.int64
labels: shape=(2,), dtype=torch.int64
tensor([[1, 1, 1, 0, 0],
        [1, 1, 1, 1, 1]])
mask check: passed
输出中的 2 是批次大小,5 是该批次的统一序列长度。第一个样本只有三个真实词元,因此最后两个位置被填充,并在掩码中对应为 0。
如何验证掩码与标签
检查批次时,不要只看张量是否能创建成功。应确认 input_ids 与 attention_mask 的形状完全相同,填充位置全部为 0 掩码,并且 labels 的第一维等于批次大小。
标签形状取决于任务。文本分类通常为 [B];序列标注通常为 [B, L];因果语言模型的训练标签也常为 [B, L]。填充位置若参与逐词损失,通常需要设置为框架约定的忽略值,例如 PyTorch 交叉熵常用 -100。
本课总结
input_ids保存词元编号,attention_mask区分真实词元与填充位置- 文本分类的输入与掩码通常为
[B, L],标签通常为[B] - 批次交付模型前应同时检查形状、数据类型和填充位置的一致性
下一课预告
下一课将把批次张量送入嵌入层,观察离散词元编号如何转换为可训练的连续向量表示。
按自己的节奏,确认真正理解。