
大模型原理与训练 / 系统课时
学习率预热与衰减
学习率预热与衰减
Transformer 对训练初期的学习率非常敏感。本课用一条完整调度曲线说明预热、线性衰减与余弦衰减各自解决什么问题,并给出可直接运行的计算示例,帮助你为实际训练选择参数并验证调度是否按预期生效。
学习目标
- 解释学习率预热为何能降低训练初期的不稳定性
- 区分线性衰减与余弦衰减的变化方式和适用场景
- 编写并验证一条包含预热阶段的学习率调度曲线
为什么训练初期需要预热
Transformer 刚开始训练时,参数尚未形成稳定表示,梯度尺度也可能快速波动。若一开始就使用峰值学习率,单次更新可能过大,造成损失突然升高、梯度溢出,甚至训练直接发散。
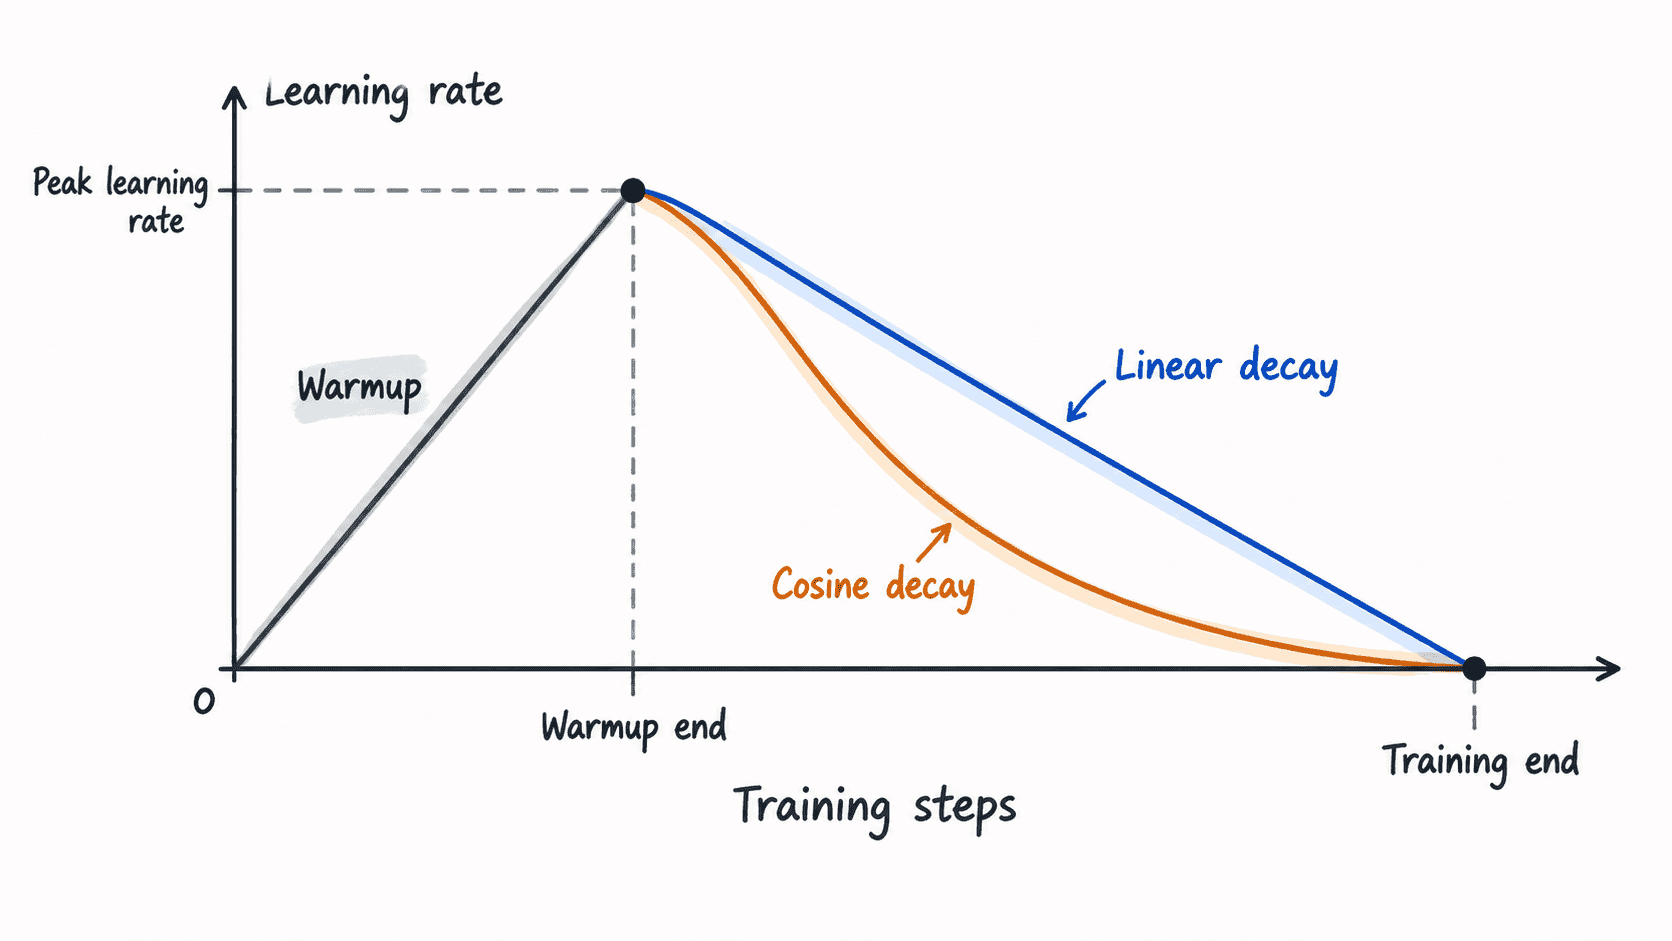
预热的做法是让学习率从较小值逐步升到峰值。在线性预热中,第 步的学习率可写成 ,其中 是预热步数。预热结束后再进入衰减阶段,使模型先稳定起步,再逐渐减小更新幅度。
线性衰减与余弦衰减
线性衰减让学习率按固定速度下降,行为直观,常用于总训练步数明确的微调任务。它在训练末尾会接近零,因此后期参数更新非常小。
余弦衰减按半个余弦周期平滑下降,前期下降较慢,后期逐渐收敛到设定的最小学习率。它适合希望中后期仍保留一定探索空间的训练,也常与较长训练周期配合。
两者没有绝对优劣。固定训练预算、强调简单可控时优先线性衰减;训练周期较长、希望变化更平滑时可选择余弦衰减。关键是把预热步数、总步数和峰值学习率按同一训练计划计算。
可运行示例
下面的 Python 程序计算同一组训练步数下的线性衰减和余弦衰减。示例不依赖深度学习框架,可先用它检查曲线数值,再迁移到训练代码中。
import math

BASE_LR = 1e-3
MIN_LR = 1e-5
WARMUP_STEPS = 100
TOTAL_STEPS = 1000

def warmup_lr(step: int) -> float:
    # 预热阶段从 0 线性增长到峰值学习率
    return BASE_LR * step / WARMUP_STEPS

def linear_lr(step: int) -> float:
    if step <= WARMUP_STEPS:
        return warmup_lr(step)
    progress = (step - WARMUP_STEPS) / (TOTAL_STEPS - WARMUP_STEPS)
    return BASE_LR * max(0.0, 1.0 - progress)

def cosine_lr(step: int) -> float:
    if step <= WARMUP_STEPS:
        return warmup_lr(step)
    progress = (step - WARMUP_STEPS) / (TOTAL_STEPS - WARMUP_STEPS)
    # 余弦衰减最终停在 MIN_LR,而不是降到 0
    cosine_factor = 0.5 * (1.0 + math.cos(math.pi * progress))
    return MIN_LR + (BASE_LR - MIN_LR) * cosine_factor

for step in (0, 50, 100, 500, 1000):
    print(
        f"step={step:4d} "
        f"linear={linear_lr(step):.8f} "
        f"cosine={cosine_lr(step):.8f}"
    )
预期输出
step=   0 linear=0.00000000 cosine=0.00000000
step=  50 linear=0.00050000 cosine=0.00050000
step= 100 linear=0.00100000 cosine=0.00100000
step= 500 linear=0.00055556 cosine=0.00059096
step=1000 linear=0.00000000 cosine=0.00001000
输出表明两条曲线在预热阶段完全一致;进入衰减阶段后,余弦曲线下降更平滑,并在最后保留 MIN_LR。
如何选择并验证参数
预热步数通常按总训练步数的比例设置,但不能只机械套用固定百分比。批次变大、峰值学习率提高或模型更深时,可适当延长预热;小规模微调则常使用更短预热。
接入训练框架后,应记录每个优化器更新对应的学习率,并至少检查三个位置:第一个更新步、预热结束步和最后一步。若使用梯度累积,调度器应按“优化器实际更新次数”推进,而不是按每个微批次推进。
常见错误包括把总样本数误当作总更新步数、预热结束后学习率出现跳变,以及余弦衰减未设置最小学习率。出现损失在训练早期剧烈震荡时,应同时检查峰值学习率、预热长度和梯度范数,不能只增加预热步数。
本课总结
- 预热通过限制训练初期的更新幅度,降低损失突增和发散风险
- 线性衰减简单直接,余弦衰减变化更平滑并可保留最小学习率
- 调度器必须按真实优化器更新步数计算,并通过日志核对关键节点
下一课预告
下一课将处理另一类训练稳定性问题:使用梯度裁剪限制异常梯度,并通过梯度累积在显存有限时模拟更大的有效批次。