
大模型原理与训练 / 系统课时
模型调参与对比
模型调参与对比
本课用一套可重复的对照实验,比较学习率、批次大小、序列长度和可训练层数对 Transformer 微调结果的影响。完成后,你将得到一套能复用的实验方法,而不是凭单次指标猜参数。
学习目标
- 设计一次只改变一个变量的可比较实验
- 运行并记录四类核心参数的对照结果
- 根据验证集损失、准确率和资源消耗选择配置
先定义可比较实验
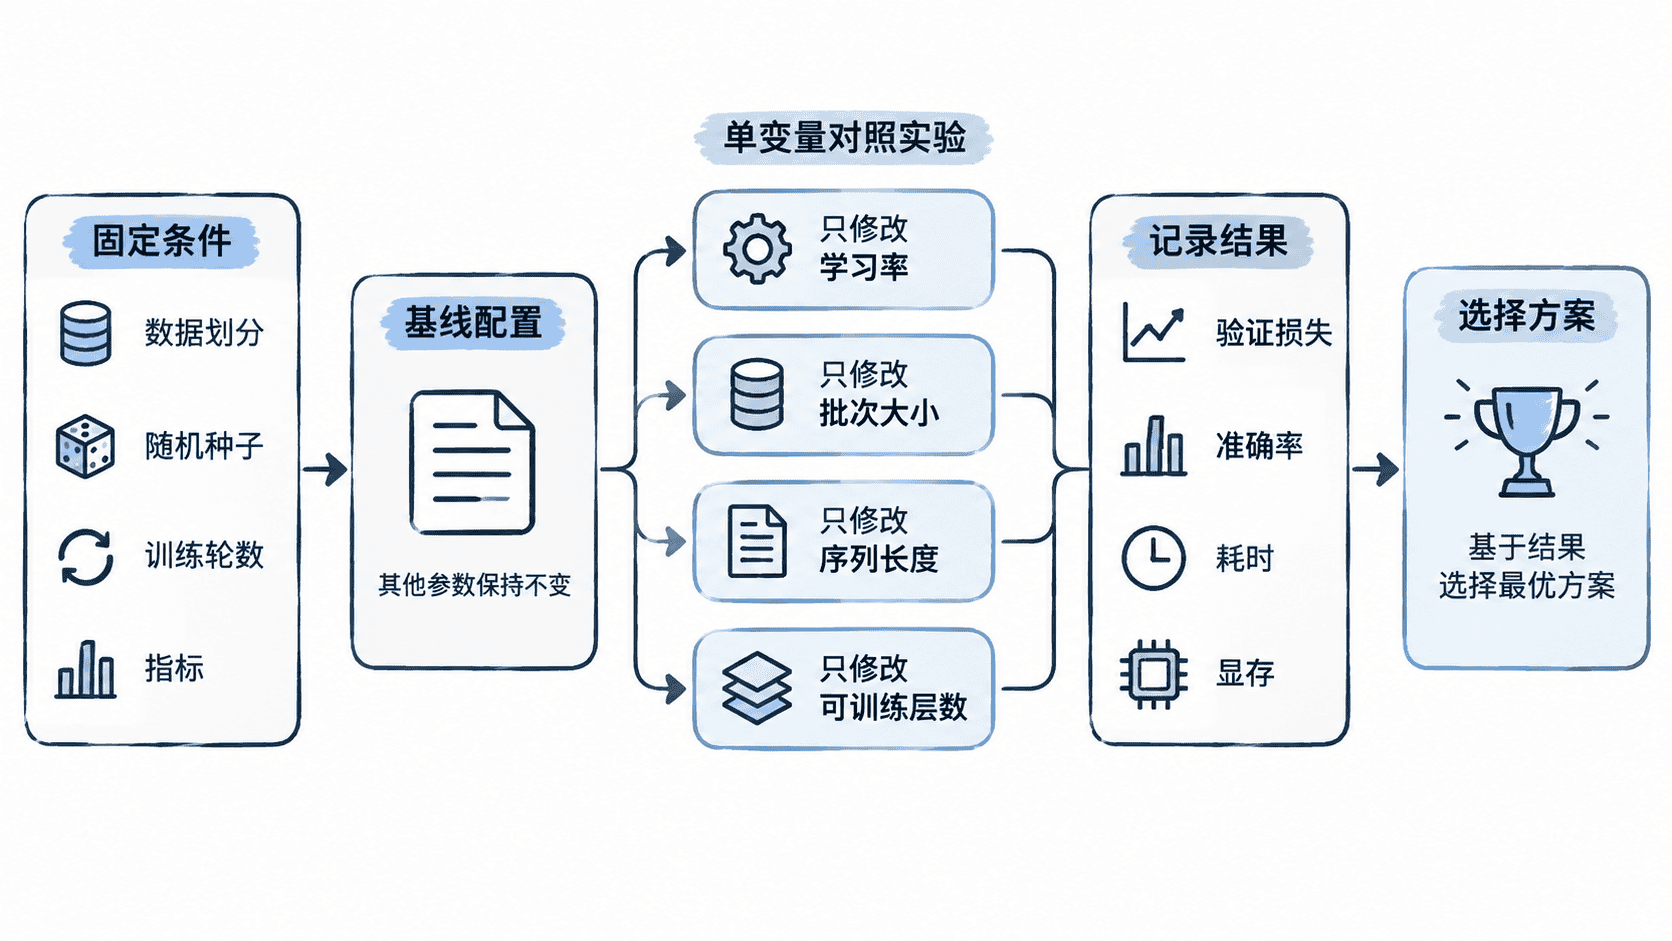
调参前先固定数据划分、随机种子、训练轮数、评价指标和硬件环境。否则两个实验即使参数不同,结果差异也可能来自样本顺序或初始化,而不是参数本身。
建议把一个稳定基线作为对照,只修改一个变量。学习率负责控制每次更新幅度,批次大小影响梯度估计与显存,序列长度决定可见上下文和计算量,可训练层数决定微调容量与过拟合风险。
| 实验项 | 基线值 | 对照值 | 主要观察指标 |
|---|---|---|---|
| 学习率 | 3e-4 |
1e-4、1e-3 |
收敛速度、验证损失 |
| 批次大小 | 32 |
16、64 |
稳定性、吞吐、显存 |
| 序列长度 | 64 |
32、128 |
准确率、单步耗时 |
| 可训练编码层 | 2 |
0、1 |
训练参数量、泛化能力 |
建立最小对照脚本
下面的脚本使用合成文本分类数据和一个小型 TransformerEncoder。它不是为了得到业务指标,而是为了验证实验方法:同一份数据、同一随机种子下,只改变命令行参数并输出可比较结果。
import argparse
import random
import time

import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

class TinyTransformerClassifier(nn.Module):
    def __init__(self, vocab_size: int, max_len: int, trainable_layers: int):
        super().__init__()
        hidden_size = 64
        self.embedding = nn.Embedding(vocab_size, hidden_size)
        self.position = nn.Embedding(max_len, hidden_size)
        encoder_layer = nn.TransformerEncoderLayer(
            d_model=hidden_size,
            nhead=4,
            dim_feedforward=128,
            batch_first=True,
        )
        self.encoder = nn.TransformerEncoder(encoder_layer, num_layers=2)
        self.classifier = nn.Linear(hidden_size, 2)

        # 先冻结全部编码层,再按需要解冻最后若干层
        for parameter in self.encoder.parameters():
            parameter.requires_grad = False
        if trainable_layers > 0:
            for layer in self.encoder.layers[-trainable_layers:]:
                for parameter in layer.parameters():
                    parameter.requires_grad = True

    def forward(self, input_ids: torch.Tensor) -> torch.Tensor:
        positions = torch.arange(input_ids.size(1), device=input_ids.device)
        hidden = self.embedding(input_ids) + self.position(positions)
        encoded = self.encoder(hidden)
        return self.classifier(encoded.mean(dim=1))

def build_dataset(samples: int, max_len: int, vocab_size: int) -> TensorDataset:
    input_ids = torch.randint(1, vocab_size, (samples, max_len))
    # 标签由首个 token 是否位于词表后半区决定,便于快速验证收敛
    labels = (input_ids[:, 0] >= vocab_size // 2).long()
    return TensorDataset(input_ids, labels)

def evaluate(model: nn.Module, loader: DataLoader, loss_fn: nn.Module) -> tuple[float, float]:
    model.eval()
    total_loss = 0.0
    correct = 0
    with torch.no_grad():
        for input_ids, labels in loader:
            logits = model(input_ids)
            total_loss += loss_fn(logits, labels).item() * labels.size(0)
            correct += (logits.argmax(dim=1) == labels).sum().item()
    return total_loss / len(loader.dataset), correct / len(loader.dataset)

def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--lr", type=float, default=3e-4)
    parser.add_argument("--batch-size", type=int, default=32)
    parser.add_argument("--max-len", type=int, default=64)
    parser.add_argument("--trainable-layers", type=int, choices=[0, 1, 2], default=2)
    parser.add_argument("--epochs", type=int, default=3)
    args = parser.parse_args()

    random.seed(42)
    torch.manual_seed(42)
    train_set = build_dataset(1024, args.max_len, 200)
    valid_set = build_dataset(256, args.max_len, 200)
    train_loader = DataLoader(train_set, batch_size=args.batch_size, shuffle=True)
    valid_loader = DataLoader(valid_set, batch_size=args.batch_size)
    model = TinyTransformerClassifier(200, args.max_len, args.trainable_layers)
    loss_fn = nn.CrossEntropyLoss()
    optimizer = torch.optim.AdamW(
        [parameter for parameter in model.parameters() if parameter.requires_grad],
        lr=args.lr,
    )

    started_at = time.perf_counter()
    for _ in range(args.epochs):
        model.train()
        for input_ids, labels in train_loader:
            optimizer.zero_grad()
            loss = loss_fn(model(input_ids), labels)
            loss.backward()
            optimizer.step()

    valid_loss, valid_accuracy = evaluate(model, valid_loader, loss_fn)
    elapsed = time.perf_counter() - started_at
    trainable = sum(p.numel() for p in model.parameters() if p.requires_grad)
    print(
        f"lr={args.lr} batch={args.batch_size} max_len={args.max_len} "
        f"layers={args.trainable_layers} valid_loss={valid_loss:.4f} "
        f"valid_accuracy={valid_accuracy:.4f} trainable={trainable} "
        f"elapsed={elapsed:.2f}s"
    )

if __name__ == "__main__":
    main()
将文件保存为 tune_compare.py,安装 PyTorch 后依次运行基线和四个单变量实验。首次安装的包版本与下载时间会因环境不同而变化。
python tune_compare.py --lr 3e-4 --batch-size 32 --max-len 64 --trainable-layers 2
python tune_compare.py --lr 1e-3 --batch-size 32 --max-len 64 --trainable-layers 2
python tune_compare.py --lr 3e-4 --batch-size 64 --max-len 64 --trainable-layers 2
python tune_compare.py --lr 3e-4 --batch-size 32 --max-len 128 --trainable-layers 2
python tune_compare.py --lr 3e-4 --batch-size 32 --max-len 64 --trainable-layers 1
预期输出格式如下。具体数值受 PyTorch 版本、CPU/GPU 和线程调度影响,因此用占位符表示动态结果。
lr=0.0003 batch=32 max_len=64 layers=2 valid_loss=<VAL_LOSS> valid_accuracy=<VAL_ACCURACY> trainable=<COUNT> elapsed=<SECONDS>s
lr=0.001 batch=32 max_len=64 layers=2 valid_loss=<VAL_LOSS> valid_accuracy=<VAL_ACCURACY> trainable=<COUNT> elapsed=<SECONDS>s
lr=0.0003 batch=64 max_len=64 layers=2 valid_loss=<VAL_LOSS> valid_accuracy=<VAL_ACCURACY> trainable=<COUNT> elapsed=<SECONDS>s
lr=0.0003 batch=32 max_len=128 layers=2 valid_loss=<VAL_LOSS> valid_accuracy=<VAL_ACCURACY> trainable=<COUNT> elapsed=<SECONDS>s
lr=0.0003 batch=32 max_len=64 layers=1 valid_loss=<VAL_LOSS> valid_accuracy=<VAL_ACCURACY> trainable=<COUNT> elapsed=<SECONDS>s
解读四个关键参数
学习率过小通常表现为训练损失下降缓慢,过大则可能震荡、发散或很快出现异常值。选择时优先看验证损失是否稳定下降,而不是只看最后一次训练准确率。
增大批次通常能提升吞吐并让梯度更平滑,但会占用更多显存,也可能需要同步调整学习率。显存不足时,可用梯度累积模拟较大的有效批次,而不是直接牺牲序列长度。
序列长度增加后,自注意力的计算和显存开销增长很快。只有当被截断的关键信息确实影响任务时,增加长度才可能带来收益;否则只是延长训练时间。
可训练层越多,模型适应任务的能力越强,但训练参数量和过拟合风险也越高。数据较少时,可先冻结编码层,只训练分类头,再逐步解冻最后一层或最后两层。
记录结果并作决策
每次实验至少记录配置、验证损失、主指标、训练耗时、峰值显存和异常现象。先排除明显不收敛或资源超限的方案,再在性能接近的候选中选择更稳定、更省资源的一项。
不要根据一次运行下结论。关键候选应使用不同随机种子重复两到三次,并比较均值与波动;如果提升小于随机波动,就不能视为可靠改进。
本课总结
- 可比较实验必须固定数据、种子、轮数和指标,并一次只改变一个核心变量
- 学习率决定更新幅度,批次和序列长度决定资源开销,可训练层数决定适应能力
- 最终选择应同时考虑验证指标、稳定性、耗时和显存,而不是只追求单次最高分
下一课预告
下一课将从训练损失长期不下降的现象出发,按数据、掩码、优化器、梯度和模型连接的顺序定位故障。