
大模型原理与训练 / 系统课时
文本生成微调
文本生成微调
本课完成一个最小可运行的文本生成微调任务:把“指令—回答”样本转换为自回归训练数据,只让回答部分参与损失计算,并用 Trainer 更新模型参数、验证生成入口。
学习目标
- 能设计适合指令生成或续写任务的训练样本
- 能正确构造
input_ids、attention_mask与labels - 能运行一次最小微调并完成基本验收
明确任务与样本格式
文本生成微调的输入不是单独的标签,而是一段可继续预测的文本。指令任务通常把任务说明、用户输入和目标回答拼成统一模板;续写任务则直接提供前文与后续文本。无论采用哪种形式,训练集中的样本结构必须保持一致。
一个实用的指令模板可以写成“任务、输入、回答”三段。推理时只提供前两段,让模型从“回答”位置继续生成。模板中的固定文字会占用上下文长度,因此应尽量稳定、简洁,并在训练与推理阶段保持一致。
设计监督信号
自回归模型在每个位置预测下一个词元。若把整段文本都复制到 labels,模型会同时学习复述提示词;若只希望优化回答质量,应把提示词对应的标签改为 -100,使损失函数忽略这些位置,同时把补齐位置也设为 -100。
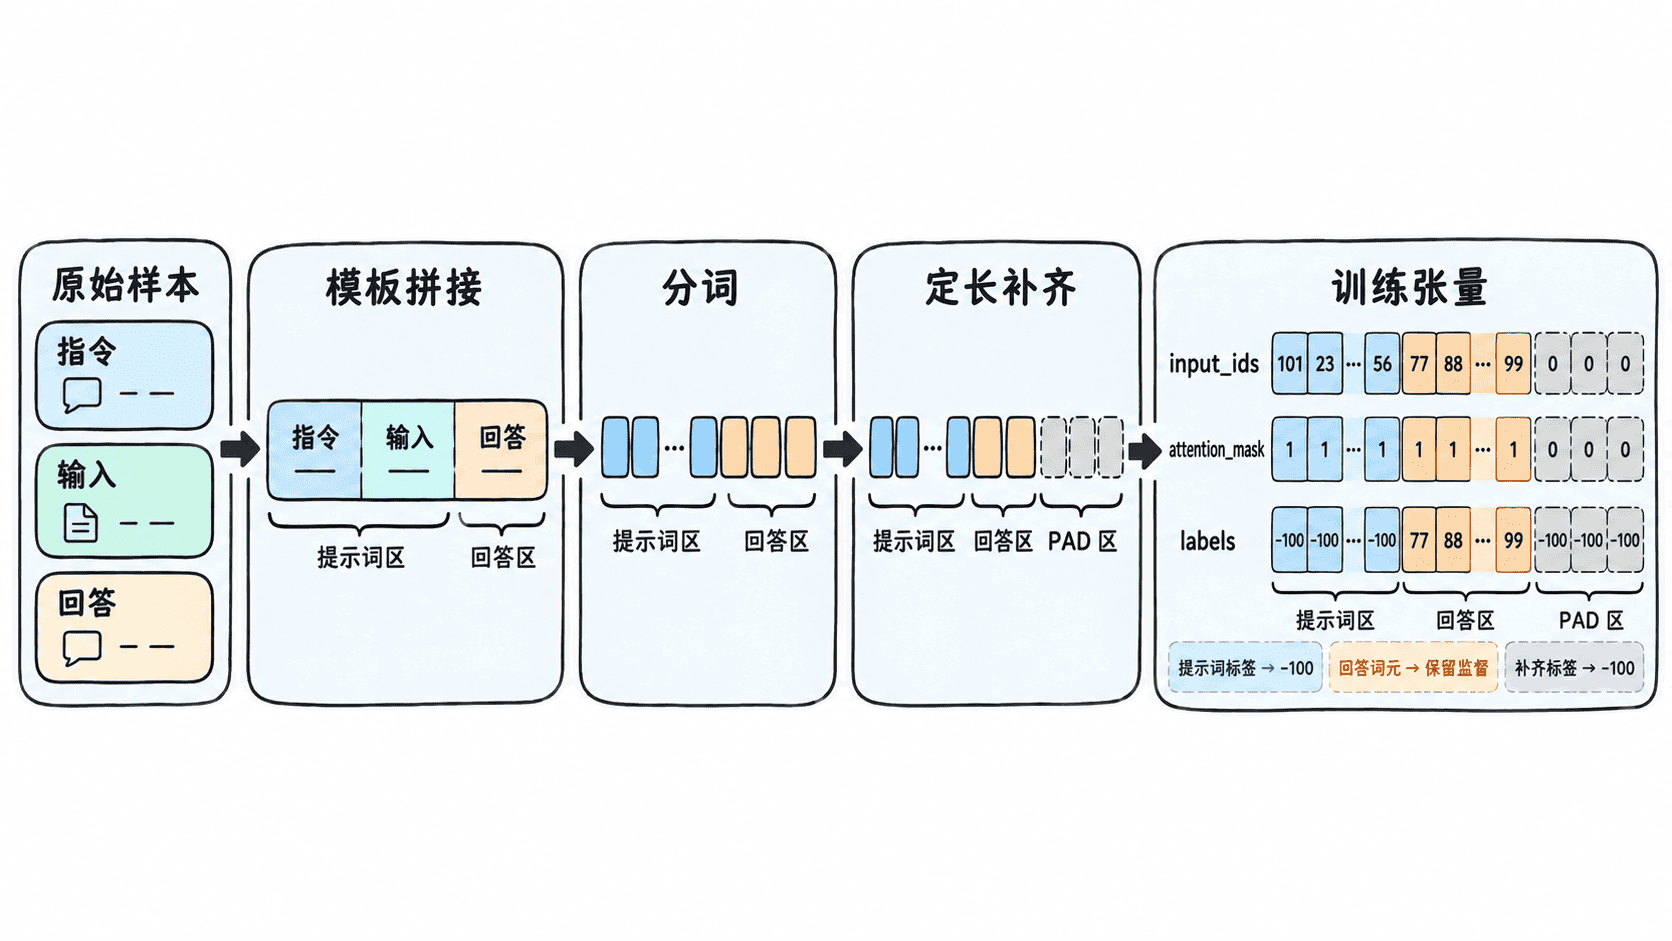
这种处理不会删除提示词。模型前向计算时仍能看到完整上下文,只是反向传播不会直接要求它预测提示词内容。若目标是普通语料续写,则可以保留全部非补齐词元的标签,让整段序列参与训练。
完成最小微调
下面示例使用一个体积很小的 GPT-2 测试模型,重点验证数据管道与训练流程。运行前需安装 torch、transformers、datasets 和 accelerate。真实项目应换成与语言、许可证和算力条件匹配的基础模型。
from datasets import Dataset
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    Trainer,
    TrainingArguments,
    default_data_collator,
)

MODEL_NAME = "sshleifer/tiny-gpt2"
MAX_LENGTH = 128

samples = [
    {"instruction": "概括句子", "input": "今天发布了新的课程目录。", "answer": "新的课程目录已发布。"},
    {"instruction": "改写为礼貌表达", "input": "把文件发给我。", "answer": "请把文件发送给我,谢谢。"},
    {"instruction": "续写一句", "input": "训练开始后,损失逐步下降,", "answer": "说明模型正在拟合当前数据。"},
]

raw_dataset = Dataset.from_list(samples)
tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token

def build_prompt(sample: dict) -> str:
    return (
        f"任务:{sample['instruction']}\n"
        f"输入:{sample['input']}\n"
        "回答:"
    )

def tokenize_sample(sample: dict) -> dict:
    # 提示词保留在输入中,但对应标签使用 -100 屏蔽。
    prompt_ids = tokenizer(
        build_prompt(sample), add_special_tokens=False
    )["input_ids"]
    answer_ids = tokenizer(
        sample["answer"] + tokenizer.eos_token,
        add_special_tokens=False,
    )["input_ids"]

    input_ids = (prompt_ids + answer_ids)[:MAX_LENGTH]
    labels = ([-100] * len(prompt_ids) + answer_ids)[:MAX_LENGTH]
    attention_mask = [1] * len(input_ids)

    # 定长补齐便于直接使用默认整理器组成批次。
    pad_length = MAX_LENGTH - len(input_ids)
    input_ids += [tokenizer.pad_token_id] * pad_length
    attention_mask += [0] * pad_length
    labels += [-100] * pad_length

    return {
        "input_ids": input_ids,
        "attention_mask": attention_mask,
        "labels": labels,
    }

train_dataset = raw_dataset.map(
    tokenize_sample,
    remove_columns=raw_dataset.column_names,
)
first = train_dataset[0]
print("样本数:", len(train_dataset))
print(
    "字段完整:",
    {"input_ids", "attention_mask", "labels"}.issubset(first),
)
print(
    "长度一致:",
    len(first["input_ids"]) == len(first["labels"]) == MAX_LENGTH,
)

model = AutoModelForCausalLM.from_pretrained(MODEL_NAME)
model.config.pad_token_id = tokenizer.pad_token_id

training_args = TrainingArguments(
    output_dir="./sft-output",
    per_device_train_batch_size=2,
    num_train_epochs=1,
    learning_rate=5e-5,
    save_strategy="no",
    logging_strategy="no",
    report_to="none",
    disable_tqdm=True,
    seed=42,
)

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=train_dataset,
    data_collator=default_data_collator,
    processing_class=tokenizer,
)
result = trainer.train()

prompt = build_prompt(
    {"instruction": "概括句子", "input": "本周完成模型微调。"}
)
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
generated = model.generate(
    **inputs,
    max_new_tokens=12,
    do_sample=False,
    pad_token_id=tokenizer.eos_token_id,
)
answer = tokenizer.decode(
    generated[0][inputs["input_ids"].shape[1]:],
    skip_special_tokens=True,
)
print("训练完成:", result.global_step > 0)
print("生成结果类型正确:", isinstance(answer, str))
预期输出
样本数: 3
字段完整: True
长度一致: True
训练完成: True
生成结果类型正确: True
首次运行会下载模型文件,实际路径和耗时因环境而异。该示例只训练三个样本,因此生成内容不代表真实效果;它的验收重点是样本字段完整、标签长度一致、训练步数大于零,并且生成接口能够返回字符串。
控制数据质量与训练边界
高质量生成微调首先依赖目标回答。回答中若混入提示词、无关解释或互相矛盾的格式,模型会稳定学习这些噪声。训练前应检查空回答、超长样本、重复样本和模板不一致,并确保结束词元能够保留在截断后的序列中。
最大长度过小时,回答可能被完全截断,只剩被屏蔽的提示词,最终没有有效监督信号。生产代码应统计每条样本中非 -100 标签的数量,过滤监督词元为零的记录,并按训练集、验证集和测试集隔离数据,避免同一内容跨集合重复。
本课总结
- 指令微调应保持训练模板与推理模板一致
-100可以屏蔽提示词和补齐位置,只让回答部分贡献损失- 最小验收应同时覆盖数据字段、标签长度、训练步数和生成入口
下一课预告
下一课将把数据集、数据整理器、训练参数和评估指标统一交给 Trainer,建立可评估、可保存并能恢复最佳检查点的标准训练流程。