
大模型原理与训练 / 系统课时
多头注意力动机
多头注意力动机
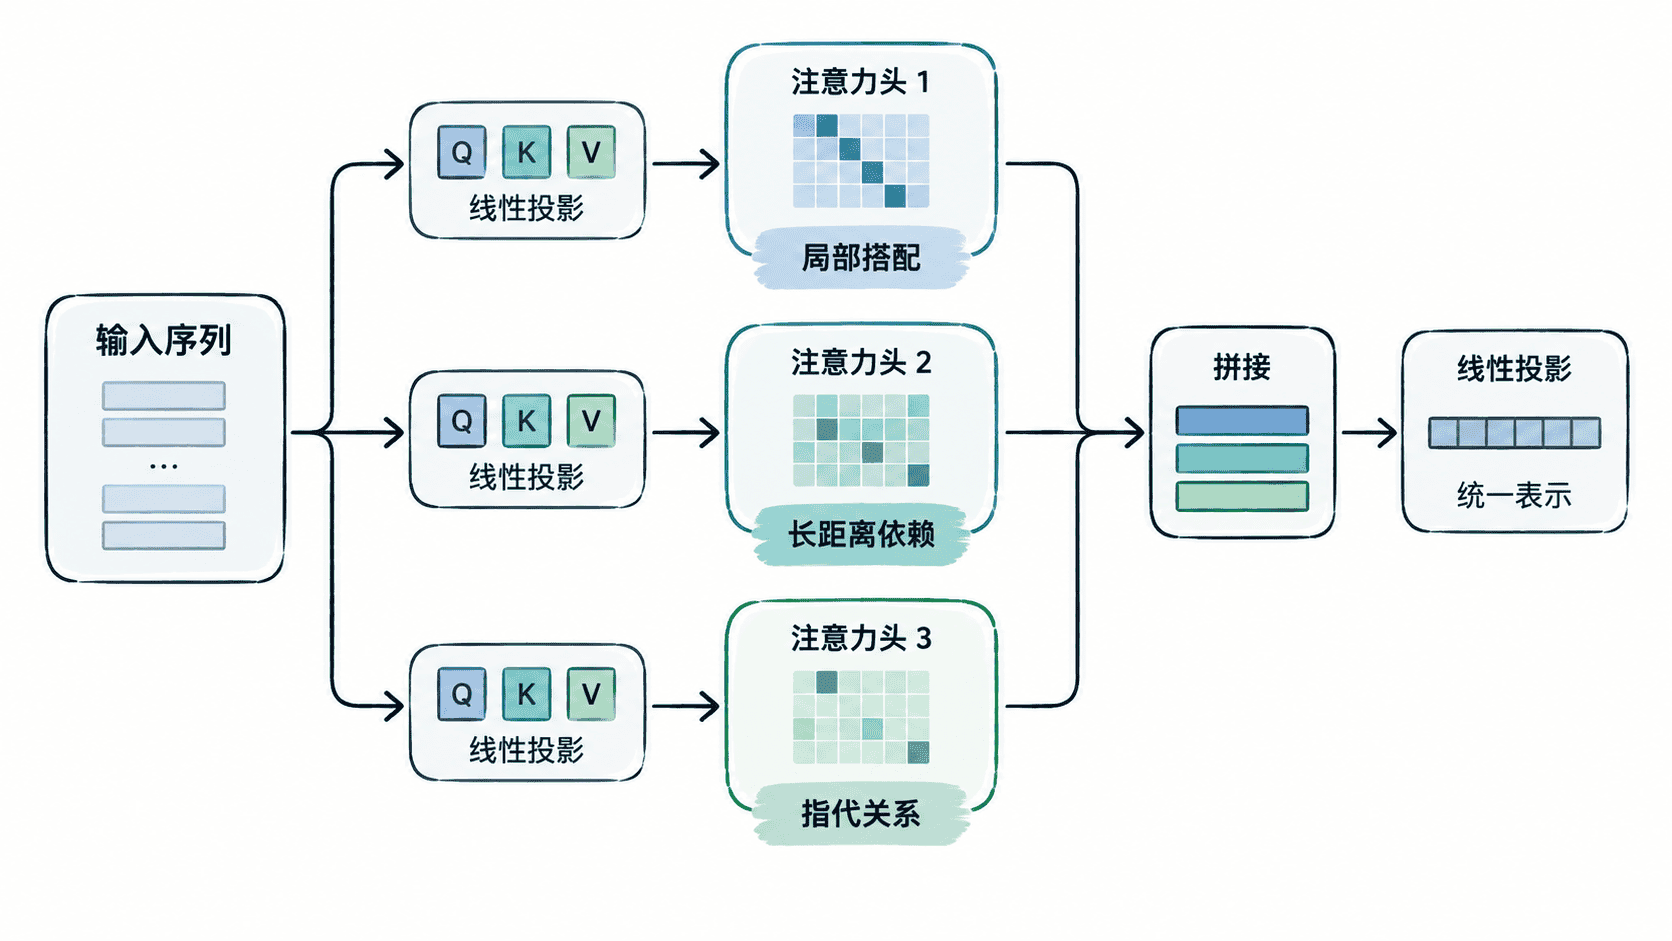
单个注意力头会把所有关系压缩到同一组相似度与同一套表示中,容易只突出一种关联。多头注意力通过并行建立多组查询、键和值,让模型分别关注语义、位置、指代或局部搭配,再把这些互补结果合并为统一表示。
学习目标
- 解释单头注意力在表达能力上的主要限制
- 理解多个注意力头如何形成不同表示子空间
- 判断多头结果为何需要合并与投影
单头注意力的限制
缩放点积注意力先计算查询与键的相似度,再对值做加权求和。若只使用一个注意力头,所有词元都共享同一组投影矩阵,模型必须在一次计算中同时处理多种关系。
例如句子“程序员修复了服务,因为它发生了异常”中,“它”可能需要关注“服务”;同时,“修复”还要关注动作对象,“异常”又要关注因果线索。单个头可以学习这些关系,但它们会竞争同一套注意力分布,表达空间容易相互干扰。
多个头如何分工
多头注意力为每个头准备独立的线性投影。第 个头使用自己的 、 和 ,先把输入映射到较低维的子空间,再独立计算注意力:
不同头没有被人工规定必须学习什么,但训练会推动它们形成有用的分工。有的头可能偏向相邻词元,有的头偏向长距离依赖,还有的头对句法角色或指代关系更敏感。
维度不变但表达更丰富
设模型维度为 ,头数为 。常见做法是让每个头的查询、键和值维度约为 。这样,多个头并不会简单地把计算维度扩大 倍,而是把总特征维度分配给多个并行子空间。
以 、 为例,每个头通常处理 64 维特征。八个头的结果拼接后仍回到 512 维,再经过输出矩阵 混合:
因此,多头机制的核心不是“重复八次相同计算”,而是“用八套不同投影观察同一输入”。
为什么还要输出投影
各个头独立计算后得到的特征仍按头分区。直接拼接只能把结果并排放置,不能充分建立头与头之间的组合关系。输出投影 会重新混合这些特征,使局部关系、长距离关系和语义信息进入同一表示。
多头数量也不是越多越好。头数过少可能限制关系类型,头数过多则会让每个头维度过小,增加计算与管理成本,并可能出现多个头学习到相似模式。实际设计需要同时考虑模型维度、任务复杂度和硬件效率。
易混淆点
“一个头只学习一种固定关系”并不准确。头的分工是训练结果,而不是人工规则;同一个头也可能在不同样本中表现出不同关注模式。
“多头注意力等于多个独立模型”也不准确。各个头共享同一批输入,并在拼接和输出投影后共同形成一个层的结果,训练时仍由统一损失函数联合优化。
本课总结
- 单头注意力需要在同一表示空间中竞争性地处理多种关系
- 多头注意力通过独立投影建立多个表示子空间,提取互补信息
- 拼接后的输出投影负责重新混合各头特征,形成统一表示
下一课预告
下一课将把多头注意力落实到张量形状,逐步追踪特征维度如何拆成多个头、并行计算后再合并回模型维度。