
大模型原理与训练 / 系统课时
保存与恢复检查点
保存与恢复检查点
本课实现一个可恢复训练的检查点机制:不仅保存模型权重,还保存优化器、学习率调度器、训练进度和随机数状态,并通过原子替换避免写入中断留下损坏文件。
学习目标
- 能确定断点续训必须保存的状态集合
- 能安全地保存并恢复模型、优化器和调度器
- 能避免重复训练、设备不一致和半写入文件等问题
检查点保存的不是只有权重
只保存 model.state_dict() 只能用于推理或重新开始训练。断点续训还需要优化器中的动量、调度器当前步数、下一个 epoch、全局步数以及随机数状态,否则恢复后的学习率、参数更新轨迹和数据顺序都会改变。
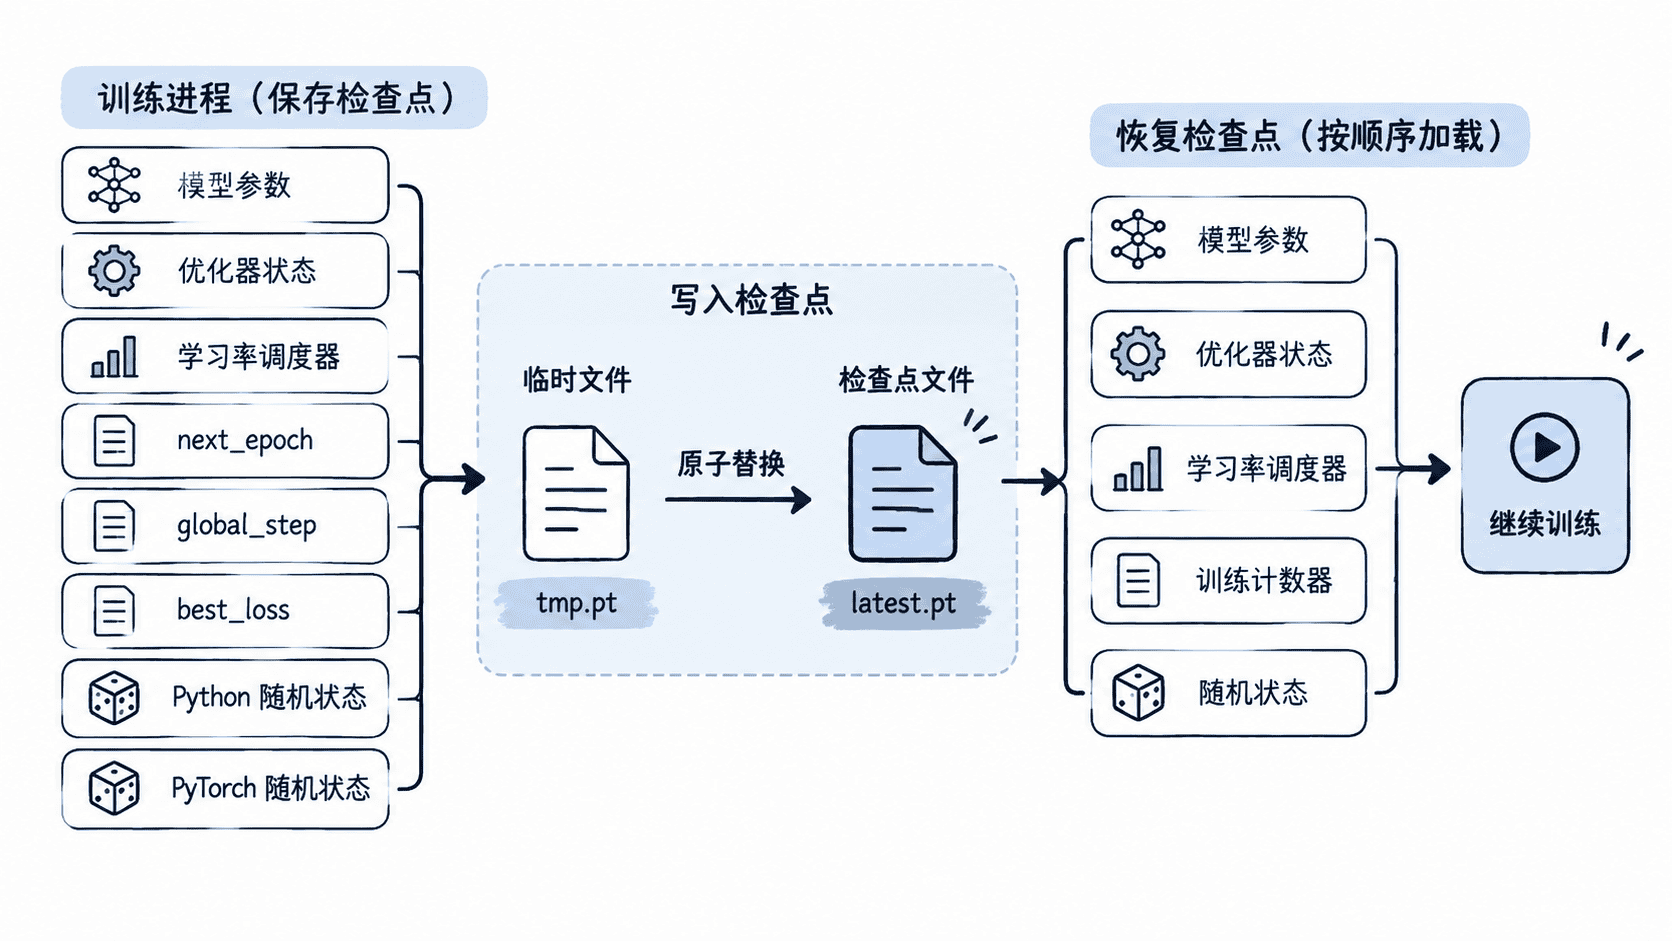
检查点最好在一个完整参数更新结束后保存,也就是 optimizer.step() 和 scheduler.step() 都已完成的稳定边界。恢复时从 next_epoch 或下一个 global_step 开始,避免把已经完成的批次再训练一次。
完整可运行示例
下面的示例先训练一个 epoch 并保存检查点,再创建全新的模型、优化器和调度器对象,加载状态后继续训练。示例使用 CPU 也能直接运行。
import os
import random
from pathlib import Path
from typing import Any

import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

class TinyRegressor(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(4, 16),
            nn.ReLU(),
            nn.Linear(16, 1),
        )

    def forward(self, features: torch.Tensor) -> torch.Tensor:
        return self.network(features)

def build_loader() -> DataLoader:
    generator = torch.Generator().manual_seed(11)
    features = torch.randn(32, 4, generator=generator)
    targets = features.sum(dim=1, keepdim=True)
    return DataLoader(TensorDataset(features, targets), batch_size=8, shuffle=False)

def train_one_epoch(
    model: nn.Module,
    loader: DataLoader,
    optimizer: torch.optim.Optimizer,
    scheduler: torch.optim.lr_scheduler.LRScheduler,
    global_step: int,
) -> tuple[float, int]:
    model.train()
    criterion = nn.MSELoss()
    total_loss = 0.0

    for features, targets in loader:
        optimizer.zero_grad(set_to_none=True)
        loss = criterion(model(features), targets)
        loss.backward()
        optimizer.step()
        scheduler.step()

        total_loss += loss.item()
        global_step += 1

    return total_loss / len(loader), global_step

def save_checkpoint(
    path: Path,
    model: nn.Module,
    optimizer: torch.optim.Optimizer,
    scheduler: torch.optim.lr_scheduler.LRScheduler,
    next_epoch: int,
    global_step: int,
    best_loss: float,
) -> None:
    path.parent.mkdir(parents=True, exist_ok=True)
    temporary_path = path.with_suffix(path.suffix + ".tmp")

    checkpoint: dict[str, Any] = {
        "schema_version": 1,
        "model": model.state_dict(),
        "optimizer": optimizer.state_dict(),
        "scheduler": scheduler.state_dict(),
        "next_epoch": next_epoch,
        "global_step": global_step,
        "best_loss": best_loss,
        "python_rng_state": random.getstate(),
        "torch_rng_state": torch.get_rng_state(),
    }

    # 先写临时文件,成功后再替换正式文件,降低半写入风险。
    torch.save(checkpoint, temporary_path)
    os.replace(temporary_path, path)

def load_checkpoint(
    path: Path,
    model: nn.Module,
    optimizer: torch.optim.Optimizer,
    scheduler: torch.optim.lr_scheduler.LRScheduler,
) -> tuple[int, int, float]:
    # weights_only=False 仅适合加载自己生成且可信的检查点。
    checkpoint = torch.load(path, map_location="cpu", weights_only=False)

    if checkpoint.get("schema_version") != 1:
        raise ValueError("unsupported checkpoint schema")

    model.load_state_dict(checkpoint["model"])
    optimizer.load_state_dict(checkpoint["optimizer"])
    scheduler.load_state_dict(checkpoint["scheduler"])
    random.setstate(checkpoint["python_rng_state"])
    torch.set_rng_state(checkpoint["torch_rng_state"])

    return (
        int(checkpoint["next_epoch"]),
        int(checkpoint["global_step"]),
        float(checkpoint["best_loss"]),
    )

def create_training_objects() -> tuple[
    TinyRegressor,
    torch.optim.Optimizer,
    torch.optim.lr_scheduler.LRScheduler,
]:
    model = TinyRegressor()
    optimizer = torch.optim.AdamW(model.parameters(), lr=1e-2)
    scheduler = torch.optim.lr_scheduler.StepLR(
        optimizer,
        step_size=4,
        gamma=0.5,
    )
    return model, optimizer, scheduler

def main() -> None:
    random.seed(5)
    torch.manual_seed(5)

    loader = build_loader()
    checkpoint_path = Path("checkpoints/latest.pt")

    model, optimizer, scheduler = create_training_objects()
    loss, global_step = train_one_epoch(
        model,
        loader,
        optimizer,
        scheduler,
        global_step=0,
    )
    save_checkpoint(
        checkpoint_path,
        model,
        optimizer,
        scheduler,
        next_epoch=1,
        global_step=global_step,
        best_loss=loss,
    )
    print(f"saved: next_epoch=1 global_step={global_step}")

    resumed_model, resumed_optimizer, resumed_scheduler = create_training_objects()
    start_epoch, global_step, best_loss = load_checkpoint(
        checkpoint_path,
        resumed_model,
        resumed_optimizer,
        resumed_scheduler,
    )
    print(
        f"loaded: next_epoch={start_epoch} "
        f"global_step={global_step} best_loss={best_loss:.4f}"
    )

    for epoch in range(start_epoch, 3):
        loss, global_step = train_one_epoch(
            resumed_model,
            loader,
            resumed_optimizer,
            resumed_scheduler,
            global_step,
        )
        best_loss = min(best_loss, loss)
        print(
            f"epoch={epoch + 1} global_step={global_step} "
            f"loss={loss:.4f} lr={resumed_scheduler.get_last_lr()[0]:.6f}"
        )

if __name__ == "__main__":
    main()
预期输出
saved: next_epoch=1 global_step=4
loaded: next_epoch=1 global_step=4 best_loss=<LOSS>
epoch=2 global_step=8 loss=<LOSS> lr=0.002500
epoch=3 global_step=12 loss=<LOSS> lr=0.001250
<LOSS> 会因 PyTorch 版本和底层算子略有差异。关键验证点是恢复后从 next_epoch=1、global_step=4 继续,最终步数递增到 12,而不是回到 0。
恢复顺序与设备处理
应先用与原训练一致的结构创建模型、优化器和调度器,再依次加载三者状态。优化器的参数组结构必须一致;如果恢复前改变了层数、参数分组或学习率规则,旧状态可能无法直接加载。
跨设备恢复时使用 map_location。示例统一加载到 CPU;若要继续在 GPU 上训练,应先把模型移动到目标设备,并确认优化器状态张量也位于同一设备。多卡训练还应只让主进程写文件,避免多个进程同时覆盖检查点。
保存策略与验证
实践中通常同时维护 latest.pt 和 best.pt。前者用于最近位置恢复,后者只在验证指标变好时更新。文件写完后可立即尝试加载,并检查 schema_version、关键字段和张量形状,尽早发现损坏或版本不兼容。
不要加载来源不明的检查点。torch.load(..., weights_only=False) 可能反序列化 Python 对象,只应对自己生成并可信的文件使用;仅做推理时,优先保存和加载纯权重状态。
常见失败
恢复后损失突然跳变,通常不是模型权重丢失,而是优化器或调度器没有恢复。恢复后重复一个 epoch,则多半是保存了“当前 epoch”而不是“下一个 epoch”。
直接覆盖正式文件会在磁盘写满、进程退出或机器断电时留下不完整文件。先写临时文件,再使用 os.replace() 原子替换,可显著降低这种风险,但仍应定期保留历史检查点。
本课总结
- 断点续训必须同时保存模型、优化器、调度器、训练进度和随机状态
- 检查点应在完整更新边界保存,并从下一个未完成位置恢复
- 临时文件加原子替换能降低检查点半写入和损坏风险
下一课预告
下一课将基于已完成的训练与检查点机制实现验证和推理流程,比较训练模式与推理模式下的行为差异。