
大模型原理与训练 / 系统课时
验证模型正确性
验证模型正确性
本课建立一套从低成本到高可信度的 Transformer 验证流程:先检查张量形状,再让模型过拟合一个极小样本,最后核对注意力权重的维度与归一化。完成这些检查后,能够更快区分结构错误、训练错误和掩码错误。
学习目标
- 使用断言验证编码器、解码器和输出层的关键形状
- 通过小样本过拟合判断前向传播与反向传播是否连通
- 检查注意力权重的形状、归一化和掩码行为
按顺序验证,而不是一次猜原因
验证应遵循“形状检查 → 小样本过拟合 → 注意力检查”的顺序。形状错误通常会直接暴露维度排列或投影配置问题;形状正确但无法过拟合,说明梯度、损失、目标右移或掩码仍可能有误;模型能过拟合后,再检查注意力权重是否符合预期。
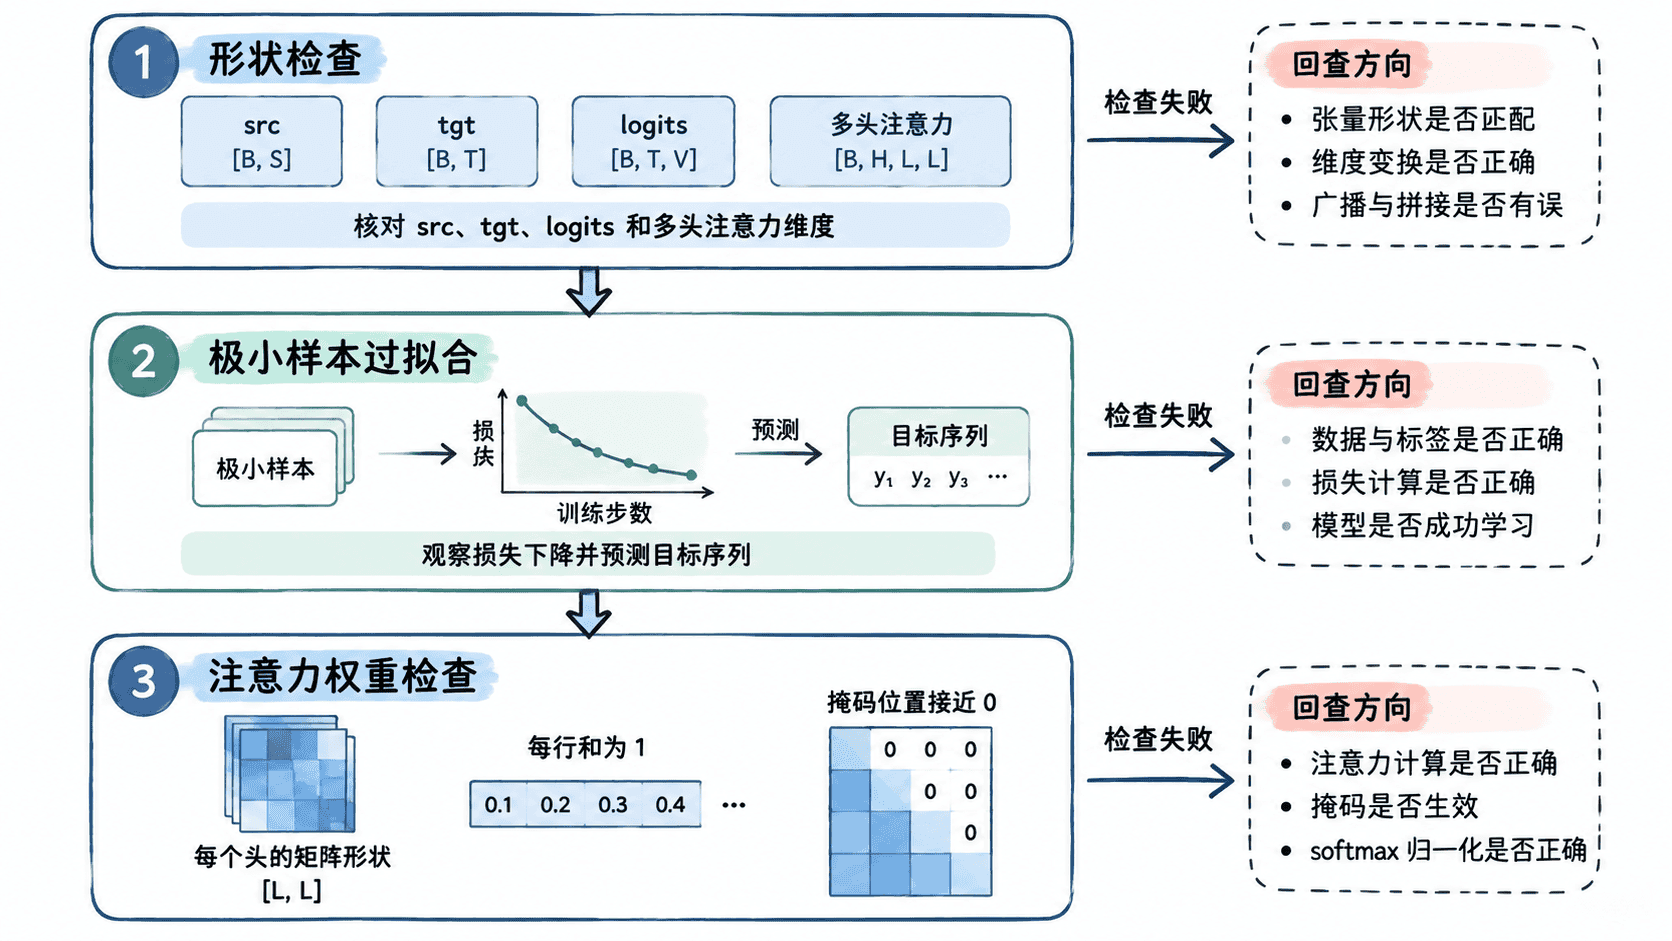
这三层不是互相替代。只检查输出形状无法证明模型会学习;只看到损失下降也无法证明注意力掩码正确。按层验证能让错误定位更稳定。
运行一套最小验证脚本
下面的脚本构建一个单层、无 Dropout 的微型 Transformer。它先检查输出形状,再用同一条样本训练 300 步,最后读取模型真实编码器层的多头注意力权重进行检查。
import torch
from torch import nn

torch.manual_seed(7)

class TinyTransformer(nn.Module):
    def __init__(
        self,
        vocab_size: int = 12,
        d_model: int = 16,
    ) -> None:
        super().__init__()
        self.vocab_size = vocab_size
        self.src_embed = nn.Embedding(vocab_size, d_model)
        self.tgt_embed = nn.Embedding(vocab_size, d_model)
        self.position = nn.Parameter(
            torch.zeros(1, 16, d_model)
        )
        self.core = nn.Transformer(
            d_model=d_model,
            nhead=2,
            num_encoder_layers=1,
            num_decoder_layers=1,
            dim_feedforward=32,
            dropout=0.0,
            batch_first=True,
        )
        self.output = nn.Linear(d_model, vocab_size)

    def forward(
        self,
        src: torch.Tensor,
        tgt_in: torch.Tensor,
    ) -> torch.Tensor:
        src_hidden = (
            self.src_embed(src)
            + self.position[:, : src.size(1)]
        )
        tgt_hidden = (
            self.tgt_embed(tgt_in)
            + self.position[:, : tgt_in.size(1)]
        )
        tgt_len = tgt_in.size(1)
        # True 表示被屏蔽,确保目标位置不能读取未来词元。
        causal_mask = torch.triu(
            torch.ones(
                tgt_len,
                tgt_len,
                dtype=torch.bool,
                device=tgt_in.device,
            ),
            diagonal=1,
        )
        hidden = self.core(
            src_hidden,
            tgt_hidden,
            tgt_mask=causal_mask,
        )
        return self.output(hidden)

model = TinyTransformer()
src = torch.tensor([[1, 5, 6, 2]], dtype=torch.long)
tgt_in = torch.tensor([[1, 7, 8]], dtype=torch.long)
tgt_out = torch.tensor([[7, 8, 2]], dtype=torch.long)

# 形状应为批次、目标长度、词表大小。
logits = model(src, tgt_in)
shape_ok = logits.shape == (1, 3, 12)

optimizer = torch.optim.Adam(
    model.parameters(),
    lr=0.03,
)
loss_fn = nn.CrossEntropyLoss()
with torch.no_grad():
    initial_loss = loss_fn(
        logits.reshape(-1, model.vocab_size),
        tgt_out.reshape(-1),
    ).item()

# 单一样本应被快速记住,用于验证梯度和目标对齐。
for _ in range(300):
    optimizer.zero_grad()
    logits = model(src, tgt_in)
    loss = loss_fn(
        logits.reshape(-1, model.vocab_size),
        tgt_out.reshape(-1),
    )
    loss.backward()
    optimizer.step()

model.eval()
with torch.no_grad():
    final_logits = model(src, tgt_in)
    final_loss = loss_fn(
        final_logits.reshape(-1, model.vocab_size),
        tgt_out.reshape(-1),
    ).item()
    prediction = final_logits.argmax(dim=-1)
    overfit_ok = (
        final_loss < 0.05
        and torch.equal(prediction, tgt_out)
    )

    # 直接读取模型真实编码器层的自注意力参数。
    src_hidden = (
        model.src_embed(src)
        + model.position[:, : src.size(1)]
    )
    encoder_layer = model.core.encoder.layers[0]
    _, attention_weights = encoder_layer.self_attn(
        src_hidden,
        src_hidden,
        src_hidden,
        need_weights=True,
        average_attn_weights=False,
    )
    attention_shape_ok = (
        attention_weights.shape == (1, 2, 4, 4)
    )
    attention_normalized = torch.allclose(
        attention_weights.sum(dim=-1),
        torch.ones_like(
            attention_weights.sum(dim=-1)
        ),
        atol=1e-6,
    )

print("shape_ok:", shape_ok)
print("loss_decreased:", final_loss < initial_loss)
print("prediction:", prediction.tolist())
print("overfit_ok:", overfit_ok)
print("attention_shape_ok:", attention_shape_ok)
print("attention_normalized:", attention_normalized)
预期输出
shape_ok: True
loss_decreased: True
prediction: [[7, 8, 2]]
overfit_ok: True
attention_shape_ok: True
attention_normalized: True
不同 PyTorch 版本和硬件上的具体损失值可能不同,因此脚本只输出稳定的布尔判断。若 overfit_ok 为真,说明在这个最小样本上,嵌入、位置参数、编码器、解码器、输出投影和反向传播能够协同工作。
如何解读失败结果
shape_ok 为假时,先核对是否统一使用 batch_first=True。常见错误是把 [batch, length, hidden] 与 [length, batch, hidden] 混用,或输出层没有映射到词表大小。
loss_decreased 为真但 overfit_ok 为假时,先增加训练步数,再检查目标右移。解码器输入应为 tgt_in=[BOS, y_1, y_2],监督目标应为 tgt_out=[y_1, y_2, EOS],两者长度相同但错开一位。
若损失几乎不下降,应检查是否遗漏 optimizer.zero_grad()、是否在训练阶段错误使用 torch.no_grad()、参数是否传入优化器,以及因果掩码是否把对角线也屏蔽了。
注意力权重还要检查什么
多头注意力权重通常形如 [batch, heads, query_len, key_len]。最后一维表示当前查询位置对所有键位置的分配,因此每一行的和应接近 1。上例没有填充掩码,所以只验证形状与归一化。
加入源序列 PAD 后,应进一步检查被屏蔽列的权重是否接近 0。检查解码器自注意力时,还要确认因果掩码右上角区域接近 0;若未来位置出现明显权重,模型可能在训练中偷看答案。
提示: 注意力图“看起来合理”不是正确性的充分条件。优先验证可计算的不变量,例如形状、行和、掩码位置和是否产生 NaN,再把可视化用于理解模型行为。
本课总结
- 形状断言用于发现维度与投影错误,小样本过拟合用于验证完整训练链路
- 一个健康的最小实现应能快速记住单一样本,并输出与监督目标一致的词元
- 注意力权重应满足正确形状、每行归一化,以及被掩码位置权重接近 0
下一课预告
下一课可以在通过基础正确性验证后,引入真实数据、评估指标和批量推理,对完整 Transformer 实现进行端到端测试。