
大模型原理与训练 / 系统课时
显存不足排查
显存不足排查
训练 Transformer 时出现 CUDA out of memory,不能只靠反复清缓存。本课建立一套从确认现象、定位显存构成,到缩短序列、减小微批次、梯度累积和混合精度的排查顺序,最终得到可验证的稳定训练配置。
学习目标
- 区分真正的 GPU 显存不足与主机内存、驱动或显存碎片问题
- 按收益顺序调整序列长度、微批次、梯度累积和混合精度
- 使用最小训练脚本验证优化是否生效,并记录可复现参数
先确认是否真是显存不足
典型报错包含 CUDA out of memory、申请字节数、已分配显存和剩余显存。若进程被系统直接终止并出现 Killed,更可能是主机内存不足;若报错来自驱动重置或非法访问,则应先检查 CUDA、驱动和算子兼容性。
先在训练开始前和报错后各执行一次显存查询,观察是否存在其他进程长期占用,以及当前进程的显存是否持续增长。
nvidia-smi --query-compute-apps=pid,process_name,used_memory --format=csv预期输出如下,实际进程号和显存值会不同:
pid, process_name, used_gpu_memory [MiB]
<ID>, python, <GPU_MB> MiB
若同一张卡上有无关进程,应先停止或迁移这些进程。若只有当前训练进程占满显存,再进入参数优化,不要把 torch.cuda.empty_cache() 当作根治方案;它只能释放未被张量引用的缓存。
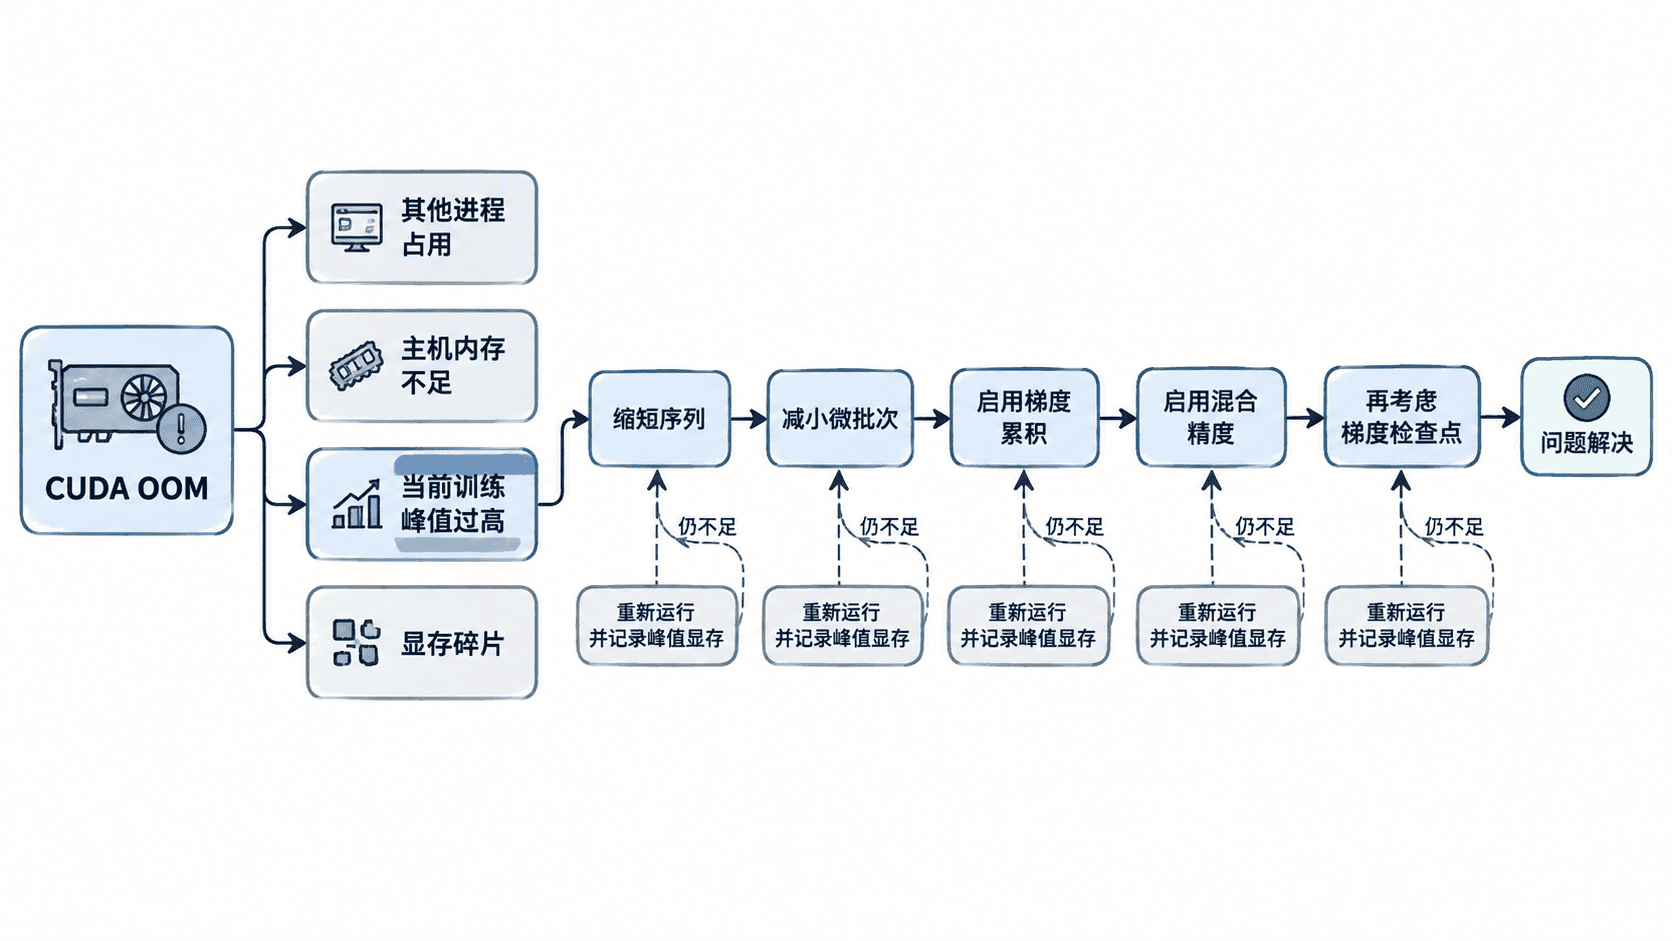
按收益顺序缩减峰值显存
序列长度通常是首要变量。自注意力需要构造与序列长度平方相关的中间结果,长度从 1024 降到 512,注意力矩阵部分的显存压力通常会显著下降。应先确认任务是否真的需要最大长度,并检查数据整理阶段是否把大量填充位置也送入模型。
随后减小单次前向传播的微批次。梯度累积可以在微批次变小后维持近似的有效批次大小,其关系为:有效批次大小等于微批次大小乘以累积步数再乘以数据并行进程数。梯度累积不会降低单个微批次本身的显存,只是让更小的微批次仍能达到目标有效批次。
混合精度会让部分张量使用 FP16 或 BF16,通常能降低激活和梯度占用。支持 BF16 的硬件优先使用 BF16,因为它的数值范围更接近 FP32;使用 FP16 时应配合梯度缩放,避免小梯度下溢。
主示例:组合微批次、梯度累积与混合精度
下面的脚本构造一个最小 Transformer 编码器训练过程。它把微批次设为 2,累积 4 次后再更新参数,因此单卡有效批次为 8;检测到 CUDA 时自动启用混合精度。
import torch
from torch import nn

torch.manual_seed(7)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

vocab_size = 2000
seq_len = 256
micro_batch = 2
accumulation_steps = 4

class TinyTransformer(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, 256)
        layer = nn.TransformerEncoderLayer(
            d_model=256,
            nhead=8,
            dim_feedforward=1024,
            batch_first=True,
        )
        self.encoder = nn.TransformerEncoder(layer, num_layers=2)
        self.output = nn.Linear(256, vocab_size)

    def forward(self, token_ids: torch.Tensor) -> torch.Tensor:
        hidden = self.embedding(token_ids)
        return self.output(self.encoder(hidden))

model = TinyTransformer().to(device)
optimizer = torch.optim.AdamW(model.parameters(), lr=3e-4)
use_amp = device.type == "cuda"
scaler = torch.amp.GradScaler("cuda", enabled=use_amp)

optimizer.zero_grad(set_to_none=True)
print(
    f"device={device.type}, micro_batch={micro_batch}, "
    f"effective_batch={micro_batch * accumulation_steps}"
)

for micro_step in range(1, accumulation_steps + 1):
    inputs = torch.randint(0, vocab_size, (micro_batch, seq_len), device=device)
    targets = torch.randint(0, vocab_size, (micro_batch, seq_len), device=device)

    # 损失除以累积步数,保证累积后的梯度尺度与大批次接近
    with torch.amp.autocast(
        device_type=device.type,
        dtype=torch.float16,
        enabled=use_amp,
    ):
        logits = model(inputs)
        loss = nn.functional.cross_entropy(
            logits.reshape(-1, vocab_size),
            targets.reshape(-1),
        )
        scaled_loss = loss / accumulation_steps

    scaler.scale(scaled_loss).backward()

    if micro_step == accumulation_steps:
        # 只在完成全部微批次后更新一次参数
        scaler.step(optimizer)
        scaler.update()
        optimizer.zero_grad(set_to_none=True)

    allocated_mb = (
        torch.cuda.max_memory_allocated() / 1024**2 if use_amp else 0.0
    )
    print(
        f"micro_step={micro_step}, loss={loss.item():.4f}, "
        f"peak_memory_mb={allocated_mb:.1f}"
    )
预期输出如下。损失值和 GPU 峰值因设备而异;在 CPU 上峰值字段为 0.0:
device=<DEVICE>, micro_batch=2, effective_batch=8
micro_step=1, loss=<LOSS>, peak_memory_mb=<GPU_MB>
micro_step=2, loss=<LOSS>, peak_memory_mb=<GPU_MB>
micro_step=3, loss=<LOSS>, peak_memory_mb=<GPU_MB>
micro_step=4, loss=<LOSS>, peak_memory_mb=<GPU_MB>
验证时应把调整前后的 seq_len、micro_batch、累积步数、精度模式和峰值显存一起记录。只比较“是否报错”不足以判断方案是否稳定,因为更长样本可能在后续批次再次触发峰值。
仍然不足时检查隐藏占用
如果基础参数已经压缩,仍需检查训练代码是否保留了计算图。例如把带梯度的 loss 或模型输出直接追加到列表,会让历史图无法释放;记录指标时应使用 loss.item() 或 tensor.detach()。验证和推理阶段应使用 torch.inference_mode(),否则也会保存不必要的中间状态。
优化器状态同样占用显存。AdamW 通常需要维护一阶和二阶动量,大模型下这部分可能超过激活显存。此时可考虑梯度检查点、参数高效微调、优化器状态分片或多卡并行,但这些方案会增加计算时间或工程复杂度,应在前四项优化无效后再采用。
若报错信息显示“已保留显存远大于已分配显存”,可能存在碎片。可在启动进程前设置 PyTorch 的 CUDA 分配器参数,并重新启动训练进程验证;不要在同一进程里频繁试错后据此判断最终显存需求。以下为片段示例,依赖项目已有的 train.py 训练入口。
export PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True
python train.py
预期结果:
训练进程重新启动;若根因是碎片,原本在相近峰值处失败的批次可继续执行。修复后的验收标准
修复完成后,至少连续跑过一个包含最长样本的训练区间,并确认峰值显存留有安全余量。建议保留 5%~10% 的空闲显存,以吸收数据长度波动、评估阶段切换和框架临时缓冲区带来的峰值。
同时确认有效批次大小没有被意外改变。若微批次从 8 降到 2,而累积步数仍为 1,训练动态已经变化,学习率和收敛结果不能与原配置直接比较。
本课总结
- 显存不足应先确认占用来源,再按序列长度、微批次、梯度累积和混合精度的顺序处理
- 梯度累积用于维持有效批次,真正降低单步峰值的是更小微批次和更短序列
- 修复必须通过最长样本、峰值显存和有效批次三项共同验收
下一课预告
下一课将处理生成阶段的重复输出、空输出、乱码和无法停止问题,并把异常现象映射到可验证的解码与分词配置。