
大模型原理与训练 / 系统课时
稀疏注意力
稀疏注意力
标准自注意力允许任意两个词元直接交互,但序列越长,注意力矩阵的计算量和显存占用增长越快。本课将通过局部注意力、滑动窗口和结构化稀疏模式,理解如何减少无效连接,同时保留长文本中的关键信息传递能力。
学习目标
- 说明稀疏注意力要解决的计算与显存问题
- 区分局部、滑动窗口和结构化稀疏注意力
- 根据任务中的信息依赖范围选择合适的稀疏模式
从全连接注意力到稀疏连接
长度为 的序列会产生一个 的注意力矩阵。标准自注意力需要计算所有查询与所有键之间的相关性,因此时间复杂度和注意力权重的空间复杂度通常都是 。
稀疏注意力的核心不是降低向量维度,而是限制每个查询能够访问的键。模型只计算预先允许的连接,其余位置通过掩码排除。若每个词元只关注固定数量 的邻居,主要计算量可近似降为 。
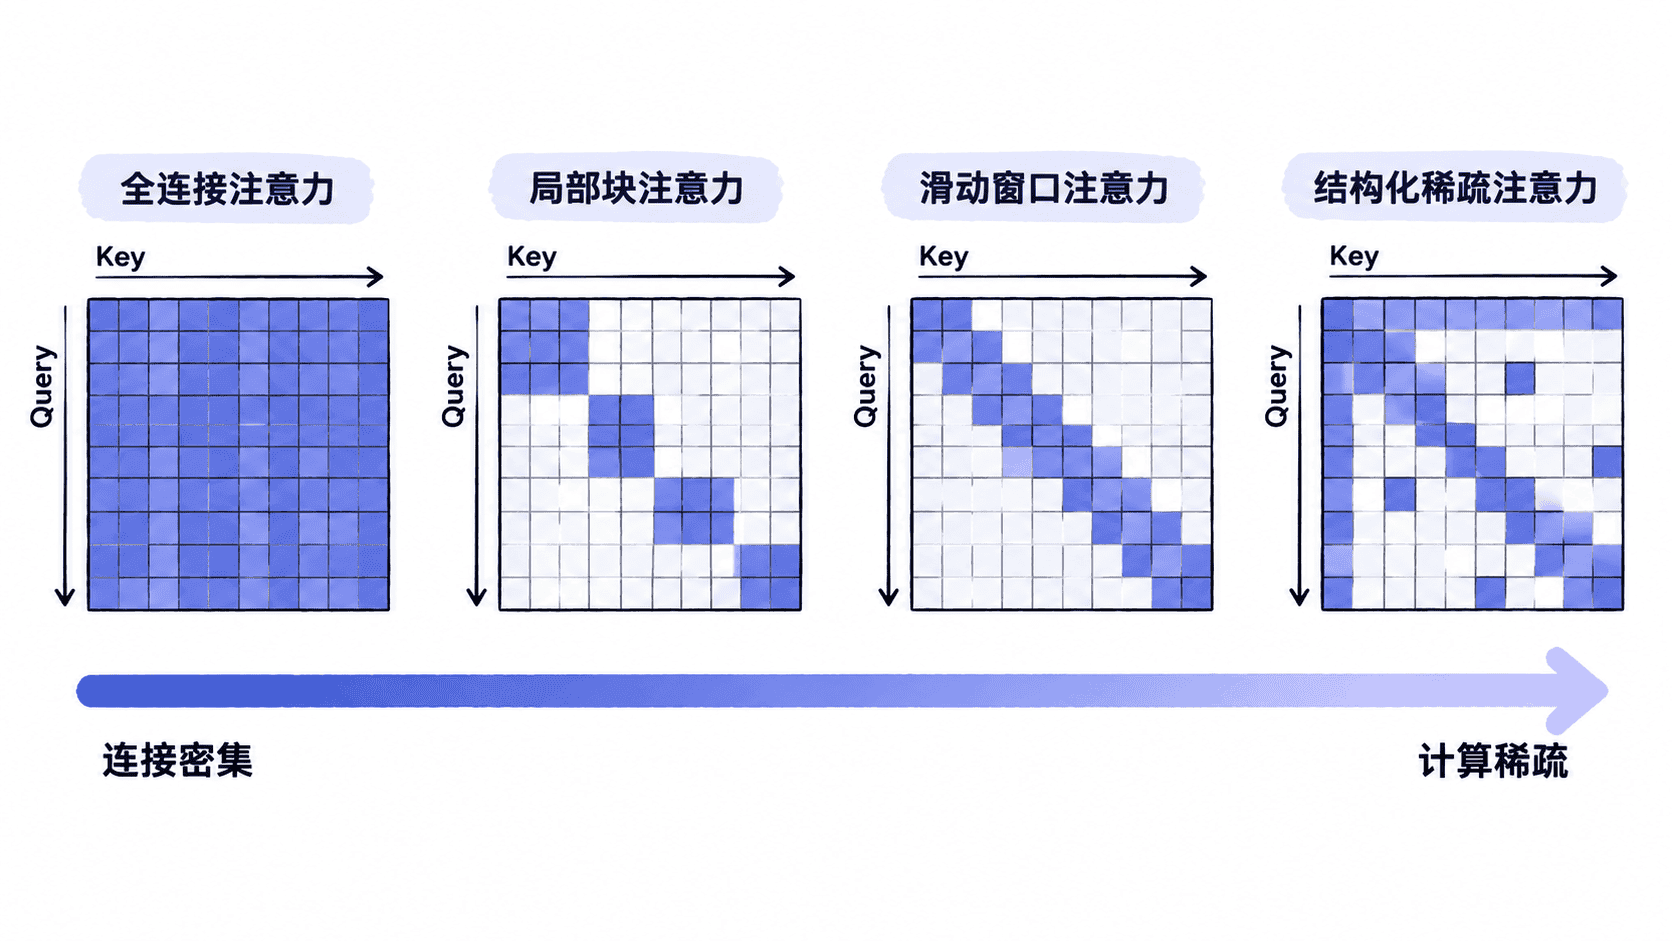
三种典型设计
局部注意力
局部注意力把序列划分为若干块,块内词元可以互相关注,块间默认不连接。它适合图像分块、音频片段以及局部语义占主导的文本任务,优点是结构简单、容易并行。
局限也很明显:位于不同块中的词元无法直接交换信息。若连续堆叠多层,信息可以逐层传播到远处,但传播路径会变长,边界附近的上下文也可能被人为切断。
滑动窗口注意力
滑动窗口不设置固定块边界,而是让每个词元关注前后一定范围内的位置。例如窗口宽度为 256 时,一个词元只与附近约 256 个词元建立连接。
相邻窗口彼此重叠,因此信息能够随着网络层数增加逐步传播。它比固定分块更平滑,常用于长文档建模,但距离很远的两个位置仍需经过多层才能建立间接联系。
结构化稀疏注意力
结构化稀疏注意力会组合多种连接规则,例如局部窗口、固定步长连接、随机连接和全局词元。全局词元可以访问整个序列,也可以被所有位置访问,常用于承载标题、分类标记或任务指令。
这种设计可以在较低计算量下缩短远距离信息的传递路径,但稀疏结构需要与任务匹配。规则过于固定时,模型可能无法访问真正重要的位置。
如何选择稀疏模式
| 任务特征 | 更合适的模式 | 主要原因 |
|---|---|---|
| 信息主要集中在邻近位置 | 局部注意力 | 计算规则简单,局部建模效率高 |
| 局部依赖连续且不希望出现块边界 | 滑动窗口 | 重叠窗口可平滑传递上下文 |
| 同时存在局部细节与远程依赖 | 结构化稀疏注意力 | 可加入全局位置或跨块连接 |
| 关键位置无法提前判断 | 标准注意力或动态稀疏方案 | 固定掩码可能遗漏重要关系 |
窗口并不是越小越好。窗口过小会切断依赖,窗口过大又会削弱节省计算的效果。实际设计时应结合平均输入长度、任务依赖范围、网络层数以及硬件对稀疏算子的支持情况共同决定。
容易混淆的边界
稀疏注意力减少的是注意力连接数量,不代表整个 Transformer 的计算都按相同比例下降。词嵌入、前馈网络、归一化以及数据搬运仍然会消耗时间和显存。
理论复杂度降低也不一定立即带来实际加速。如果底层框架先生成完整矩阵再应用稀疏掩码,计算仍接近密集注意力。只有使用真正跳过无效连接的稀疏内核,才能充分获得收益。
本课总结
- 稀疏注意力通过限制可见位置,将注意力计算从全连接改为选择性连接
- 局部块、滑动窗口和结构化稀疏模式分别适合不同的信息依赖范围
- 稀疏规则必须兼顾理论复杂度、远程信息传递能力和底层算子支持
下一课预告
下一课将学习混合专家模型,理解它如何通过路由器为不同词元选择少量专家,在控制单次计算量的同时扩大模型参数规模。