
大模型原理与训练 / 系统课时
键值缓存
键值缓存
自回归生成每次只新增一个 token,但普通实现会反复计算整段历史的注意力键和值。KV Cache 把已经得到的 Key 和 Value 保存下来,让后续步骤只处理新 token,从而显著降低解码延迟。
学习目标
- 解释自回归解码中重复计算发生在哪里
- 理解 prefill 与 decode 阶段如何读写 KV Cache
- 判断 KV Cache 的速度收益、显存成本和失效边界
为什么历史键值可以复用
在因果自注意力中,第 个位置只能关注自己及之前的位置。历史 token 的隐藏状态在推理时不会被未来 token 改写,因此它们经过线性映射得到的 Key 和 Value 也保持不变。
没有缓存时,生成第 个 token 会再次为前面所有 token 计算 K、V,并重新执行整段序列的注意力。使用缓存后,只需为最新 token 计算新的 Q、K、V,再让新 Query 与缓存中的全部 Key 做匹配。
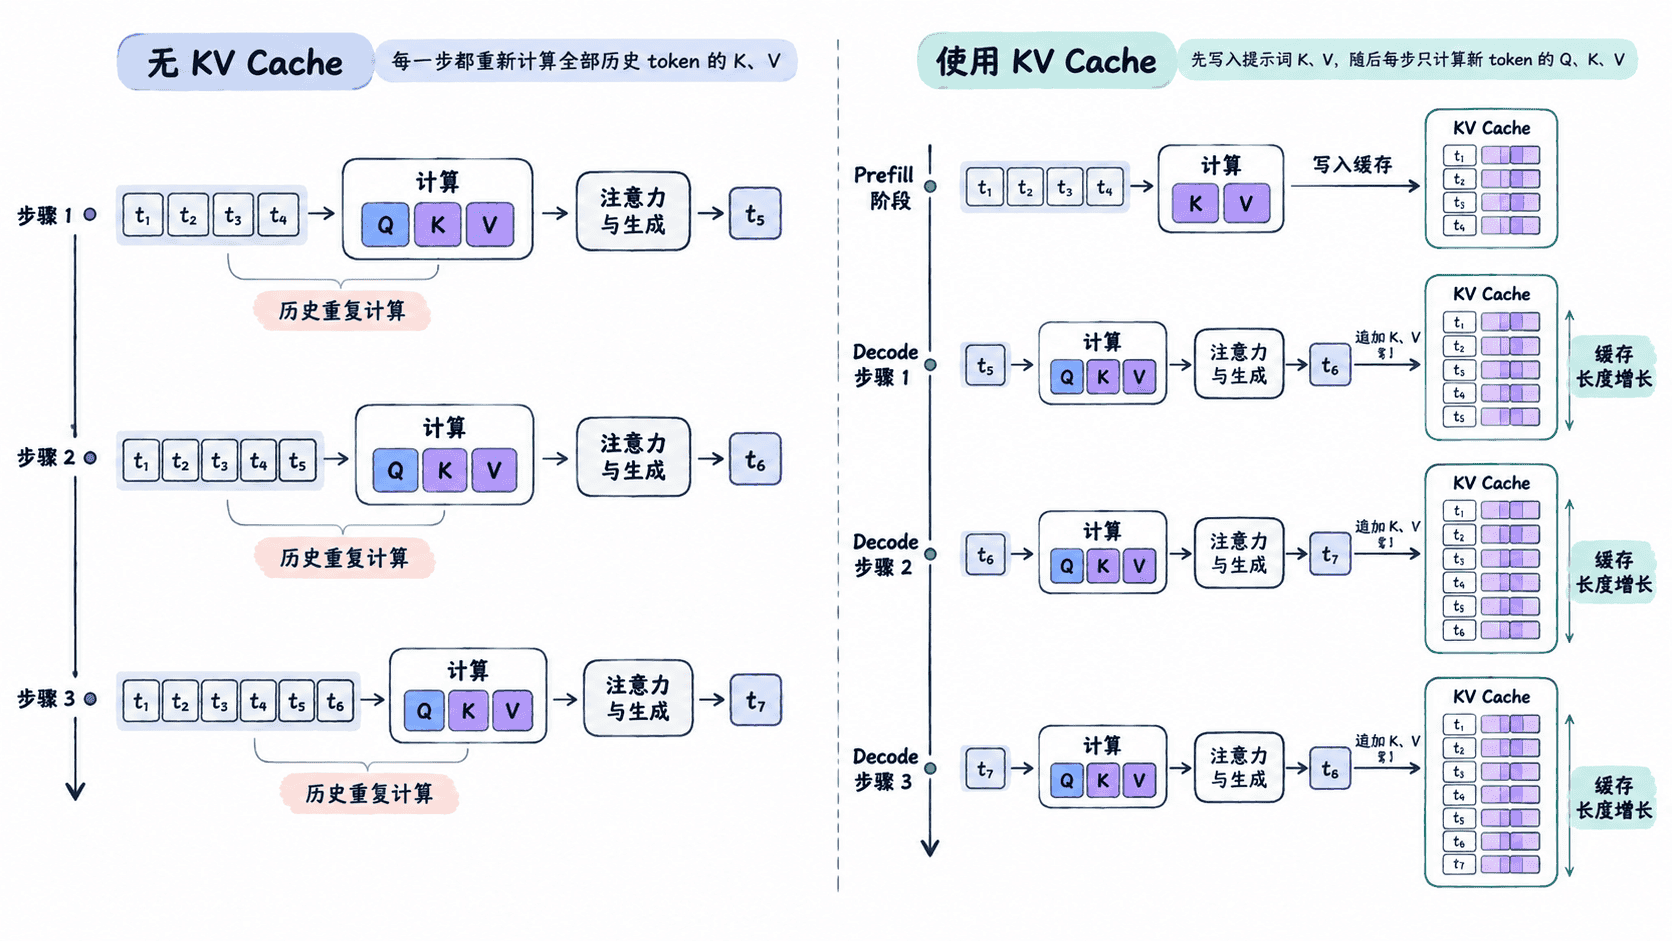
KV Cache 的工作过程
推理通常分为两个阶段。Prefill 一次性处理完整提示词,并为每一层保存所有位置的 K、V;Decode 每轮只输入最新 token,计算当前 Query,并把新生成的 K、V 追加到对应层的缓存。
若批大小为 、注意力头数为 、缓存长度为 、每头维度为 ,单层 Key 或 Value 的典型形状可写为 。序列越长、层数越多,缓存占用越大,因此速度提升是以显存或内存增长为代价的。
可运行的计算量示例
下面的 Python 程序统计“准备连续三个新 token”时需要执行多少次历史 token 的 K/V 投影。它是简化的计数模型,用于说明复用关系,不代表真实硬件耗时。
from typing import List

def projections_without_cache(prompt: List[int], new_token_count: int) -> int:
    sequence = prompt.copy()
    projection_count = 0

    for step in range(new_token_count):
        # 每一步都重新投影当前完整历史。
        projection_count += len(sequence)
        sequence.append(100 + step)

    return projection_count

def projections_with_cache(prompt: List[int], new_token_count: int) -> int:
    projection_count = len(prompt)  # Prefill 只计算一次提示词。
    cached_tokens = prompt.copy()

    for step in range(new_token_count - 1):
        # 为下一轮解码追加刚生成 token 的 K/V。
        cached_tokens.append(100 + step)
        projection_count += 1

    return projection_count

prompt_tokens = [11, 12, 13, 14]
new_token_count = 3

without_cache = projections_without_cache(prompt_tokens, new_token_count)
with_cache = projections_with_cache(prompt_tokens, new_token_count)

print(f"无缓存投影次数: {without_cache}")
print(f"使用缓存投影次数: {with_cache}")
print(f"减少次数: {without_cache - with_cache}")
预期输出
无缓存投影次数: 15
使用缓存投影次数: 6
减少次数: 9
无缓存时三轮分别处理 4、5、6 个历史 token;使用缓存时先处理 4 个提示词,再为后续两轮各追加 1 个新 token。真实模型还包含注意力打分、前馈网络和内存读写,因此该结果只说明 K/V 投影的复用效果。
性能收益与使用边界
KV Cache 使单步解码不再重复执行整段历史的前向计算,但当前 Query 仍需与全部历史 Key 计算注意力,所以单步成本会随上下文长度增长。Prefill 也仍需处理完整提示词,并不会因为缓存而消失。
缓存通常按层、请求和序列分别维护。修改提示词、回退 token、切换分支或执行 beam search 时,需要截断、复制或重排缓存;不同请求不能直接共用缓存内容。长上下文服务还要关注缓存精度、分页管理和显存淘汰策略。
本课总结
- KV Cache 复用历史 token 的 Key 和 Value,避免每轮重复投影整段序列
- 推理分为一次性 prefill 与逐 token decode,缓存会随序列长度持续增长
- 它降低了解码计算量,但会增加显存占用,且分支变化时必须同步调整缓存
下一课预告
下一课将进一步讨论批量生成与缓存管理,分析不同长度请求并发执行时如何减少填充浪费和显存碎片。