
大模型原理与训练 / 系统课时
自回归生成原理
自回归生成原理
自回归生成把“写完整段文本”拆成连续的下一词元预测:模型读取已有词元,计算下一个词元的概率,选出一个结果并追加到序列,直到生成结束标记或达到长度上限。
学习目标
- 说清自回归生成中“输入、预测、追加、继续”的闭环
- 理解训练阶段与实际生成阶段的输入差异
- 知道结束条件与采样策略会怎样影响最终文本
从一个词元开始生成
假设当前提示词被分成词元序列 。模型不会一次直接输出整段答案,而是先估计下一个词元的条件概率:
选出 后,新序列变成 ,模型再预测 。因此,每一步的输出都会成为下一步的输入,前面一处选择也可能持续影响后续内容。
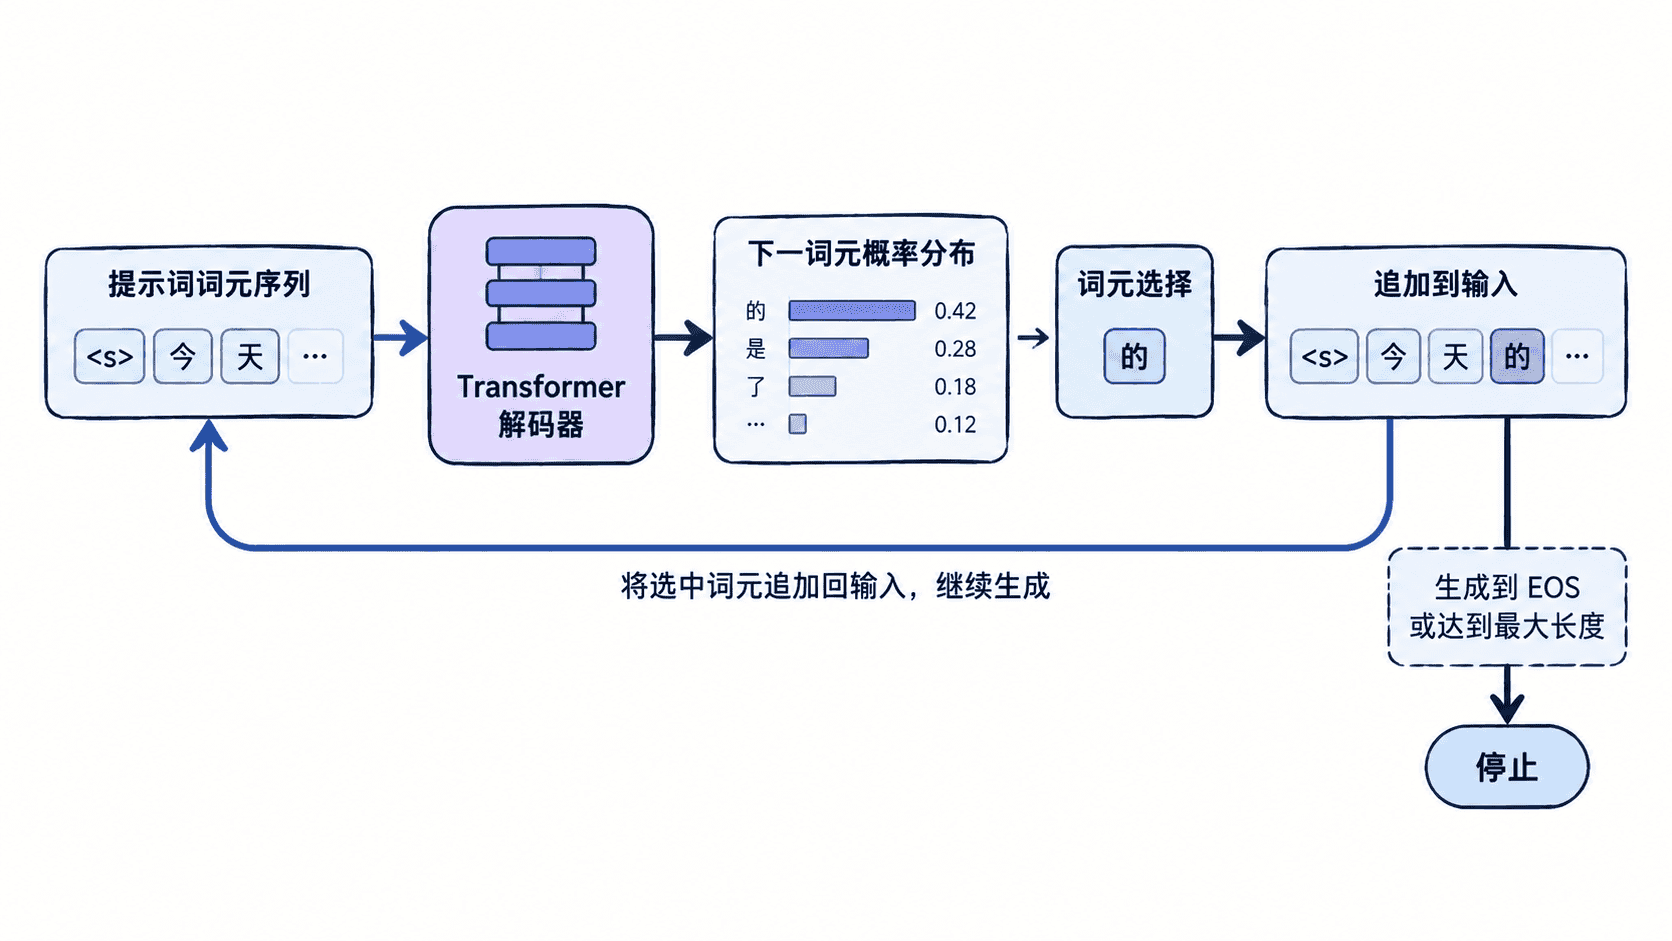
一轮生成如何执行
一次完整循环通常包含四个动作:先对当前序列做前向计算,再取得最后一个位置的概率分布,然后按指定策略选择词元,最后把词元追加到序列。模型只使用最后一个位置的预测结果,因为前面各位置对应的是“在更短前缀下预测下一词元”的结果。
例如,提示词为“今天天气”,模型可能给出“很好”“不错”“炎热”等候选。若本轮选中“很好”,下一轮输入就变为“今天天气很好”,模型随后继续预测标点或后续描述。
训练与生成的差别
训练时,完整目标序列通常已经存在。模型会在因果掩码保护下,同时计算多个位置的下一词元预测,并用真实答案作为监督,这种方式常称为教师强制。它能够并行训练,效率较高。
实际生成时,未来词元并不存在,只能先生成一个,再把它追加后继续计算。因此生成过程天然是串行的。工程实现常缓存历史位置的键和值,避免每轮重复计算全部前缀,这就是常见的 KV Cache。
如何选择下一个词元
选择概率最高的词元称为贪心解码,结果稳定,但容易重复或显得单调。按概率随机采样能增加多样性,通常还会配合 temperature、top-k 或 top-p 限制候选范围。
temperature 小于 1 时,概率分布更集中,输出更保守;temperature 大于 1 时,分布更平缓,输出更随机。采样策略不会改变模型学到的知识,只改变如何从下一词元概率中做选择。
何时停止生成
生成不会无限继续,常见停止条件包括遇到结束词元 EOS、达到最大生成长度,或命中应用设置的停止字符串。若只设置最大长度而没有合理的结束标记,文本可能在语义未完成时被截断。
需要注意,模型每一步都只优化“下一个词元是否合理”,并不直接保证整段文本全局最优。因此长文本可能出现前后矛盾、主题漂移或重复,实际应用常通过提示词约束、采样参数和后处理共同控制。
本课总结
- 自回归生成通过“预测一个词元、追加、继续预测”逐步构造完整序列
- 训练可以并行计算多个位置,而实际生成必须按时间步串行推进
- 采样策略和停止条件共同决定输出的稳定性、多样性与长度
下一课预告
下一课将学习因果注意力掩码,理解模型为何只能读取当前位置及其之前的词元,而不能在训练时偷看未来答案。