
大模型原理与训练 / 系统课时
编码器解码器模型
编码器解码器模型
编码器解码器模型把“理解输入序列”和“生成目标序列”分成两个协作模块。本课将连接自注意力、交叉注意力和输出映射,并用 PyTorch 构建一个可训练、可自回归生成的最小完整模型。
学习目标
- 说明编码器、解码器和交叉注意力各自承担的职责
- 跟踪源序列、目标序列与编码记忆之间的张量流向
- 使用 PyTorch 完成训练前向计算和贪心生成
完整模型如何连接
编码器先读取整个源序列,通过多层自注意力生成上下文表示,通常称为 memory。解码器一边查看已经生成的目标前缀,一边通过交叉注意力查询 memory,最后将隐藏状态映射到目标词表。
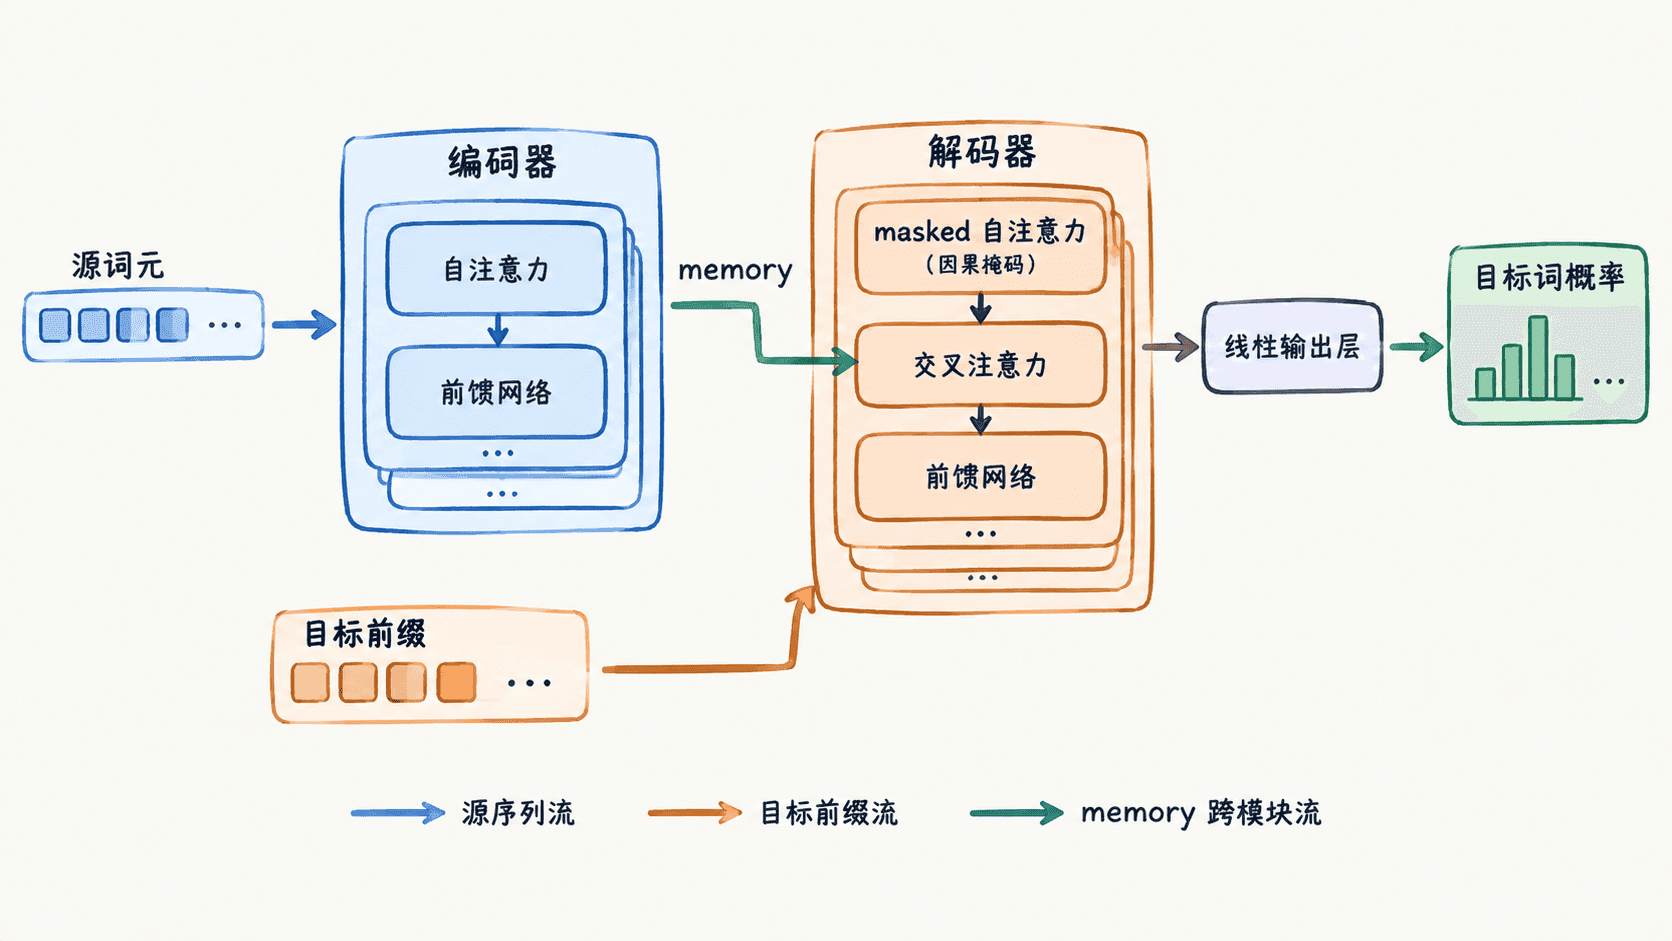
解码器包含两类注意力。带因果掩码的自注意力负责建模目标前缀,交叉注意力则使用解码器状态作为查询,把编码器输出作为键和值。正是这条跨模块连接,让生成结果能够持续对齐输入内容。
张量如何在模型中流动
设批量大小为 B,源长度为 S,目标长度为 T,隐藏维度为 D,目标词表大小为 V。主要张量形状如下:
| 张量 | 形状 | 作用 |
|---|---|---|
源词元 src |
[B, S] |
编码器输入 |
目标前缀 tgt_in |
[B, T] |
解码器输入 |
编码记忆 memory |
[B, S, D] |
供交叉注意力读取 |
输出 logits |
[B, T, V] |
每个位置的词表分数 |
训练时,目标序列要右移:tgt_in 去掉最后一个词,标签去掉第一个词。推理时只有 <BOS> 和已生成前缀,模型每轮只取最后一个位置的 logits 选择下一个词。
PyTorch 最小实现
下面示例使用 nn.Transformer 组装编码器和解码器。模型包含词嵌入、可学习位置嵌入、词表输出层以及贪心解码方法,可直接运行。
import torch
from torch import nn

class EncoderDecoderTransformer(nn.Module):
    def __init__(
        self,
        src_vocab_size: int,
        tgt_vocab_size: int,
        d_model: int = 32,
        nhead: int = 4,
        num_layers: int = 1,
        max_len: int = 64,
    ) -> None:
        super().__init__()
        self.src_embedding = nn.Embedding(src_vocab_size, d_model)
        self.tgt_embedding = nn.Embedding(tgt_vocab_size, d_model)
        self.position_embedding = nn.Embedding(max_len, d_model)

        # nn.Transformer 内部已经包含编码器、解码器和交叉注意力
        self.transformer = nn.Transformer(
            d_model=d_model,
            nhead=nhead,
            num_encoder_layers=num_layers,
            num_decoder_layers=num_layers,
            batch_first=True,
        )
        self.output_layer = nn.Linear(d_model, tgt_vocab_size)

    def _add_position(self, tokens: torch.Tensor, embedding: nn.Embedding) -> torch.Tensor:
        positions = torch.arange(tokens.size(1), device=tokens.device)
        return embedding(tokens) + self.position_embedding(positions).unsqueeze(0)

    def forward(self, src: torch.Tensor, tgt_in: torch.Tensor) -> torch.Tensor:
        src_hidden = self._add_position(src, self.src_embedding)
        tgt_hidden = self._add_position(tgt_in, self.tgt_embedding)

        # 上三角负无穷掩码确保目标位置不能访问未来词元
        tgt_len = tgt_in.size(1)
        tgt_mask = torch.triu(
            torch.full((tgt_len, tgt_len), float("-inf"), device=tgt_in.device),
            diagonal=1,
        )
        hidden = self.transformer(
            src=src_hidden,
            tgt=tgt_hidden,
            tgt_mask=tgt_mask,
        )
        return self.output_layer(hidden)

    @torch.no_grad()
    def generate(
        self,
        src: torch.Tensor,
        bos_id: int,
        max_new_tokens: int,
    ) -> torch.Tensor:
        generated = torch.full(
            (src.size(0), 1),
            bos_id,
            dtype=torch.long,
            device=src.device,
        )

        # 每轮只使用最后一个位置的分数选择下一个词
        for _ in range(max_new_tokens):
            logits = self(src, generated)
            next_token = logits[:, -1].argmax(dim=-1, keepdim=True)
            generated = torch.cat([generated, next_token], dim=1)
        return generated

def main() -> None:
    torch.manual_seed(7)
    model = EncoderDecoderTransformer(
        src_vocab_size=40,
        tgt_vocab_size=30,
    )

    src = torch.tensor([
        [4, 9, 12, 6, 3],
        [8, 5, 11, 7, 2],
    ])
    target = torch.tensor([
        [1, 10, 14, 18, 2],
        [1, 13, 16, 19, 2],
    ])

    tgt_in = target[:, :-1]
    labels = target[:, 1:]
    logits = model(src, tgt_in)

    loss_fn = nn.CrossEntropyLoss()
    loss = loss_fn(logits.reshape(-1, 30), labels.reshape(-1))
    generated = model.generate(src, bos_id=1, max_new_tokens=5)

    print("train logits:", tuple(logits.shape))
    print("loss finite:", torch.isfinite(loss).item())
    print("generated is matrix:", generated.ndim == 2)
    print("starts with BOS:", generated[:, 0].eq(1).all().item())

if __name__ == "__main__":
    main()
预期输出:
train logits: (2, 4, 30)
loss finite: True
generated is matrix: True
starts with BOS: True
示例中的模型尚未训练,因此生成的具体词元编号没有语义,且可能随 PyTorch 版本而变化。可验证的重点是训练输出形状、损失可计算,以及生成序列以 <BOS> 开始并按时间步扩展。
从教学模型走向真实任务
真实翻译或摘要系统还要补充源端与目标端填充掩码、分词器、词表、优化器、验证集和保存加载逻辑。推理阶段通常加入 <EOS> 提前停止、KV Cache、束搜索或采样策略。
训练数据必须成对组织,例如“源语言句子—目标语言句子”或“原文—摘要”。损失只计算有效目标词元,填充位置应通过 ignore_index 排除,否则模型会浪费容量学习 <PAD>。
验收模型连接是否正确
先检查 logits 是否为 [B, T, V],再确认目标输入已经右移。随后打乱源序列进行对比:如果模型训练后输出完全不受源输入影响,通常意味着交叉注意力、编码记忆或相关掩码连接有误。
还要确认推理阶段只把已生成词元送入解码器,不能把完整目标答案作为输入。训练可并行计算全部目标位置,生成则必须从 <BOS> 开始逐步展开。
本课总结
- 编码器负责生成源序列记忆,解码器通过交叉注意力读取该记忆并生成目标序列
- 训练使用右移目标序列计算
[B, T, V]词表分数,推理则循环选择下一个词 - 完整工程还需补充填充掩码、停止条件、数据管道和模型保存等能力
下一课预告
下一课将进一步讨论贪心搜索、束搜索与随机采样,比较不同解码策略对生成质量、速度和多样性的影响。