
机器学习与深度学习 / 系统课时
排查训练不收敛
排查训练不收敛
本课建立一套从现象到根因的排查顺序,帮助你在损失不下降、指标随机波动或梯度异常时,依次检查学习率、损失函数、梯度、初始化、数据与实现,最终把“盲目调参”变成可重复验证的诊断过程。
学习目标
- 判断“不收敛”属于数值异常、优化停滞还是数据与实现错误
- 按低成本到高成本的顺序定位学习率、梯度和数据问题
- 使用最小诊断脚本验证前向、反向与参数更新链路
先定义不收敛的具体表现
训练不收敛不是单一现象。先记录训练损失、验证损失、主要指标、梯度范数和学习率,再判断属于哪一类:损失出现 NaN 或 Inf,通常是数值稳定性问题;损失长期不变,通常是参数没有更新或梯度过小;损失剧烈震荡,通常与学习率过大、批次异常或归一化有关;训练集也学不好,则应优先排查实现与数据,而不是正则化。
不要只观察最终准确率。准确率可能因类别不均衡而保持不变,而损失、梯度和参数变化已经暴露问题。
按固定顺序缩小范围
排查时先验证最基础的训练链路,再检查超参数。推荐顺序是:单批次过拟合、损失输入、梯度状态、参数更新、学习率、初始化、数据与标签、训练和评估模式。单批次都无法把损失明显压低,说明问题通常不在模型容量,而在代码、标签或损失计算。
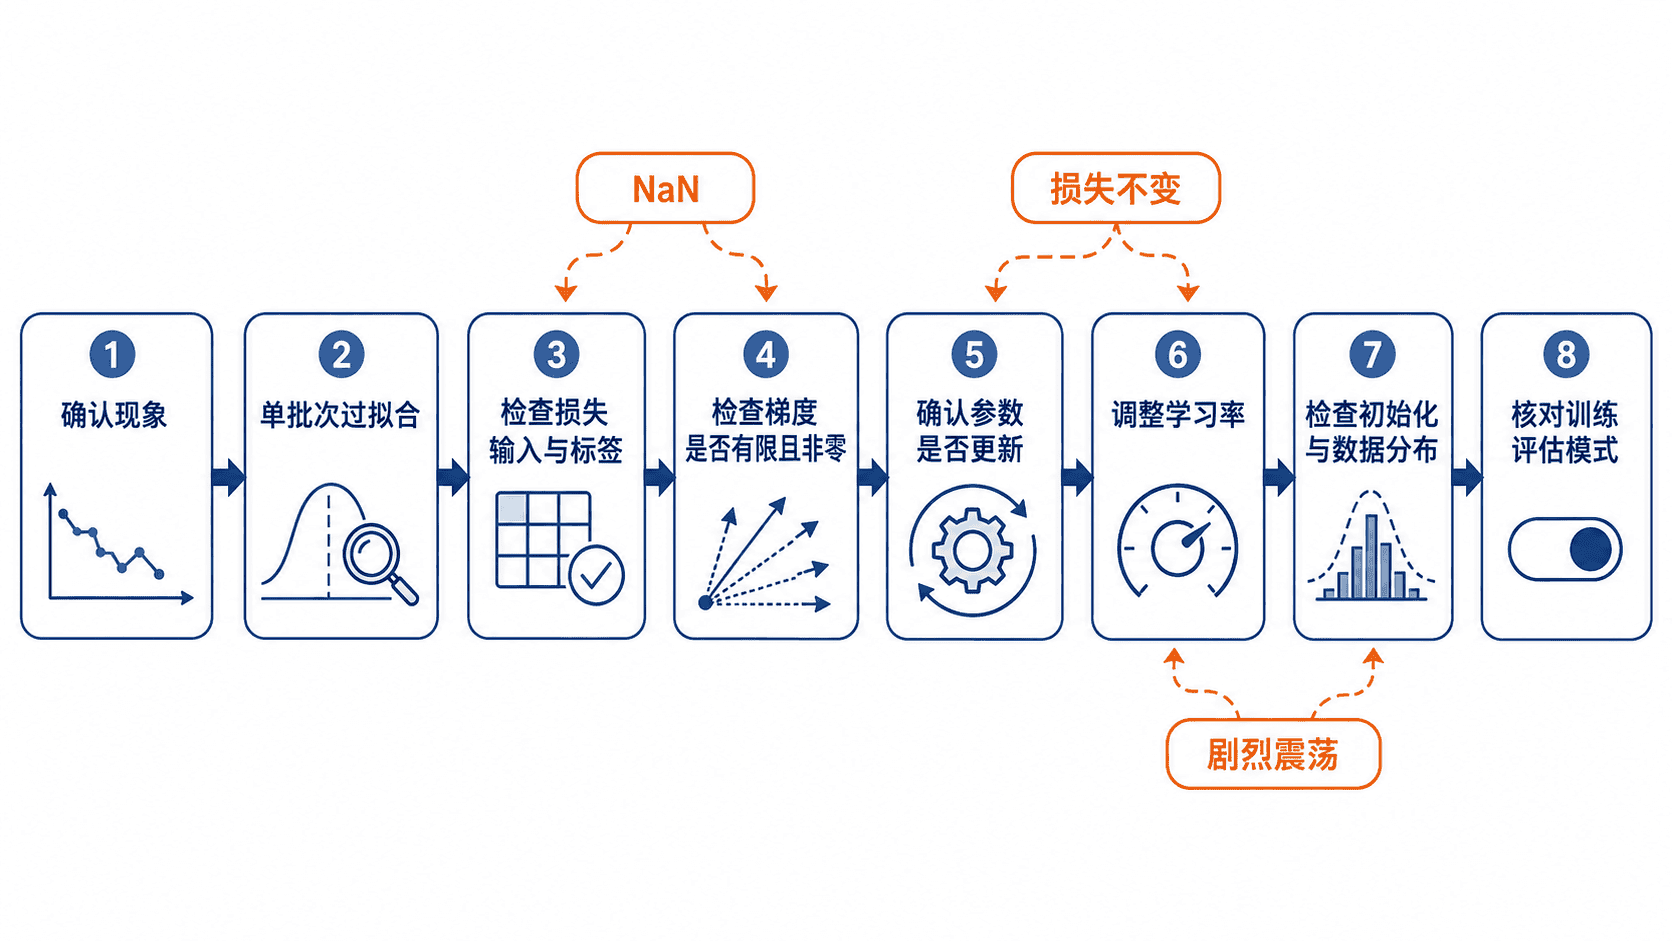
学习率过大时,损失常在高位震荡甚至变成 NaN;过小时,损失下降极慢。可先把学习率缩小 10 倍验证趋势,再使用学习率扫描。若梯度一直为零,检查 detach()、no_grad()、被冻结参数和不可导操作;若梯度爆炸,先记录范数,再考虑梯度裁剪,而不是直接掩盖根因。
用最小脚本验证训练链路
下面的脚本使用固定权重和固定数据,验证损失是否有限、梯度是否产生、梯度范数是否合理,以及优化器执行后参数是否发生变化。它不用于评价模型效果,而用于确认训练代码最基本的前向、反向和更新链路完整。
import math

import torch
from torch import nn

def main() -> None:
    model = nn.Linear(2, 1)

    # 固定参数与样本,避免随机初始化干扰诊断结果。
    with torch.no_grad():
        model.weight.copy_(torch.tensor([[0.5, -0.5]]))
        model.bias.copy_(torch.tensor([0.1]))

    features = torch.tensor([[1.0, 2.0], [2.0, 1.0]])
    targets = torch.tensor([[0.0], [1.0]])

    optimizer = torch.optim.SGD(model.parameters(), lr=0.1)
    loss_fn = nn.MSELoss()

    before = model.weight.detach().clone()
    predictions = model(features)
    loss = loss_fn(predictions, targets)

    optimizer.zero_grad()
    loss.backward()

    grad_sq_sum = 0.0
    for parameter in model.parameters():
        if parameter.grad is not None:
            grad_sq_sum += parameter.grad.pow(2).sum().item()
    grad_norm = math.sqrt(grad_sq_sum)

    optimizer.step()
    updated = not torch.equal(before, model.weight.detach())

    print(f"loss_finite={torch.isfinite(loss).item()}")
    print(f"loss={loss.item():.4f}")
    print(f"grad_norm={grad_norm:.4f}")
    print(f"parameter_updated={updated}")

if __name__ == "__main__":
    main()
预期输出:
loss_finite=True
loss=0.1600
grad_norm=1.8762
parameter_updated=True
若 loss_finite=False,先检查除零、对数输入、指数溢出和混合精度;若 grad_norm=0,沿计算图查找断点;若 parameter_updated=False,检查是否遗漏 optimizer.step()、参数是否注册到优化器,以及训练阶段是否错误使用了 torch.no_grad()。
检查数据、损失与模式边界
分类任务中,CrossEntropyLoss 需要未经过 Softmax 的 logits,标签通常是类别索引;二分类使用 BCEWithLogitsLoss 时,也不要提前执行 Sigmoid。回归任务要确认目标值尺度,量级过大时可先标准化。随机抽取若干样本,核对输入、标签、增强结果和类别映射,避免文件与标签错位。
还要确认训练阶段调用 model.train(),验证阶段调用 model.eval()。BatchNorm 和 Dropout 在两种模式下行为不同;小批次训练中 BatchNorm 统计量不稳定,也可能导致损失波动。完成修复后,重新运行单批次过拟合、小规模数据训练和完整训练,逐级验证,而不是直接启动长任务。
本课总结
- 先把不收敛细分为数值异常、优化停滞和剧烈震荡,再选择检查方向
- 单批次过拟合与最小训练链路检查,能最快排除实现、梯度和更新问题
- 修复后应按单批次、小数据集、完整数据集的顺序逐级验证
下一课预告
下一课将把训练代码、配置、权重、实验报告和部署说明整理成可验收的交付包,并完成项目复盘与后续优化计划。