
机器学习与深度学习 / 系统课时
经典 CNN 设计思想
经典 CNN 设计思想
本课不复述经典网络的完整层表,而是提炼三种可迁移的设计思想:VGG 的规则堆叠、ResNet 的残差连接,以及深度可分离卷积的高效计算。
学习目标
- 说明 VGG、ResNet 与高效卷积网络分别解决的核心问题。
- 读懂重复卷积块、残差捷径和深度可分离卷积的结构差异。
- 根据模型深度、设备算力和部署目标选择合适设计。
三类结构解决什么问题
VGG 追求规则统一,用重复的 3×3 卷积块构建清晰基线;ResNet 通过捷径连接缓解深层网络难以优化的问题;MobileNet 一类高效网络则拆分标准卷积,减少参数量与乘加运算。
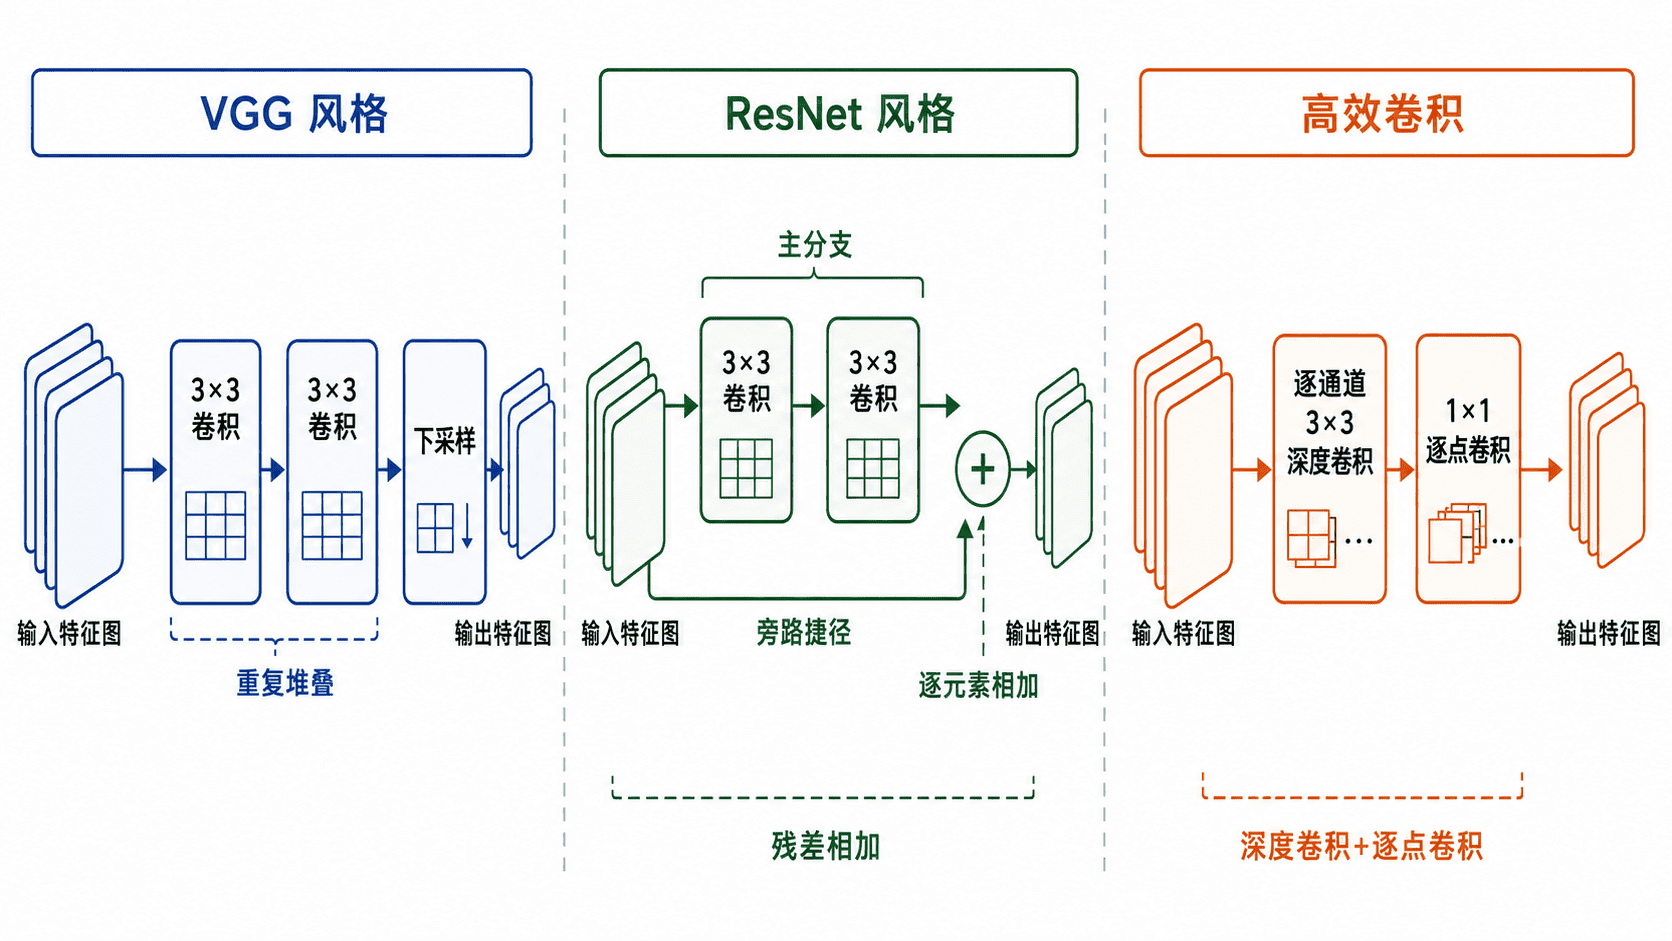
这三种思想不是互斥选项。现代网络经常同时使用残差连接、瓶颈结构和高效卷积,因此应先理解每个结构改变了哪条数据路径,再讨论具体模型名称。
VGG:用规则堆叠换取可预测性
VGG 的关键不是“层数很多”,而是反复使用小卷积核。两个连续 3×3 卷积可以扩大有效感受野,并在中间增加一次非线性表达,同时保持模块形状统一,便于实现和调试。
代价是参数量和计算量增长较快。VGG 风格适合教学、建立基线或处理中等规模问题,但在移动端和超深网络中通常不是最经济的选择。
ResNet:让网络学习残差
残差块把输入记为 ,主分支学习变换 ,输出为:
捷径为信息和梯度提供直接通路,使深层网络更容易退化为接近恒等映射,而不是被迫让多层卷积重新学习完整映射。只有主分支和捷径的张量形状一致时才能直接相加;通道数或步幅变化时,通常需要 1×1 卷积完成投影。
高效卷积:拆分空间与通道计算
标准卷积同时完成空间特征提取和通道混合。深度可分离卷积先对每个输入通道独立执行空间卷积,再用 1×1 逐点卷积混合通道,因此能显著降低参数量和计算量。
参数减少不等于任何设备上都会等比例加速。实际速度还受内存访问、算子实现、批量大小和硬件并行能力影响,所以部署前必须在目标设备上测量延迟。
用代码验证三种思想
下面的可运行实验分别实现 VGG 风格块、等通道残差块和深度可分离卷积块,并比较标准卷积块与高效卷积块的参数量。它用于观察结构机制,不代表完整的 VGG、ResNet 或 MobileNet 分类器。
import torch
from torch import nn

class VGGBlock(nn.Module):
    def __init__(self, in_channels: int, out_channels: int) -> None:
        super().__init__()
        self.block = nn.Sequential(
            nn.Conv2d(in_channels, out_channels, 3, padding=1, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True),
            nn.Conv2d(out_channels, out_channels, 3, padding=1, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.block(x)

class ResidualBlock(nn.Module):
    def __init__(self, channels: int) -> None:
        super().__init__()
        self.conv1 = nn.Conv2d(channels, channels, 3, padding=1, bias=False)
        self.bn1 = nn.BatchNorm2d(channels)
        self.conv2 = nn.Conv2d(channels, channels, 3, padding=1, bias=False)
        self.bn2 = nn.BatchNorm2d(channels)
        self.relu = nn.ReLU(inplace=True)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        identity = x
        out = self.relu(self.bn1(self.conv1(x)))
        out = self.bn2(self.conv2(out))
        # 当前示例保持通道数和空间尺寸不变,因此可以直接相加。
        return self.relu(out + identity)

class StandardConvBlock(nn.Module):
    def __init__(self, in_channels: int, out_channels: int) -> None:
        super().__init__()
        self.block = nn.Sequential(
            nn.Conv2d(in_channels, out_channels, 3, padding=1, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.block(x)

class DepthwiseSeparableConv(nn.Module):
    def __init__(self, in_channels: int, out_channels: int) -> None:
        super().__init__()
        self.block = nn.Sequential(
            nn.Conv2d(
                in_channels,
                in_channels,
                3,
                padding=1,
                groups=in_channels,
                bias=False,
            ),
            nn.BatchNorm2d(in_channels),
            nn.ReLU(inplace=True),
            nn.Conv2d(in_channels, out_channels, 1, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.block(x)

def parameter_count(module: nn.Module) -> int:
    return sum(p.numel() for p in module.parameters() if p.requires_grad)

def main() -> None:
    torch.manual_seed(42)
    vgg = VGGBlock(32, 64)
    residual = ResidualBlock(64)
    standard = StandardConvBlock(64, 128)
    efficient = DepthwiseSeparableConv(64, 128)

    x = torch.randn(2, 32, 32, 32)
    vgg_out = vgg(x)
    residual_out = residual(vgg_out)
    efficient_out = efficient(residual_out)

    standard_params = parameter_count(standard)
    efficient_params = parameter_count(efficient)

    print(f"VGG output: {tuple(vgg_out.shape)}")
    print(f"Residual output: {tuple(residual_out.shape)}")
    print(f"Efficient output: {tuple(efficient_out.shape)}")
    print(f"Standard block parameters: {standard_params}")
    print(f"Depthwise separable parameters: {efficient_params}")
    print(f"Parameter reduction: {standard_params / efficient_params:.2f}x")

if __name__ == "__main__":
    main()
预期输出
VGG output: (2, 64, 32, 32)
Residual output: (2, 64, 32, 32)
Efficient output: (2, 128, 32, 32)
Standard block parameters: 73984
Depthwise separable parameters: 9152
Parameter reduction: 8.08x
输出表明,VGG 块改变了通道数但保持空间尺寸,残差块保持完整形状以便相加,高效卷积块则用更少参数把通道数扩展到 128。参数优势只是设计依据之一,最终还要比较精度、吞吐量、峰值内存和目标设备延迟。
选择结构的实际原则
需要快速建立稳定基线时,规则卷积块最容易理解和排错;需要继续加深网络时,优先考虑残差连接;面向移动端、边缘设备或高并发推理时,可评估深度可分离卷积及其硬件支持。
不要仅凭模型参数量判断部署成本。输入分辨率、特征图尺寸和算子效率都会影响运行时间,正确做法是在相同数据预处理、批量大小和精度模式下进行实测。
本课总结
- VGG 的价值在于统一、可重复的卷积块设计,而代价是较高计算成本。
- ResNet 用捷径连接改善深层网络的信息和梯度传递,但相加前必须保证形状兼容。
- 深度可分离卷积显著减少参数与计算,真实加速效果仍需目标设备验证。
下一课预告
下一课将把这些结构用于真实图像分类任务,完成数据增强、训练、验证和指标分析,并观察不同设计对收敛速度与准确率的影响。