
机器学习与深度学习 / 系统课时
分析训练性能瓶颈
分析训练性能瓶颈
本课把一次训练迭代拆成数据加载、设备传输、前向计算、反向传播和参数更新五个阶段,并用可运行的计时代码找出真正拖慢吞吐量的环节。完成后,你能依据耗时比例和资源表现决定先优化数据管线还是模型计算。
学习目标
- 正确测量训练各阶段耗时,避免异步执行造成误判
- 根据阶段占比判断数据瓶颈、计算瓶颈或更新瓶颈
- 建立可重复的基准测试流程,并验证优化是否有效
建立分阶段测量模型
训练慢并不等于 GPU 算得慢。一次迭代通常依次经历读取批次、把张量传到设备、执行前向、计算梯度和更新参数。只有把总耗时拆开,才能知道等待发生在哪里。
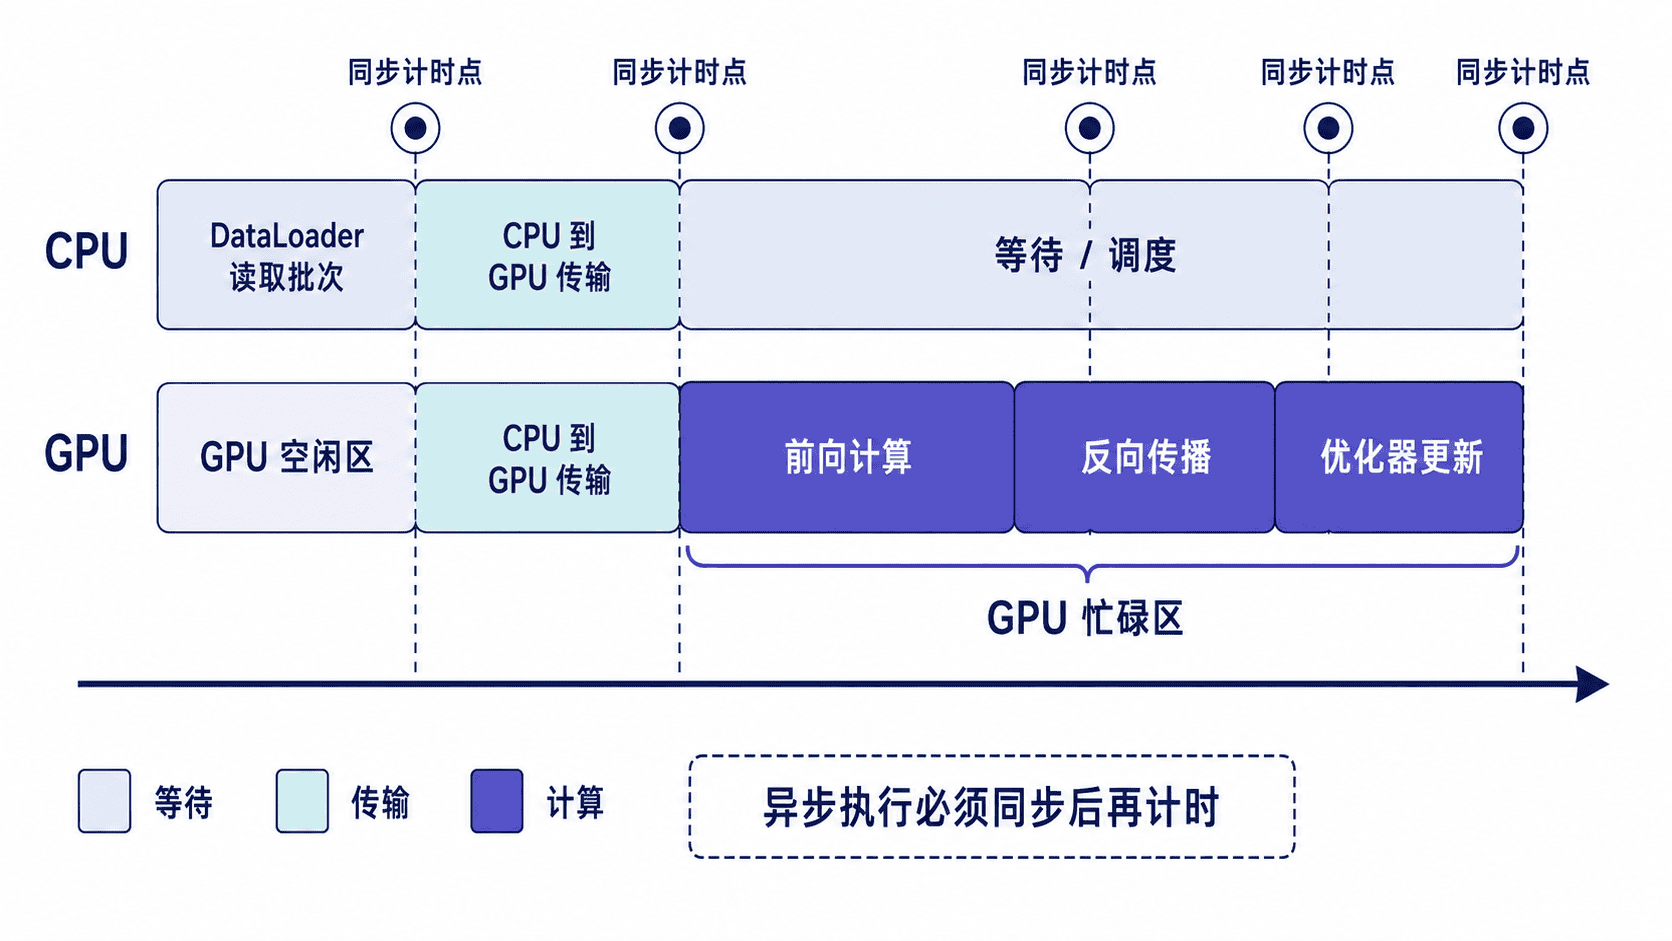
CUDA 默认异步执行:Python 调用返回时,GPU 任务可能仍在队列中。因此,直接用 time.perf_counter() 包住前向或反向会低估真实耗时。基准测试必须在阶段边界调用 torch.cuda.synchronize(),并跳过预热迭代。
运行最小基准
下面的脚本可在 CPU 或 CUDA 上运行。它使用同一批训练循环分别累计数据等待、设备传输、前向、反向和参数更新耗时。num_workers=0 是故意设置的基线,后续才能客观比较增加工作进程是否有效。
import time

import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

torch.manual_seed(0)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

dataset = TensorDataset(
    torch.randn(4096, 512),
    torch.randint(0, 10, (4096,)),
)
loader = DataLoader(
    dataset,
    batch_size=128,
    shuffle=True,
    num_workers=0,
    pin_memory=device.type == "cuda",
)

model = nn.Sequential(
    nn.Linear(512, 1024),
    nn.ReLU(),
    nn.Linear(1024, 10),
).to(device)
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)

def synchronize() -> None:
    # CUDA 异步执行,阶段计时前必须等待设备完成队列中的任务。
    if device.type == "cuda":
        torch.cuda.synchronize()

warmup_steps = 5
measure_steps = 20
totals = {
    "data_wait": 0.0,
    "transfer": 0.0,
    "forward": 0.0,
    "backward": 0.0,
    "update": 0.0,
}

iterator = iter(loader)
for step in range(warmup_steps + measure_steps):
    start = time.perf_counter()
    try:
        features, labels = next(iterator)
    except StopIteration:
        iterator = iter(loader)
        features, labels = next(iterator)
    synchronize()
    after_data = time.perf_counter()

    features = features.to(device, non_blocking=True)
    labels = labels.to(device, non_blocking=True)
    synchronize()
    after_transfer = time.perf_counter()

    optimizer.zero_grad(set_to_none=True)
    logits = model(features)
    loss = criterion(logits, labels)
    synchronize()
    after_forward = time.perf_counter()

    loss.backward()
    synchronize()
    after_backward = time.perf_counter()

    optimizer.step()
    synchronize()
    after_update = time.perf_counter()

    if step >= warmup_steps:
        totals["data_wait"] += after_data - start
        totals["transfer"] += after_transfer - after_data
        totals["forward"] += after_forward - after_transfer
        totals["backward"] += after_backward - after_forward
        totals["update"] += after_update - after_backward

print(f"device={device.type}")
for name, seconds in totals.items():
    average_ms = seconds * 1000 / measure_steps
    print(f"{name:>10}: {average_ms:8.3f} ms")
预期输出如下,具体时间会随 GPU、CPU、驱动和系统负载变化,因此用 <TIME_MS> 表示动态值。
device=cuda
 data_wait: <TIME_MS> ms
  transfer: <TIME_MS> ms
   forward: <TIME_MS> ms
  backward: <TIME_MS> ms
    update: <TIME_MS> ms
运行时应保持模型、批量大小、数据集和测量轮数不变,并至少重复三次。若首次结果明显偏高,通常是内核初始化、缓存建立或频率提升尚未稳定,不能直接拿来比较。
根据结果定位瓶颈
若 data_wait 占比高且 GPU 利用率周期性跌到低位,优先检查磁盘读取、解码、数据增强、num_workers、prefetch_factor 和 pin_memory。优化后应同时看到等待时间下降、GPU 空闲间隔缩短和样本吞吐量上升。
若前向与反向占据大部分时间,同时 GPU 利用率长期较高,说明训练更接近计算瓶颈。此时可评估混合精度、更高效的算子、编译优化、减小输入尺寸或调整模型结构,而不是继续增加数据加载线程。
若参数更新耗时异常突出,常见原因是参数量大、优化器状态复杂或存在大量小张量操作。可以对比 SGD 与 AdamW、检查参数分组,并使用 PyTorch Profiler 继续下钻到具体算子。
判断优化是否成功不能只看单次迭代。应比较稳定阶段的平均吞吐量、峰值显存和损失曲线;如果速度提升但损失出现异常,说明优化改变了数值行为或训练配置,不能视为有效改进。
本课总结
- 性能分析必须按训练阶段拆分,并在 CUDA 计时边界执行同步
- 高数据等待对应数据管线瓶颈,高前向与反向占比通常对应计算瓶颈
- 所有优化都应在固定条件下重复测量,并同时验证吞吐量、资源占用和训练正确性
下一课预告
下一课将把性能测量结果转化为显存预算,分析参数、梯度、优化器状态和激活值分别占用多少空间,并据此选择安全的批量大小。