
机器学习与深度学习 / 系统课时
Adam 与常用优化器
Adam 与常用优化器
本课解决“面对不同模型和训练阶段,应该选 SGD、Adam 还是 AdamW”这一问题。你将理解 Adam 的一阶、二阶动量如何形成自适应步长,并通过单步实验看清 AdamW 与传统 L2 正则更新的区别。
学习目标
- 说明 SGD、Adam 和 AdamW 的核心更新机制
- 理解 Adam 的动量估计、偏差修正和自适应步长
- 根据任务特征选择优化器并设置关键参数
三类优化器的核心差异
SGD 主要依赖当前梯度和可选动量,所有参数共享同一个基础学习率。Adam 同时维护梯度均值和梯度平方均值,为不同参数计算不同的有效步长。AdamW 则在 Adam 基础上,把权重衰减从梯度计算中分离出来。
| 优化器 | 主要机制 | 常见优势 | 典型注意点 |
|---|---|---|---|
| SGD + Momentum | 累积历史方向 | 后期收敛稳定,常有较好泛化 | 对学习率和调度较敏感 |
| Adam | 一阶、二阶动量自适应 | 前期下降快,对梯度尺度差异更稳健 | 权重衰减与梯度耦合 |
| AdamW | Adam + 解耦权重衰减 | 正则化含义更清晰,现代网络常用 | 仍需调学习率和衰减系数 |
没有任何优化器在所有任务上都占优。选择时应结合模型结构、数据规模、训练预算和验证集表现,而不是只比较训练损失下降速度。
Adam 如何计算自适应步长
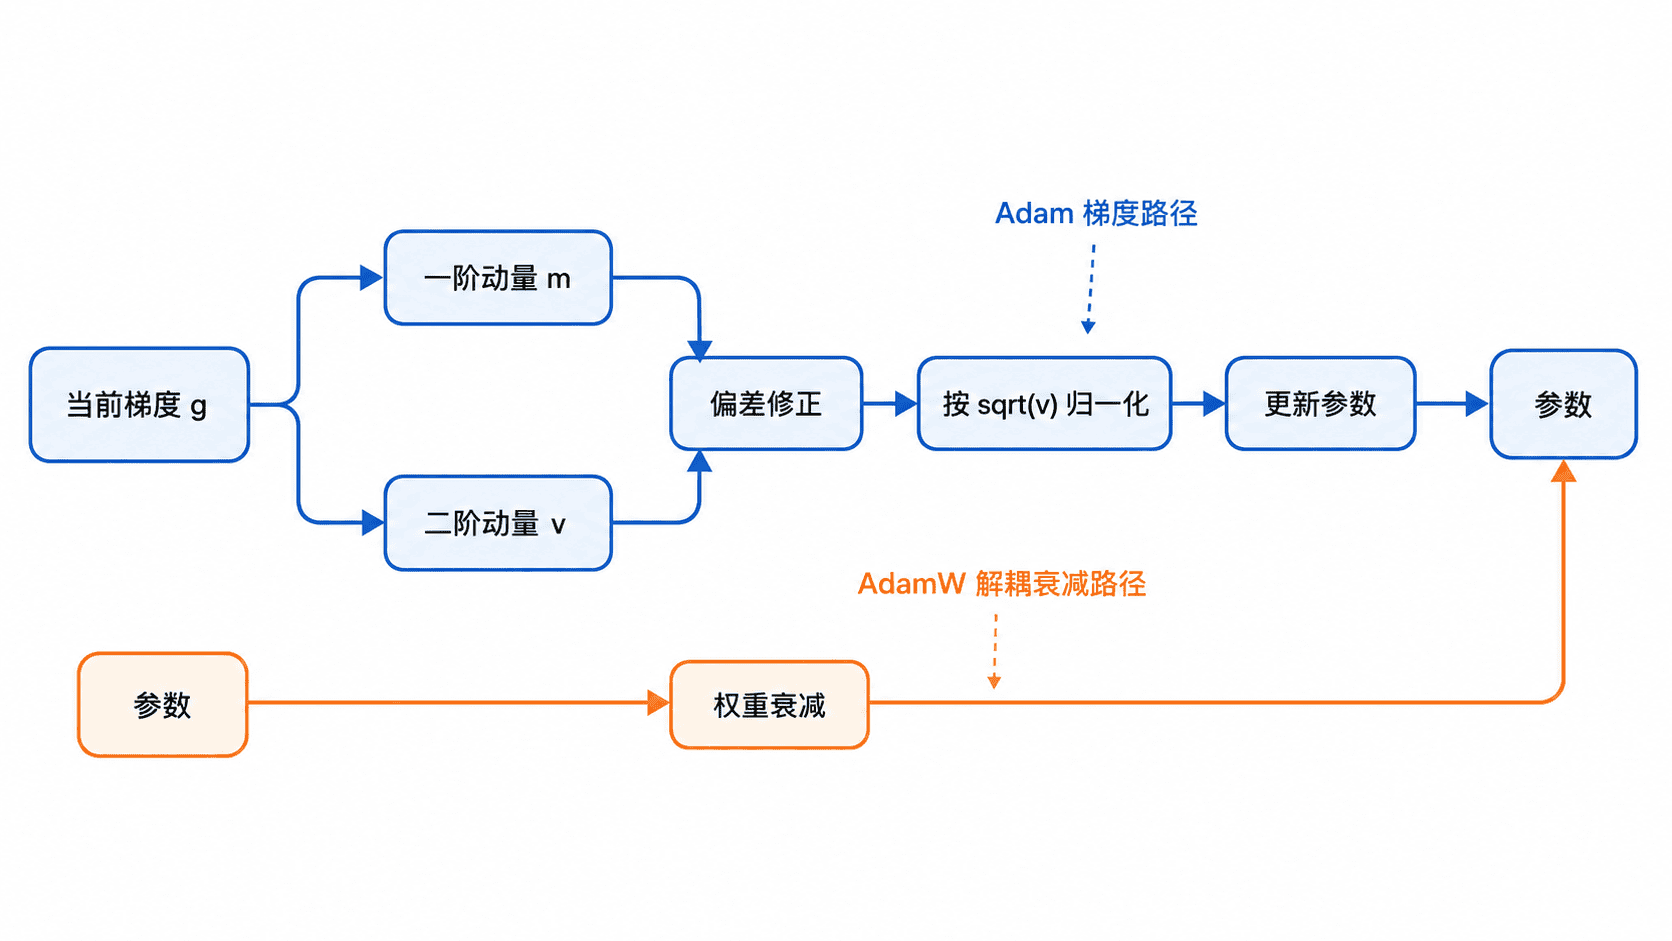
Adam 为每个参数维护两个状态:一阶动量 m 近似梯度的滑动平均,二阶动量 v 近似梯度平方的滑动平均。训练初期这两个状态从零开始,因此还要进行偏差修正。
参数更新可以理解为:先用 m 决定主要方向,再用 sqrt(v) 缩放步长。历史梯度经常较大的参数会获得较小的有效步长,梯度较小的参数则不会被同一全局尺度完全压制。epsilon 用于防止分母接近零。
AdamW 为什么单独处理权重衰减
传统做法常把 L2 正则项加到梯度中,再交给优化器更新。对普通 SGD,这与权重衰减在特定条件下可以等价;对 Adam,由于梯度还会被二阶动量缩放,正则项也会受到自适应缩放,实际衰减效果不再直接。
AdamW 直接执行类似 w = w * (1 - lr * weight_decay) 的衰减,再应用 Adam 更新。这样 weight_decay 更接近“每一步把参数缩小多少”的独立控制量,调参含义更清楚。
单步更新对比
下面固定参数、梯度和学习率,比较 SGD 加 L2、Adam 与 AdamW 的第一步结果。示例为教学实现,只展示核心更新,不替代框架中的完整优化器。
import math

weight = 1.0
gradient = 0.2
learning_rate = 0.1
weight_decay = 0.01
beta1 = 0.9
beta2 = 0.999
epsilon = 1e-8

sgd_weight = weight - learning_rate * (
    gradient + weight_decay * weight
)

m = (1 - beta1) * gradient
v = (1 - beta2) * gradient * gradient
m_hat = m / (1 - beta1)
v_hat = v / (1 - beta2)
adam_step = learning_rate * m_hat / (math.sqrt(v_hat) + epsilon)

adam_weight = weight - adam_step
adamw_weight = weight * (
    1 - learning_rate * weight_decay
) - adam_step

print(f"SGD + L2: {sgd_weight:.6f}")
print(f"Adam:     {adam_weight:.6f}")
print(f"AdamW:    {adamw_weight:.6f}")
预期输出:
SGD + L2: 0.979000
Adam:     0.900000
AdamW:    0.899000
第一步中,Adam 对单一非零梯度进行了归一化,因此更新量接近基础学习率。AdamW 又独立执行了 0.001 的权重衰减,所以结果比 Adam 小 0.001。真实训练会持续累积状态,后续更新不再等同于这一单步结果。
如何选择与调参
训练 Transformer、扩散模型或梯度尺度差异明显的网络时,AdamW 常作为稳妥起点。可以先使用较小学习率,再配合预热和衰减调度。beta1 控制方向平滑程度,beta2 控制梯度平方统计的记忆长度,通常不必在首次实验中同时大幅修改。
图像分类等任务若追求后期泛化,并且有足够调参预算,可以比较 SGD 加动量与 AdamW。不要只看训练集损失,应以验证指标、收敛速度、稳定性和资源成本共同判断。
无论使用哪种优化器,都要区分“优化困难”和“模型或数据问题”。损失不下降也可能来自标签错误、归一化不当、梯度未清零、参数未加入优化器或学习率调度配置错误。
本课总结
- SGD 使用统一步长,Adam 根据一阶和二阶动量为每个参数调整有效学习率
- AdamW 将权重衰减与自适应梯度更新解耦,正则化含义通常比 Adam 加 L2 更清晰
- 优化器选择应以验证集表现和训练稳定性为准,并结合学习率调度一起评估
下一课预告
下一课将把优化器放回完整训练循环,串联梯度清零、前向计算、反向传播、参数更新和学习率调度。