
机器学习与深度学习 / 系统课时
编写标准训练循环
编写标准训练循环
本课将把模型训练整理成可重复执行的标准闭环:读取批次、前向计算、计算损失、反向传播、更新参数并清零梯度。完成后,你可以直接运行代码,并能判断每一步是否处在正确位置。
学习目标
- 掌握训练循环中六个核心步骤的执行顺序
- 能够使用损失函数和优化器更新模型参数
- 能够按样本数计算每轮平均损失
标准训练闭环
一次训练迭代只处理一个批次。模型先根据输入产生预测,损失函数衡量预测与标签的差距,反向传播计算参数梯度,优化器再根据梯度修改参数。所有批次处理完成后,才得到一个完整训练轮次。
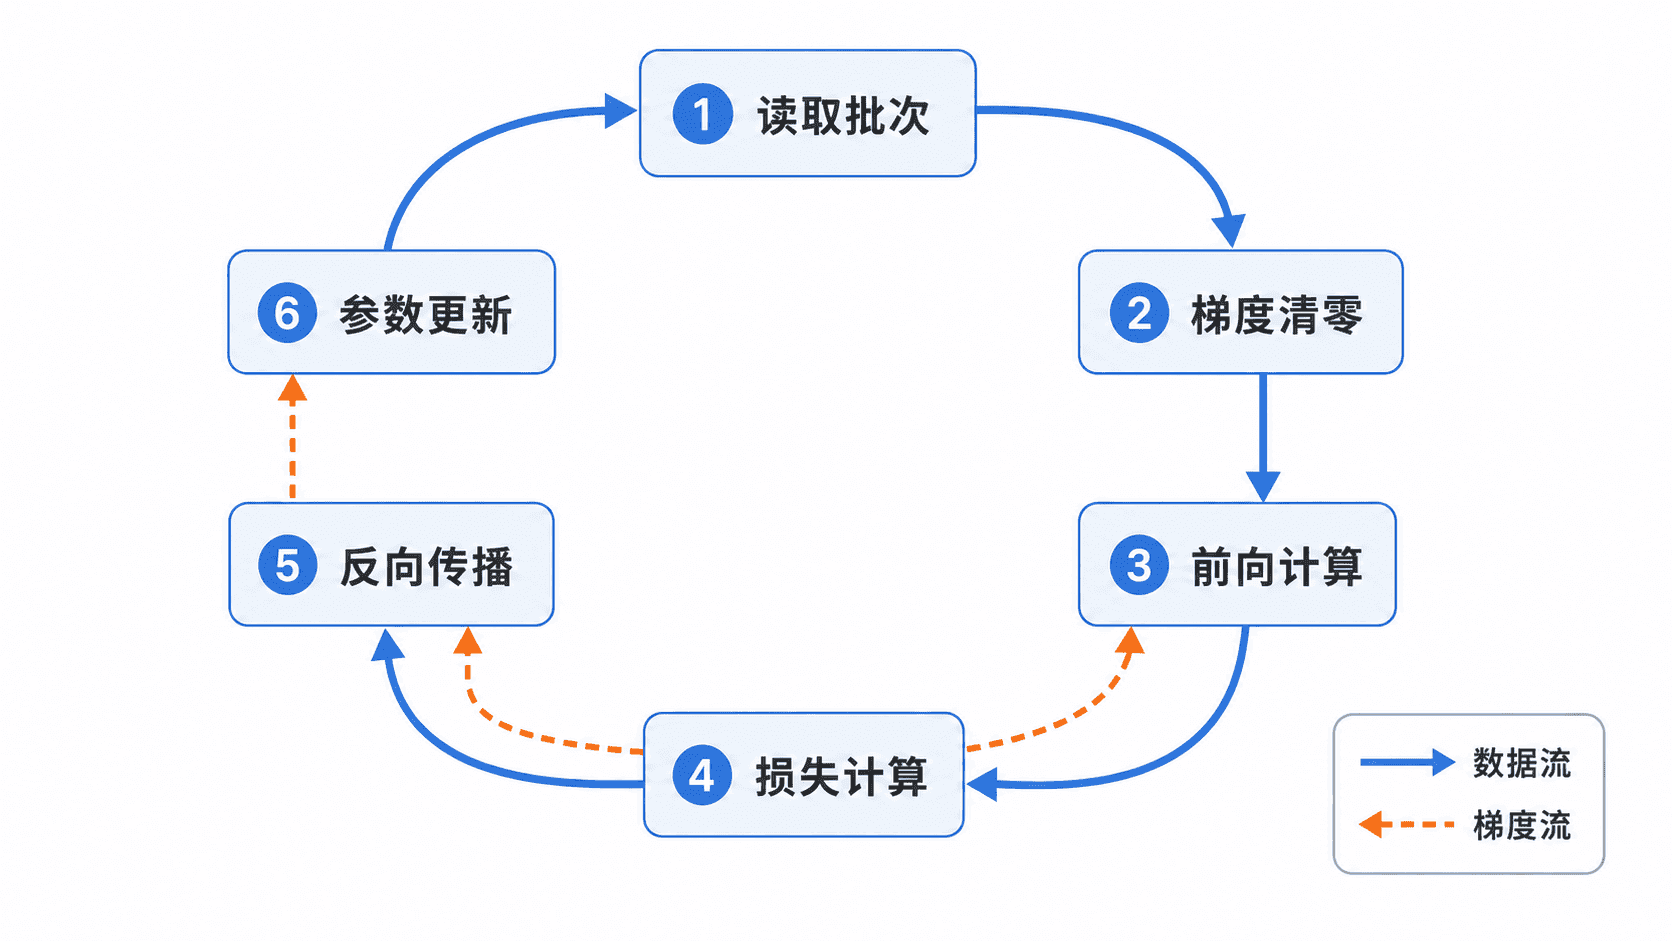
PyTorch 默认累加梯度,因此普通训练应在每个批次开始时调用 optimizer.zero_grad()。若遗漏这一步,本批次梯度会与上一批次叠加,参数更新结果就不再符合标准小批量训练。
完整训练示例
下面用线性模型拟合 。代码包含数据集、模型、损失函数、优化器和轮次统计,可保存为 train.py 后直接运行。
python
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

torch.manual_seed(42)

# 构造可重复的回归数据
x = torch.linspace(-1, 1, 100).unsqueeze(1)
y = 2 * x + 1
loader = DataLoader(TensorDataset(x, y), batch_size=20, shuffle=True)

model = nn.Linear(1, 1)
loss_fn = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)

for epoch in range(1, 11):
    model.train()
    total_loss = 0.0
    total_samples = 0

    for batch_x, batch_y in loader:
        optimizer.zero_grad()
        predictions = model(batch_x)
        loss = loss_fn(predictions, batch_y)
        loss.backward()
        optimizer.step()

        # 按样本数加权,兼容最后一个不足批大小的批次
        batch_size = batch_x.size(0)
        total_loss += loss.item() * batch_size
        total_samples += batch_size

    if epoch in (1, 5, 10):
        average_loss = total_loss / total_samples
        print(f"epoch={epoch}, loss={average_loss:.6f}")

print(f"weight={model.weight.item():.3f}, bias={model.bias.item():.3f}")预期输出如下。<LOSS> 是可能随设备和版本略有变化的数值,但应持续下降;最终参数应接近权重 2、偏置 1。
text
epoch=1, loss=<LOSS>
epoch=5, loss=<LOSS>
epoch=10, loss=<LOSS>
weight=<接近 2.000>, bias=<接近 1.000>
顺序与统计边界
标准顺序是 zero_grad()、前向计算、损失计算、backward()、step()。model.train() 只负责切换 Dropout、BatchNorm 等模块的训练行为,不会自动计算梯度或更新参数。
统计整轮损失时,应把 loss.item() 乘以当前批次样本数,再除以总样本数。直接平均各批次损失会让最后一个较小批次拥有与完整批次相同的权重。
Tips:只有在有意实现梯度累积时,才会跨多个批次延后调用
zero_grad()和step()。
本课总结
- 标准训练循环依次完成清零梯度、前向计算、损失计算、反向传播和参数更新
- PyTorch 梯度默认累加,普通训练必须主动清零
- 轮次损失应按样本数加权,避免小批次造成统计偏差
下一课预告
下一课将补齐验证与测试流程,学习如何关闭梯度记录、切换评估模式,并使用验证集选择最佳模型。
按自己的节奏,确认真正理解。