
机器学习与深度学习 / 系统课时
导数偏导与梯度
导数偏导与梯度
本课用“函数往哪个方向变化最快”串起导数、偏导数、方向导数和梯度。学完后,你能理解损失函数如何向每个参数传递更新方向。
学习目标
- 理解导数和偏导数描述的变化率
- 区分方向导数与梯度,并理解二者关系
- 能解释梯度下降为何沿负梯度方向更新参数
从一元导数看局部变化
对于一元函数 ,导数描述当 发生极小变化时, 在当前位置的变化速度。几何上,它等于曲线在该点切线的斜率。
导数为正,表示函数在该点附近随 增大而上升;导数为负,表示函数下降;导数接近零,说明曲线较平缓,但不一定已经达到最小值,因为它也可能处于最大值或鞍点附近。
多变量函数与偏导数
神经网络的损失函数通常依赖大量参数。对二元函数 ,偏导数表示只改变一个变量、暂时固定其他变量时的变化率:
偏导数把多变量问题拆成多个坐标方向上的局部变化。若损失函数依赖一百万个参数,就会有一百万个对应的偏导数。反向传播的任务,就是高效计算这些偏导数。
梯度把偏导数组成方向
梯度是由全部偏导数组成的向量。对于 :
梯度指向函数增长最快的方向,梯度长度表示最快增长的速率。要让损失下降,就应朝相反方向移动,也就是负梯度方向。
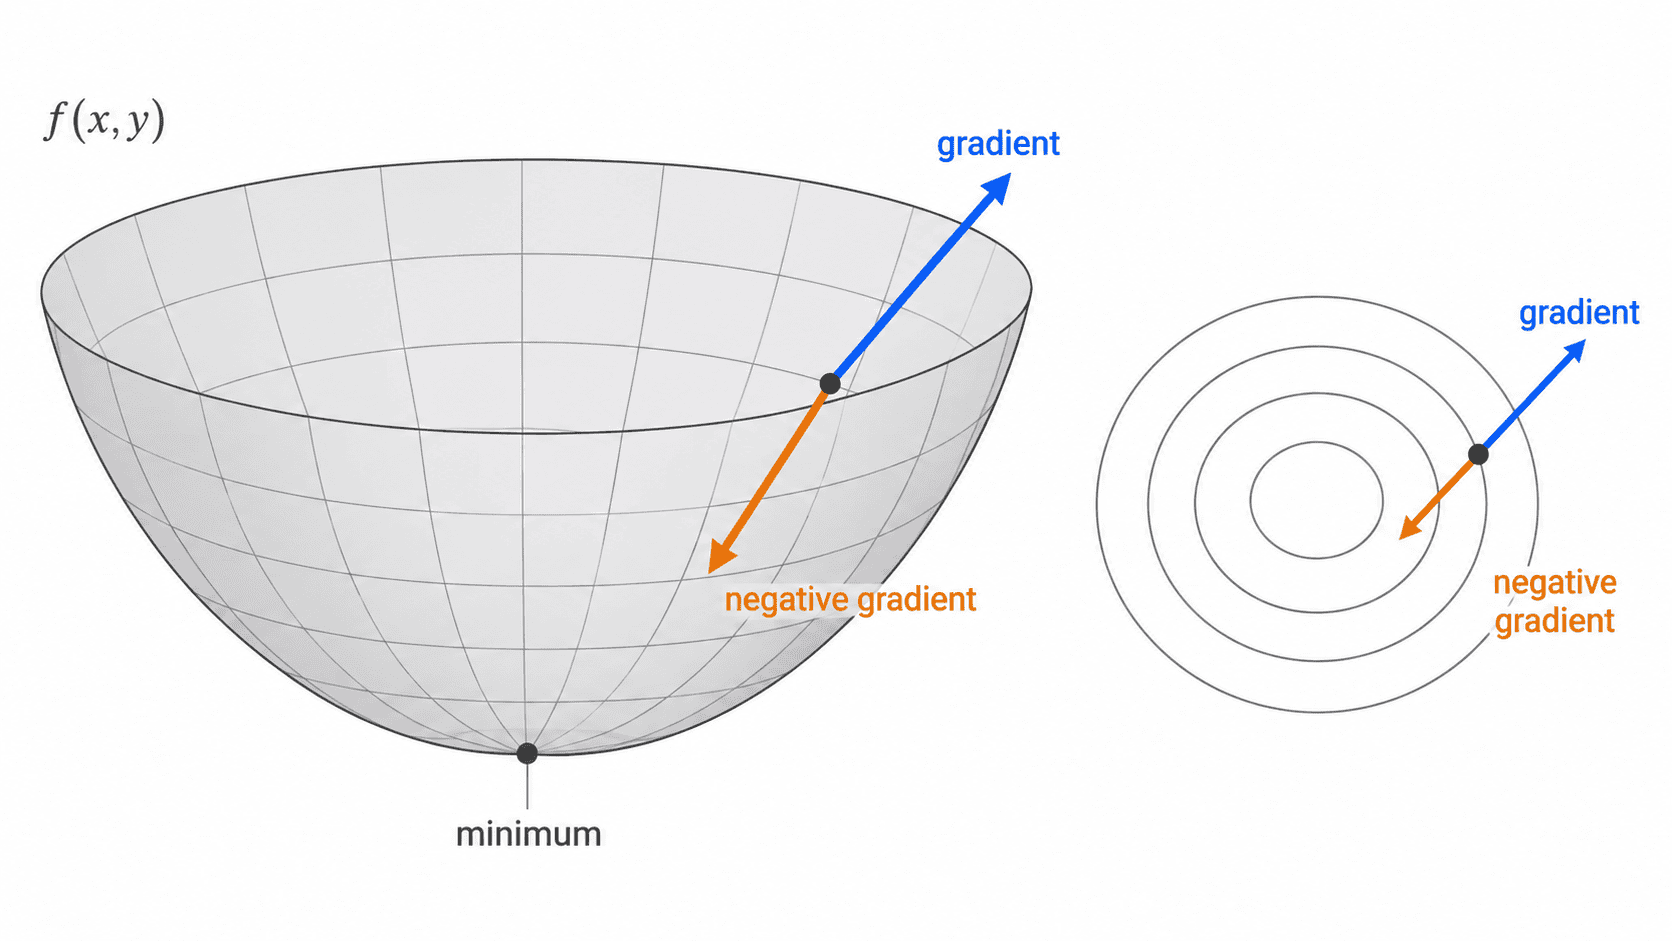
方向导数连接方向与变化率
偏导数只考察坐标轴方向,而方向导数可以考察任意单位方向 。它等于梯度与方向向量的点积:
点积会根据夹角决定结果。方向与梯度一致时,方向导数最大;方向与梯度相反时,方向导数最小;方向与梯度垂直时,方向导数为零。因此,梯度不仅保存各坐标轴上的偏导数,还统一描述了任意方向上的局部变化。
梯度下降如何更新参数
设参数向量为 ,损失函数为 ,学习率为 。梯度下降的更新规则是:
负号决定下降方向,学习率决定每一步走多远。学习率过大可能越过谷底并产生震荡,过小则会导致训练缓慢。梯度只反映当前位置附近的局部信息,因此一次更新后必须重新计算新的梯度。
在神经网络中,前向传播先得到预测和损失,反向传播再求出损失对各参数的梯度,优化器最后根据梯度更新参数。这三个步骤重复执行,模型才会逐渐减小损失。
常见误解
梯度为零不等于一定找到全局最小值,它也可能对应局部最大值、局部最小值或鞍点。梯度很大也不代表参数重要,只表示损失对该参数在当前位置较敏感。
Tips:导数、偏导数和梯度都属于局部信息。它们描述“当前位置附近怎么变”,不能单独保证最终会到达全局最优解。
本课总结
- 导数描述一元函数的局部变化率,偏导数描述多变量函数沿坐标轴方向的变化率
- 梯度由全部偏导数组成,指向函数增长最快的方向
- 梯度下降沿负梯度更新参数,学习率控制每一步的移动幅度
下一课预告
下一课将继续学习链式法则,理解复合函数的梯度如何逐层传递,并为反向传播建立数学基础。