
机器学习与深度学习 / 系统课时
最大似然与交叉熵
最大似然与交叉熵
本课解决“为什么分类模型通常用交叉熵训练”这个问题。你将从样本概率出发,依次建立最大似然、负对数似然与交叉熵的等价关系,并用一个可运行示例验证三者只是同一目标的不同写法。
学习目标
- 理解最大似然估计如何把“预测真实标签的概率”转化为训练目标
- 说明取对数后为何得到负对数似然
- 判断多分类交叉熵何时等价于负对数似然
从样本概率到最大似然
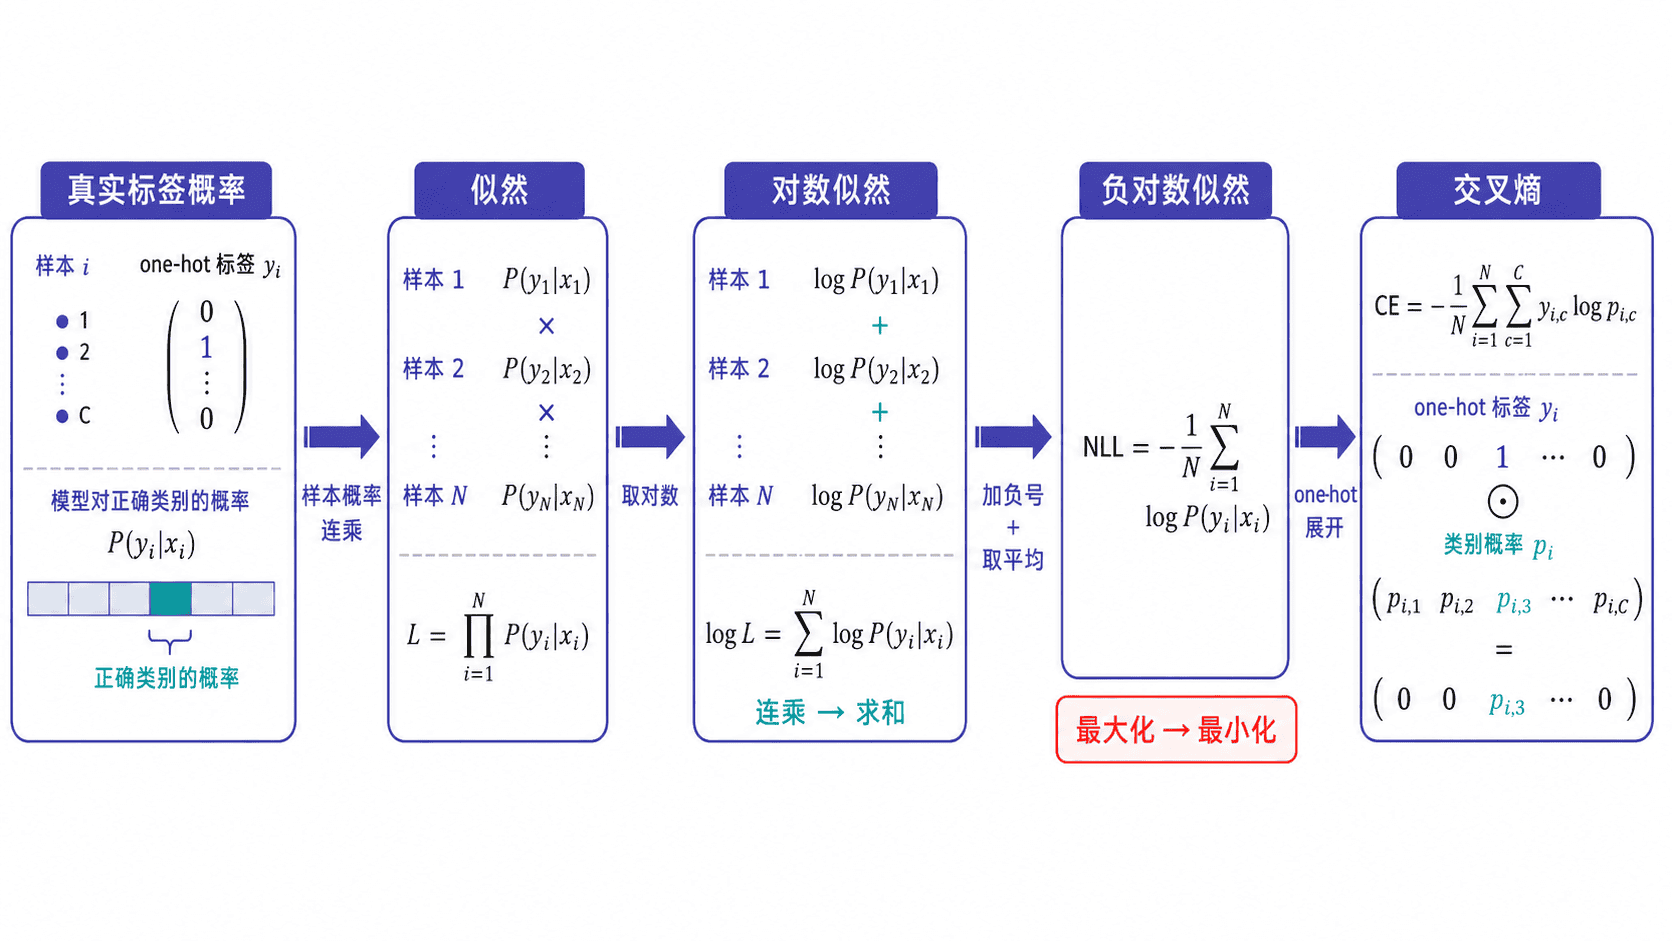
设分类模型对输入 给出条件概率 。训练数据已经告诉我们真实标签,因此一个自然目标是:让每个样本真实类别的预测概率都尽可能大。
若样本相互独立,整批数据同时出现的似然为:
最大似然估计就是寻找参数 ,使 最大。它关注的不是“模型整体看起来像不像”,而是模型是否把足够高的概率分配给了已经发生的真实标签。
为什么要取对数
概率通常小于 1,许多概率连乘后会非常接近 0,既不便计算,也不便求导。由于对数函数单调递增,最大化似然与最大化对数似然拥有相同最优解:
训练框架通常采用“最小化损失”的接口,因此再加一个负号,得到平均负对数似然:
真实类别概率越接近 1,负对数越接近 0;真实类别概率越接近 0,损失会急剧增大。这使模型对“自信但错误”的预测承担更大代价。
交叉熵为何等于负对数似然
对一个有 个类别的样本,令真实标签采用 one-hot 向量 ,模型输出类别概率 。多分类交叉熵为:
one-hot 向量只有真实类别位置为 1,其余位置为 0,因此求和后只剩 。这正是单个样本的负对数似然;对全部样本取平均后,就得到训练中常见的交叉熵损失。
这个等价关系有两个前提:模型输出表示合法的类别概率分布;标签表示从该分类分布中观测到的真实类别。若任务不是分类概率建模,交叉熵就不一定是合适的损失。
用代码验证三者关系
下面用三个样本验证:最大化似然、最大化对数似然、最小化平均负对数似然和最小化交叉熵,评价的是同一组真实类别概率。
import math

probabilities = [
    [0.9, 0.1],
    [0.2, 0.8],
    [0.7, 0.3],
]
labels = [0, 1, 0]

# 只取每个样本真实类别对应的预测概率
true_class_probs = [
    probabilities[i][labels[i]] for i in range(len(labels))
]

likelihood = math.prod(true_class_probs)
log_likelihood = sum(math.log(p) for p in true_class_probs)
nll = -log_likelihood / len(labels)

# one-hot 交叉熵化简后就是相同的负对数概率平均值
cross_entropy = -sum(
    math.log(probabilities[i][labels[i]]) for i in range(len(labels))
) / len(labels)

print(f"likelihood={likelihood:.6f}")
print(f"log_likelihood={log_likelihood:.6f}")
print(f"nll={nll:.6f}")
print(f"cross_entropy={cross_entropy:.6f}")
预期输出
likelihood=0.504000
log_likelihood=-0.685179
nll=0.228393
cross_entropy=0.228393
输出中 nll 与 cross_entropy 完全一致。似然越大,对数似然越大;同时负对数似然越小,因此只是优化方向和表达方式发生了变化。
使用时的关键边界
神经网络通常输出未归一化的 logits,而不是概率。实际训练应优先使用框架提供的交叉熵函数,让它在内部完成 log_softmax 与负对数似然计算,避免手动先做 Softmax 再取对数造成数值问题。
当真实类别概率为 0 时, 不存在。可靠实现不会直接对裸概率取对数,而会通过稳定的 LogSoftmax 或概率裁剪避免无穷大和 NaN。
还要确认损失的聚合方式。mean 表示样本平均,sum 表示直接求和;二者梯度尺度不同,会影响学习率和批量大小的配合。
本课总结
- 最大似然要求模型提高真实标签的联合概率
- 取对数并加负号后,最大化似然转化为最小化负对数似然
- one-hot 多分类任务中,交叉熵就是平均负对数似然
下一课预告
下一课将处理实际计算中的溢出、下溢与精度损失,并推导稳定版 Softmax 和 LogSumExp 的写法。