
机器学习与深度学习 / 系统课时
机器学习与深度学习的关系
机器学习与深度学习的关系
深度学习不是独立于机器学习的另一套体系,而是机器学习中的一类方法。本课将从学习目标和训练信号出发,梳理监督学习、无监督学习、自监督学习与强化学习之间的关系。
学习目标
- 说清人工智能、机器学习与深度学习的层级关系
- 区分四种常见学习范式使用的训练信号
- 能根据任务目标判断适合采用哪一种学习方式
从人工智能到深度学习
人工智能是让机器表现出感知、推理、生成或决策能力的总称。机器学习是其中一条主要实现路径,它不要求开发者写出全部规则,而是让算法从数据中学习规律。
深度学习属于机器学习,核心模型通常是多层神经网络。它可以用于多种学习范式,因此“深度学习”描述的是模型与表示学习方式,而“监督学习、自监督学习”等描述的是模型如何获得训练信号。
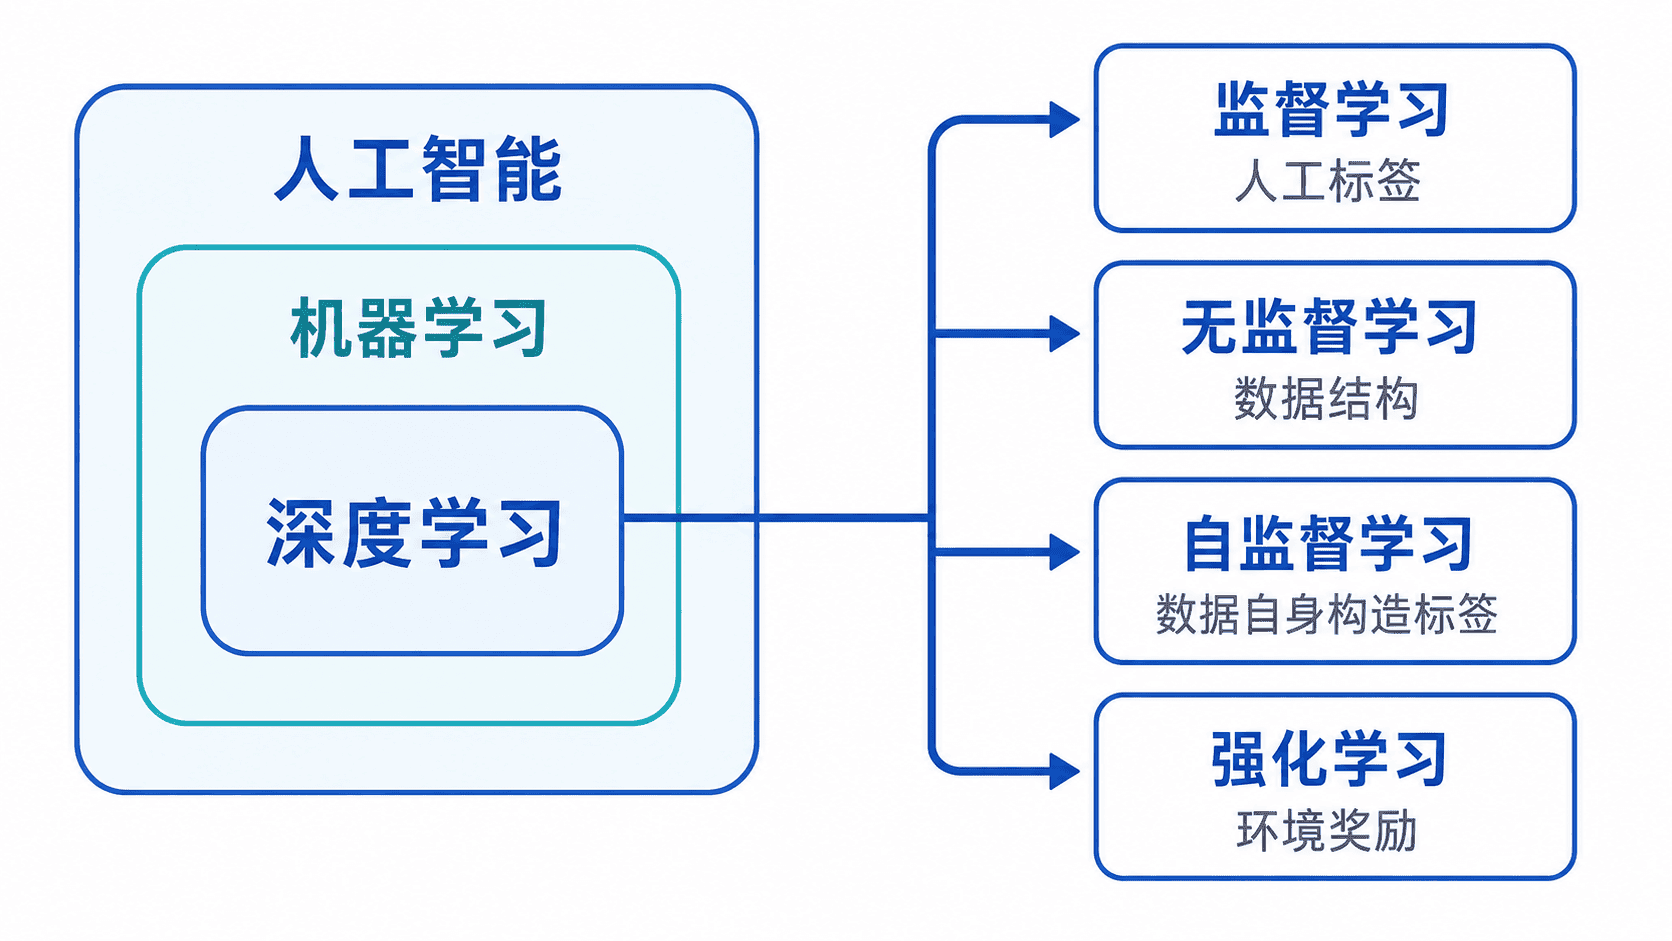
监督学习
监督学习使用成对的输入和目标答案训练模型。例如,图片配有“猫”或“狗”的标签,历史订单配有是否欺诈的结果。模型通过比较预测值与真实标签的差异来更新参数。
它适合分类、回归、检测和分割等目标明确的任务。主要限制是高质量标签往往需要人工制作,成本高,而且标签错误会直接影响模型上限。
无监督学习
无监督学习只有输入数据,没有人工提供的标准答案。模型尝试发现数据中的结构,例如把相似客户聚成一组、压缩高维特征,或识别异常样本。
这类方法适合探索数据和发现潜在模式,但结果不一定天然符合业务含义。聚类得到的分组仍需结合业务知识解释,不能把算法生成的类别直接当作真实结论。
自监督学习
自监督学习同样不依赖人工逐条标注,但会从数据本身构造训练目标。例如遮住句子中的部分词让模型预测,或隐藏图片区域让模型恢复内容。
它常用于大规模预训练。模型先从海量无标签数据中学习通用表示,再用少量标注数据完成具体任务,这也是许多语言模型和视觉模型的重要训练路径。
强化学习
强化学习关注智能体如何通过与环境交互获得长期收益。智能体执行动作,环境返回新状态和奖励,模型根据奖励调整策略。
它适合游戏、机器人控制、资源调度和序列决策。与监督学习不同,强化学习通常没有每一步的标准答案,奖励还可能延迟出现,因此训练更不稳定,也更依赖环境设计。
如何选择学习范式
选择时先看可获得的训练信号。如果有明确且足够的标签,监督学习通常最直接;没有标签但需要发现结构,可以考虑无监督学习;拥有大量原始数据且希望学习通用表示时,自监督学习更合适。
当问题包含连续动作、环境反馈和长期收益时,才应考虑强化学习。实际项目也可以组合使用,例如先自监督预训练,再监督微调,最后通过偏好奖励进一步优化模型行为。
| 学习范式 | 主要训练信号 | 典型目标 |
|---|---|---|
| 监督学习 | 人工或业务标签 | 分类、回归、检测 |
| 无监督学习 | 数据内部结构 | 聚类、降维、异常发现 |
| 自监督学习 | 从数据自动构造的目标 | 预训练、表示学习 |
| 强化学习 | 环境返回的奖励 | 决策、控制、策略优化 |
本课总结
- 深度学习属于机器学习,并可应用于多种学习范式
- 四种范式的关键差异在于训练信号来自标签、数据结构、自构造目标还是环境奖励
- 实际系统常组合多种范式,而不是只选择其中一种
下一课预告
下一课将进一步认识神经网络的基本组成,理解输入、权重、激活函数和输出如何共同完成一次预测。