
机器学习与深度学习 / 系统课时
归一化层的选择
归一化层的选择
归一化层会直接影响训练稳定性、收敛速度和模型对批大小的敏感程度。本课用计算维度、运行状态和任务形态三个标准,对比 BatchNorm、LayerNorm 与 GroupNorm,并给出可直接落地的选择方法。
学习目标
- 说清三种归一化层分别沿哪些维度计算统计量
- 根据批大小、网络结构和训练场景选择合适方案
- 在 PyTorch 中正确创建归一化层并验证张量形状
三种归一化在算什么
对形状为 [N, C, H, W] 的特征图,三种归一化最大的区别不是公式,而是“哪些元素共同计算均值和方差”。BatchNorm 按通道汇总整个批次与空间位置;GroupNorm 在单个样本内按通道分组;LayerNorm 则对每个样本指定的末尾维度独立计算。
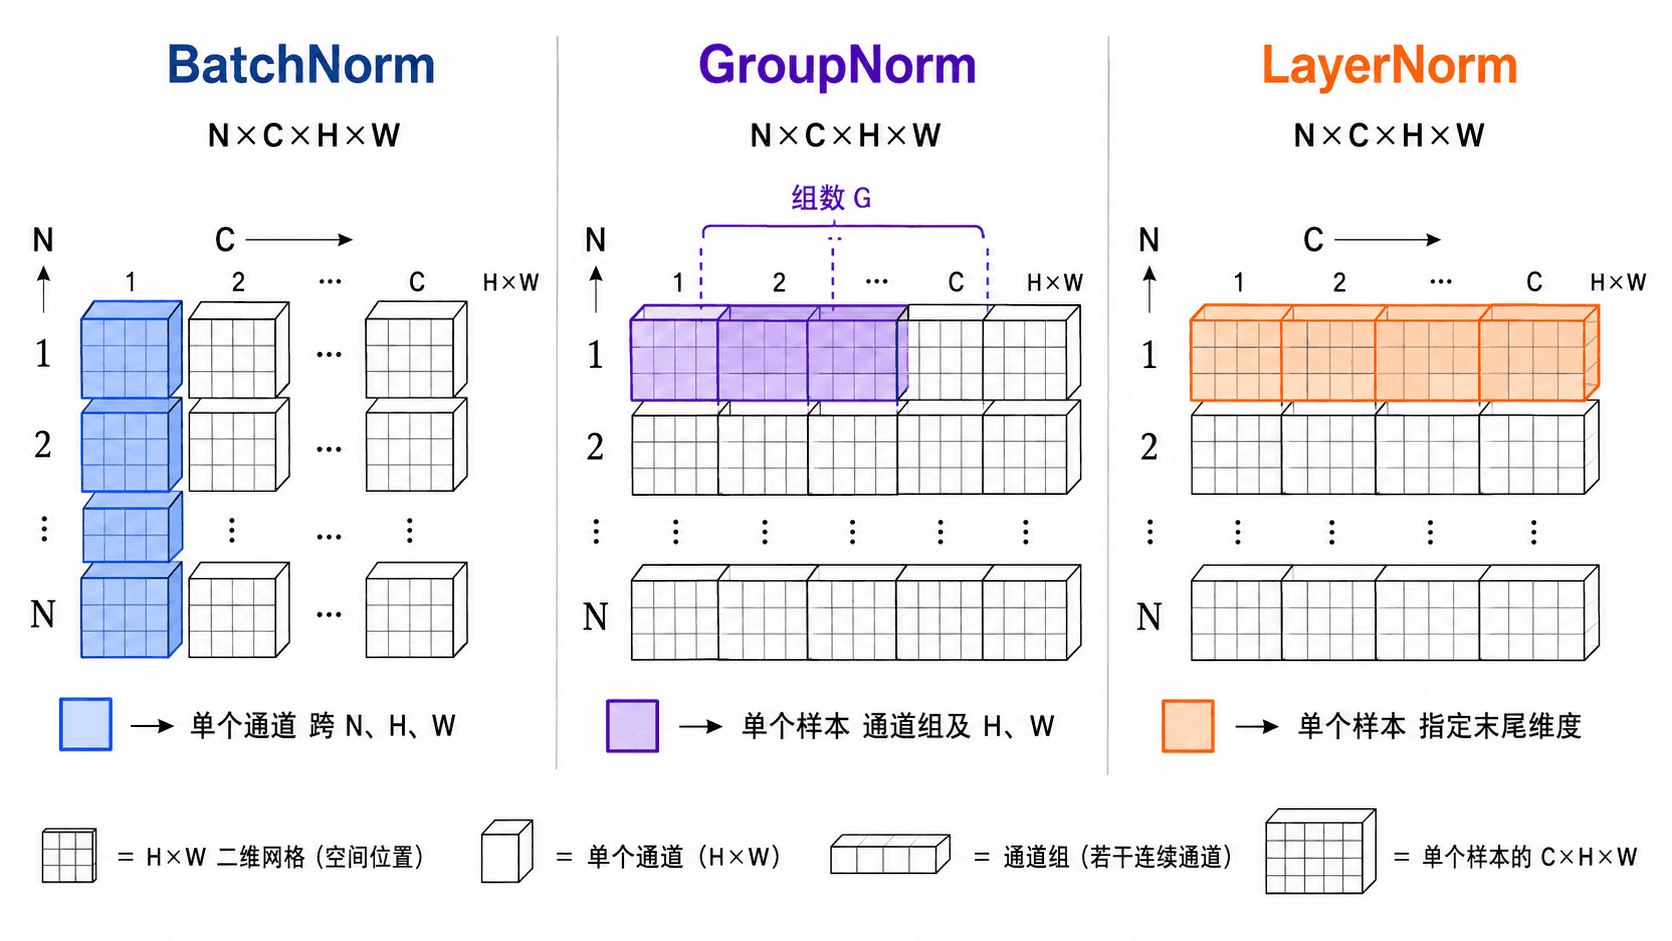
| 层 | 统计范围 | 是否依赖批次 | 常见场景 |
|---|---|---|---|
BatchNorm |
同一通道上的批次与空间位置 | 是 | 批次较稳定的 CNN |
LayerNorm |
单个样本指定的末尾维度 | 否 | Transformer、序列模型、MLP |
GroupNorm |
单个样本内每组通道与空间位置 | 否 | 小批次检测、分割和 CNN |
BatchNorm 在训练阶段使用当前批次统计量,并更新运行均值与运行方差;切换到评估模式后使用运行统计量。LayerNorm 和 GroupNorm 不依赖跨样本统计,因此训练与推理阶段的行为更一致。
按任务选择归一化层
批次足够大且每张卡上的有效批次稳定时,CNN 通常优先尝试 BatchNorm。它计算高效、实践成熟,但批次过小或样本分布波动明显时,统计量会变得不稳定。
Transformer 和大多数序列模型通常使用 LayerNorm,因为每个样本、每个位置都能独立归一化,不需要依赖同批次的其他样本。对于形状 [N, L, D] 的序列,LayerNorm(D) 会在最后的特征维度上计算。
目标检测、实例分割或高分辨率训练经常只能使用很小的批次,此时 GroupNorm 更可靠。组数必须整除通道数;常见起点是 8、16 或 32 组,再结合通道数调整。
Tips:不要把“哪一层更先进”当作选择标准。真正需要检查的是统计范围是否符合张量语义,以及训练时每个设备上的有效批次是否足够稳定。
PyTorch 主示例
下面分别处理 CNN 特征图和序列特征。示例只验证归一化层的接口与输出形状,不比较训练精度。
import torch
from torch import nn

# CNN 特征图:[批次, 通道, 高, 宽]
x_cnn = torch.randn(8, 32, 16, 16)
batch_norm = nn.BatchNorm2d(32)
group_norm = nn.GroupNorm(num_groups=8, num_channels=32)

# 序列特征:[批次, 序列长度, 特征维度]
x_seq = torch.randn(8, 20, 128)
layer_norm = nn.LayerNorm(128)

print("BatchNorm:", batch_norm(x_cnn).shape)
print("GroupNorm:", group_norm(x_cnn).shape)
print("LayerNorm:", layer_norm(x_seq).shape)
预期输出
BatchNorm: torch.Size([8, 32, 16, 16])
GroupNorm: torch.Size([8, 32, 16, 16])
LayerNorm: torch.Size([8, 20, 128])
三种层都保持输入形状不变,但内部统计范围不同。实际接入模型时,应确认归一化层声明的通道数或特征维度与输入完全一致。
关键边界与常见误区
BatchNorm 的 model.train() 与 model.eval() 不能混用。验证和推理前忘记调用 eval(),会继续使用当前批次统计量,导致结果随批次内容变化。
LayerNorm 的 normalized_shape 对应输入末尾连续维度,不等同于通道数。若输入是 [N, C, H, W],直接写 LayerNorm(C) 通常不会得到 CNN 中预期的按通道归一化效果。
GroupNorm 的组数不是越大越好。当组数等于通道数时接近 InstanceNorm;组数为 1 时接近对整个通道和空间范围做归一化。选择时要同时满足整除关系和足够的组内元素数。
本课总结
- BatchNorm 跨样本统计,适合有效批次稳定的 CNN
- LayerNorm 按样本处理末尾特征维度,是序列模型的常见选择
- GroupNorm 不依赖批次,适合小批次视觉任务
下一课预告
下一课将把泛化控制落到数据与训练流程中,学习如何设计不破坏标签的数据增强,并用早停与检查点保留最佳模型。