
机器学习与深度学习 / 系统课时
线性模型与神经元
线性模型与神经元
本课用一个完整计算过程说明神经元怎样接收输入、使用权重和偏置完成加权求和,并把线性回归、逻辑回归与神经网络中的单个神经元连接起来。学完后,你能读懂神经元公式,也能判断各参数在模型中的作用。
学习目标
- 理解权重、偏置与线性输出的含义
- 掌握单个神经元从输入到输出的计算过程
- 区分线性回归、逻辑回归与神经元之间的关系
从线性模型开始
最简单的线性模型可以写成 。其中, 是输入, 是权重, 是偏置, 是模型输出。权重决定输入变化会怎样影响结果,偏置则让模型在输入为零时仍能产生非零输出。
当输入不止一个时,模型会把每个输入分别乘以对应权重,再把结果相加:
这个加权求和结构就是神经元最核心的计算部分。线性回归直接把 作为预测值;神经网络中的神经元通常还会在 后面接一个激活函数。
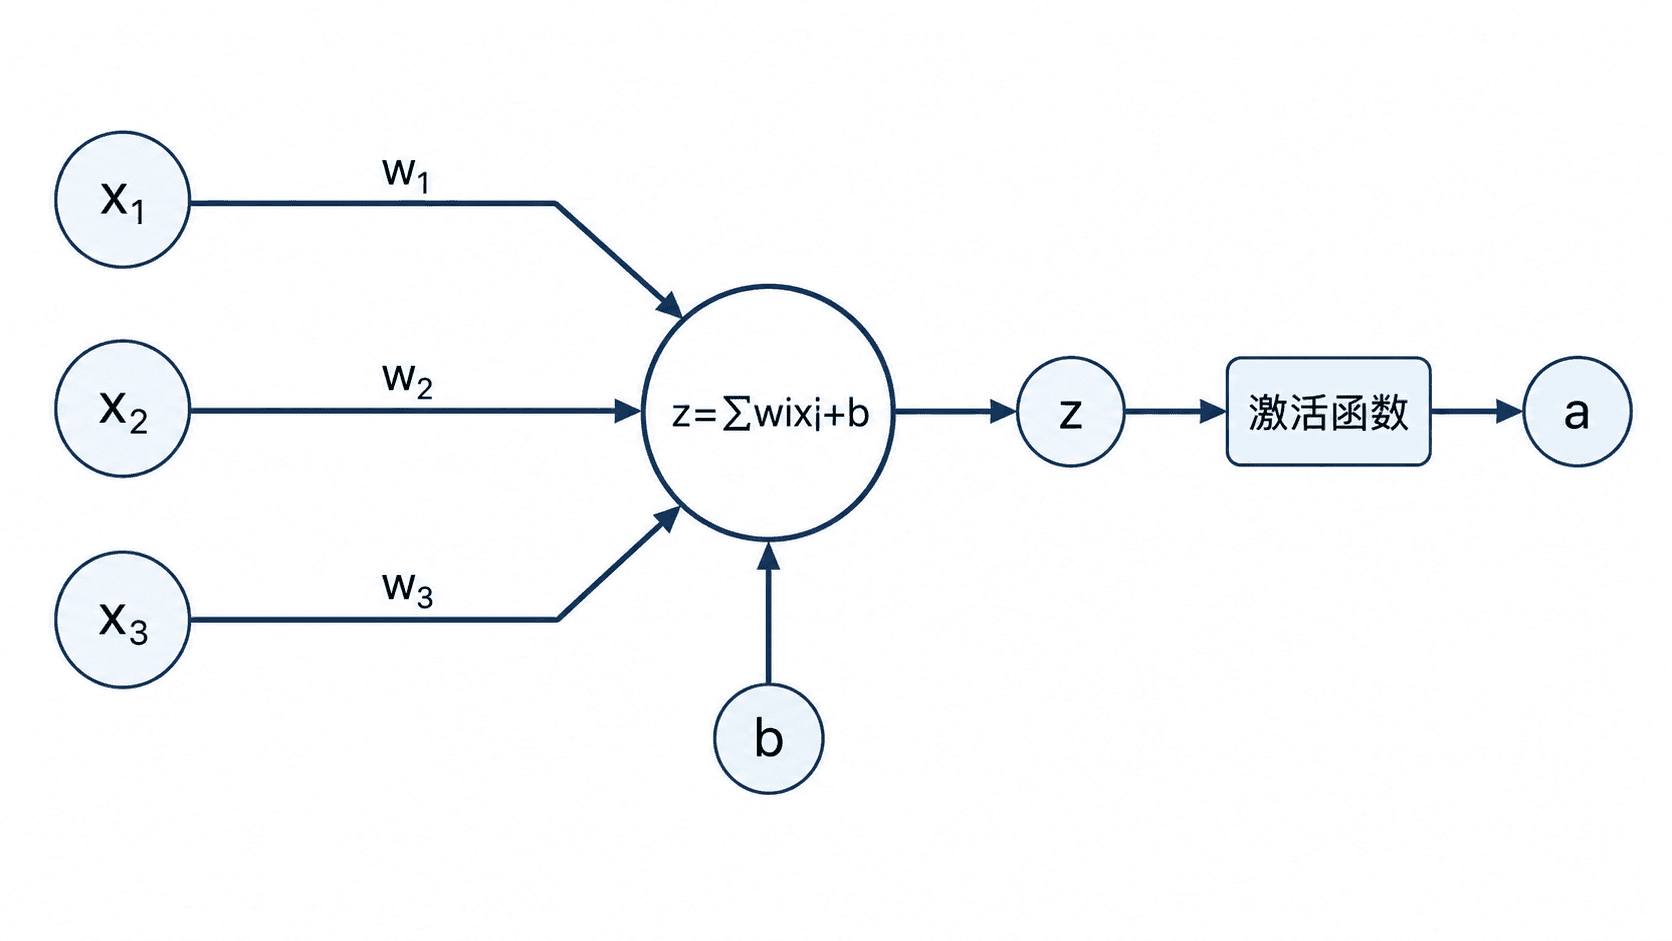
神经元如何得到输出
神经元通常分两步计算。第一步得到线性结果 ,第二步使用激活函数 生成最终输出 :
如果 ,神经元仍然只是线性模型。如果使用 Sigmoid,输出会被压缩到 0 和 1 之间,适合表示二分类中的概率。由此可见,线性部分负责组合特征,激活函数负责改变输出形态并引入非线性。
权重与偏置怎样影响结果
权重的绝对值越大,对应输入对当前神经元的影响通常越明显;权重为正时,输入增大会推动结果增大,权重为负时则会压低结果。但权重必须结合输入尺度理解,不能只看数值大小判断特征重要性。
偏置控制整体平移。以二维输入为例,方程 表示一条分类边界。改变权重会调整边界方向,改变偏置会让边界平行移动,因此偏置不是可有可无的常数,而是模型定位决策边界的重要参数。
二分类计算示例
设输入为 、,权重为 、,偏置为 。线性结果为:
若再使用 Sigmoid,输出约为 。当分类阈值设为 时,模型会把该样本判为正类。这个例子说明:输入本身不会直接产生结论,模型需要先用权重组合信息,再由偏置和激活函数共同决定最终输出。
易混淆点
- 神经元是数学计算单元,不是对生物神经元的完整复制
- 没有激活函数时,多层线性变换仍可合并成一次线性变换
- 权重描述当前模型中的影响方式,不等于绝对、稳定的因果关系
本课总结
- 神经元的核心是加权求和
- 权重控制输入影响方向与强度,偏置控制整体平移
- 线性模型加上不同激活函数后,可以承担回归或分类任务
下一课预告
下一课将比较 Sigmoid、Tanh、ReLU 和 GELU,理解激活函数为什么能让神经网络表达复杂的非线性关系。