
机器学习与深度学习 / 系统课时
目标检测任务结构
目标检测任务结构
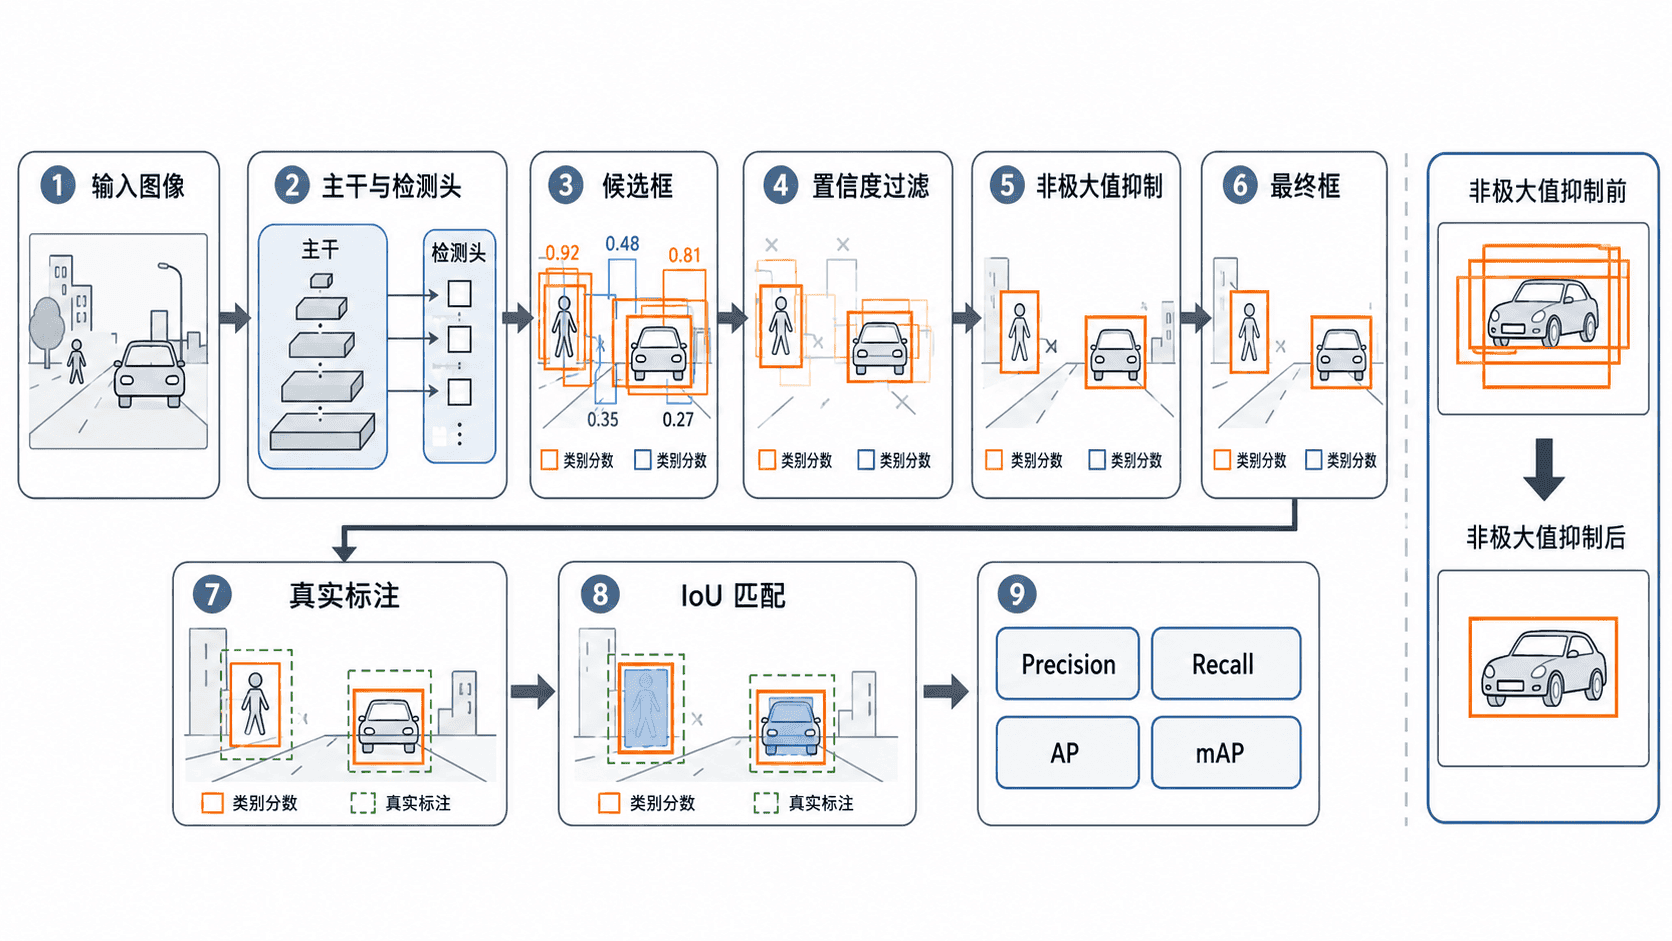
目标检测不仅要判断图像里有什么,还要指出每个目标在哪里。本课将把一次检测预测拆成边界框、类别得分、IoU、非极大值抑制与评估匹配五个环节,建立可直接用于读模型输出的结构化认识。
学习目标
- 读懂检测模型输出中的位置、类别与置信度
- 使用 IoU 判断两个边界框的重叠程度
- 理解 NMS 去重过程以及 AP、mAP 的评估链路
检测输出由什么组成
一个候选检测结果通常包含边界框、类别和置信度。边界框常写成 (x1, y1, x2, y2),其中前两个值是左上角坐标,后两个值是右下角坐标;也有模型使用中心点、宽和高表示,进入后处理前需要统一格式。
模型会同时产生大量候选框。多个候选框可能指向同一个真实目标,因此原始输出不能直接作为最终结果,还要经过分数过滤和去重。
IoU 衡量边界框重叠
交并比 IoU 用两个框的交集面积除以并集面积:
IoU 越接近 1,两个框越重合;越接近 0,重叠越少。训练时它可用于匹配预测框与真实框,后处理时它用于判断两个高分候选框是否可能描述同一目标,评估时则用于确定预测是否达到“正确定位”的阈值。
IoU 只衡量位置重叠,不代表类别正确,也不等于模型置信度。一个框即使 IoU 很高,类别预测错误时仍不能算正确检测。
NMS 如何删除重复框
非极大值抑制 NMS 通常按类别分别执行。它先选择置信度最高的框,再删除与该框 IoU 超过阈值的同类候选框,重复此过程直到没有候选框。
下面的纯 Python 示例实现 IoU 和按类别 NMS。坐标按连续平面处理,因此面积计算不额外加 1。
from typing import List, Tuple

Box = Tuple[float, float, float, float, float, str]

def iou(a: Box, b: Box) -> float:
    inter_width = max(0.0, min(a[2], b[2]) - max(a[0], b[0]))
    inter_height = max(0.0, min(a[3], b[3]) - max(a[1], b[1]))
    intersection = inter_width * inter_height

    area_a = max(0.0, a[2] - a[0]) * max(0.0, a[3] - a[1])
    area_b = max(0.0, b[2] - b[0]) * max(0.0, b[3] - b[1])
    union = area_a + area_b - intersection
    return intersection / union if union > 0 else 0.0

def nms_by_class(boxes: List[Box], threshold: float = 0.5) -> List[Box]:
    kept: List[Box] = []

    # 不同类别分别去重,避免一个类别错误压制另一个类别
    for label in sorted({box[5] for box in boxes}):
        candidates = sorted(
            [box for box in boxes if box[5] == label],
            key=lambda box: box[4],
            reverse=True,
        )

        while candidates:
            best = candidates.pop(0)
            kept.append(best)
            candidates = [
                box for box in candidates
                if iou(best, box) < threshold
            ]

    return sorted(kept, key=lambda box: box[4], reverse=True)

boxes: List[Box] = [
    (10, 10, 50, 50, 0.95, "cat"),
    (12, 12, 48, 48, 0.88, "cat"),
    (60, 10, 100, 50, 0.80, "cat"),
    (11, 11, 49, 49, 0.92, "dog"),
]

print(f"IoU(A, B)={iou(boxes[0], boxes[1]):.2f}")
for box in nms_by_class(boxes, threshold=0.5):
    print(box[5], box[4], list(box[:4]))
预期输出
IoU(A, B)=0.81
cat 0.95 [10, 10, 50, 50]
dog 0.92 [11, 11, 49, 49]
cat 0.8 [60, 10, 100, 50]
第二个猫框与最高分猫框高度重叠,因此被删除;狗框虽然位置几乎相同,但类别不同,所以在按类别 NMS 中保留。
从最终框到检测指标
评估时,预测框会按置信度排序,并与同类别真实框进行一对一匹配。达到指定 IoU 阈值且尚未占用真实框的预测记为 TP;未匹配预测记为 FP;没有被任何预测匹配的真实目标记为 FN。
Precision 衡量输出框中有多少是正确的,Recall 衡量真实目标中有多少被找到。随着置信度阈值变化,可得到一条 Precision-Recall 曲线;曲线下的汇总结果是 AP,多类别 AP 的平均值是 mAP。
不同评测协议可能使用单一 IoU 阈值,也可能对多个阈值求平均。因此比较模型时,必须确认类别集合、IoU 阈值范围、最大检测数量和难例处理规则一致。
常见误区
- 把分类准确率当作检测主指标,忽略定位质量和漏检
- 在所有类别之间直接执行 NMS,导致不同类别互相压制
- 只调高置信度阈值来减少误检,却没有检查召回率下降
- 把 IoU 阈值、置信度阈值和 NMS 阈值混为同一个参数
本课总结
- 检测结果由位置、类别和置信度共同构成,原始候选框还需后处理
- IoU 负责衡量位置重叠,NMS 负责删除同类重复预测
- AP 与 mAP 来自预测框和真实框的匹配流程,而不是普通分类准确率
下一课预告
下一课将把这些结构应用到实际检测模型中,继续学习如何替换检测头、准备标注数据并验证迁移学习效果。