
机器学习与深度学习 / 系统课时
常见网络架构地图
常见网络架构地图
本课用“数据结构”和“任务目标”两条线索整理常见网络架构。你将知道多层感知机、卷积网络、循环网络、Transformer 与生成模型各自擅长什么,并能为一个新任务选出合理的起始方案。
学习目标
- 说出五类常见架构的核心特征与典型适用场景
- 根据表格、图像、序列和生成任务选择初始架构
- 区分网络骨干、建模目标与具体模型名称,避免把不同层级概念混为一谈
先用两个坐标看架构
选择架构时,先看输入中最重要的结构关系。表格数据强调特征组合,图像强调局部空间关系,序列强调顺序与上下文。再看输出目标是分类、回归、预测未来,还是生成新内容。架构不是按“新旧”排序,而是按归纳偏置是否匹配任务来选择。
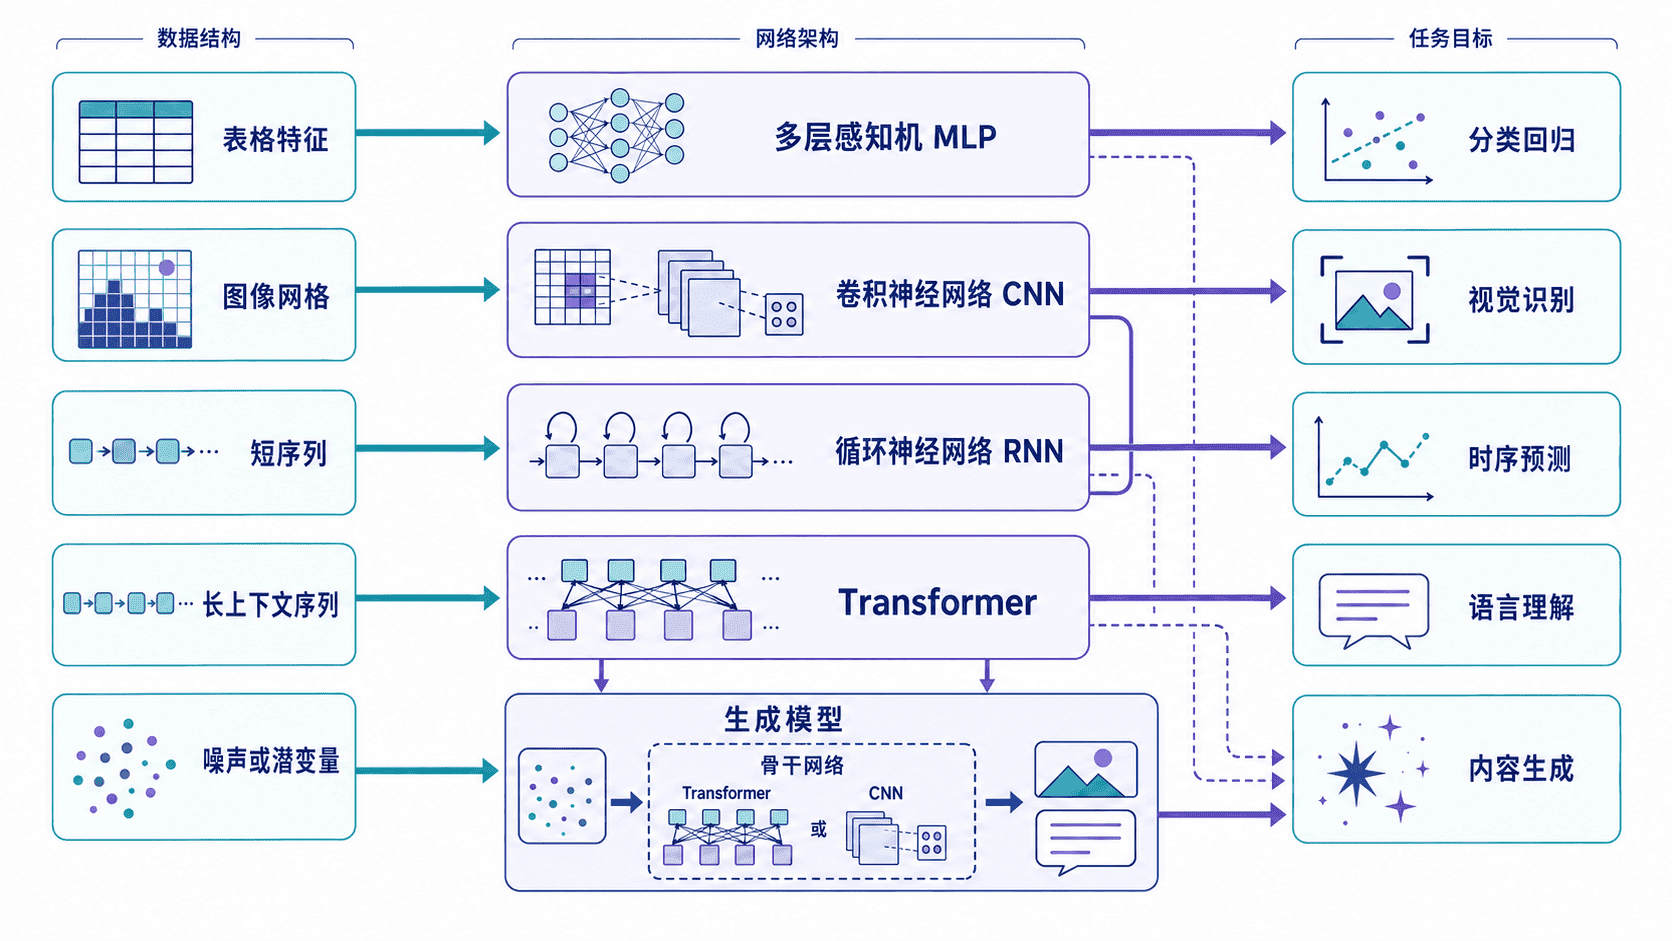
这张图表达的是“优先匹配关系”,不是绝对边界。例如 Transformer 也能处理图像,卷积网络也能用于音频;当数据量、延迟和部署环境变化时,最终选择可能不同。
五类架构的核心定位
| 架构 | 最重要的结构假设 | 常见任务 | 主要特点 |
|---|---|---|---|
| 多层感知机 MLP | 输入可表示为固定长度特征 | 表格分类、回归、简单基线 | 结构直接,但不主动利用空间或顺序 |
| 卷积神经网络 CNN | 邻近位置存在局部相关性 | 图像识别、检测、分割、音频特征 | 参数共享,擅长提取局部模式 |
| 循环神经网络 RNN | 当前状态依赖之前的信息 | 短序列、流式时序、轻量预测 | 按顺序处理,长依赖训练较困难 |
| Transformer | 任意位置可通过注意力建立关系 | 文本、长序列、多模态、视觉任务 | 并行训练能力强,长上下文计算成本较高 |
| 生成模型 | 学习数据分布并产生新样本 | 文本、图像、音频生成与编辑 | 包含自回归、VAE、GAN、扩散等路线 |
生成模型与前四类不完全处在同一层级。前四类更像计算骨干,生成模型更强调学习目标和生成方式。例如大语言模型通常使用 Transformer 骨干并采用自回归生成目标,扩散图像模型常使用卷积或 Transformer 组件完成去噪。
按任务选择起始架构
面对结构化表格,先建立线性模型或树模型基线,再考虑 MLP;深度网络并不天然优于传统机器学习。面对图像且数据规模有限,CNN 往往是稳定起点;需要统一处理图像与文本时,可进一步考虑视觉 Transformer 或多模态架构。
序列任务要区分依赖长度和运行方式。小型传感器流、逐步到达的数据或严格低延迟场景,可以从 RNN 及其变体开始;长文本、跨位置关系和大规模并行训练更适合 Transformer。目标是生成内容时,还要继续选择自回归、扩散、对抗生成或变分方法。
用代码建立选择器
下面的纯 Python 示例把选择逻辑压缩成一个可运行的起点。它不能替代实验,但能帮助你先按数据结构与目标排除明显不匹配的方案。
def choose_architecture(data_type, goal="predict", long_dependency=False):
    # 先判断生成目标,因为它会跨越多种输入类型和骨干网络
    if goal == "generate":
        return "生成模型(骨干可用 Transformer 或卷积网络)"
    if data_type == "tabular":
        return "多层感知机 MLP"
    if data_type == "image":
        return "卷积神经网络 CNN"
    if data_type == "sequence":
        return "Transformer" if long_dependency else "循环神经网络 RNN"
    return "先建立简单基线,再依据数据结构选择"

# 用代表性任务验证每条选择分支
cases = [
    ("客户流失预测", {"data_type": "tabular"}),
    ("产品缺陷识别", {"data_type": "image"}),
    ("短期传感器预测", {"data_type": "sequence"}),
    ("长文档问答", {"data_type": "sequence", "long_dependency": True}),
    ("文生图", {"data_type": "image", "goal": "generate"}),
]

for task_name, conditions in cases:
    print(f"{task_name}: {choose_architecture(**conditions)}")
预期输出:
客户流失预测: 多层感知机 MLP
产品缺陷识别: 卷积神经网络 CNN
短期传感器预测: 循环神经网络 RNN
长文档问答: Transformer
文生图: 生成模型(骨干可用 Transformer 或卷积网络)
选择器只表达第一轮判断。实际项目还要比较数据量、训练成本、推理延迟、可解释性和已有工程能力,并通过统一数据集与指标做基线实验。
容易混淆的边界
Transformer 不等于语言模型,它是一类可用于文本、图像、语音和多模态任务的架构。RNN 也没有完全失去价值,在模型较小、数据连续到达或设备资源有限时,顺序计算仍可能更合适。
同一任务通常存在多种可行架构。正确做法不是先追逐最复杂模型,而是先用最小基线验证数据和指标,再逐步增加结构复杂度。只有当新架构在准确率、延迟或成本上带来可复现收益时,升级才有意义。
本课总结
- MLP、CNN、RNN 和 Transformer 的主要差异,在于它们如何利用特征、空间与序列关系
- 生成模型更强调生成目标和概率建模方式,内部仍可使用 Transformer 或卷积网络
- 架构选择应从数据结构、任务目标和工程约束出发,并通过基线实验验证
下一课预告
下一课将进一步区分训练、推理与部署,说明同一个模型在三个阶段分别消耗什么资源、产生什么产物,以及为什么线上运行方式与训练环境不同。