
机器学习与深度学习 / 系统课时
生成对抗网络
生成对抗网络
生成对抗网络通过两个目标相反的模型学习数据分布:生成器制造样本,判别器识别真伪。本课将拆解一次完整的对抗训练流程,并通过最小 PyTorch 示例观察两个模型如何交替更新。
学习目标
- 理解生成器与判别器各自接收什么输入、优化什么目标
- 掌握一次判别器更新和一次生成器更新的正确顺序
- 能识别模式坍塌、梯度消失和训练失衡等常见不稳定来源
生成器与判别器如何博弈
生成器 把随机噪声 映射成伪样本 ;判别器 接收真实样本或伪样本,并输出其为真实数据的概率。训练目标不是让两个模型同时变得“更准确”,而是让它们在相反目标下持续博弈。
经典极小极大目标为:
判别器希望真实样本得分接近 1、伪样本得分接近 0;生成器则希望伪样本被判别为真实。理想状态下,生成分布接近真实分布,判别器无法再稳定区分两者。
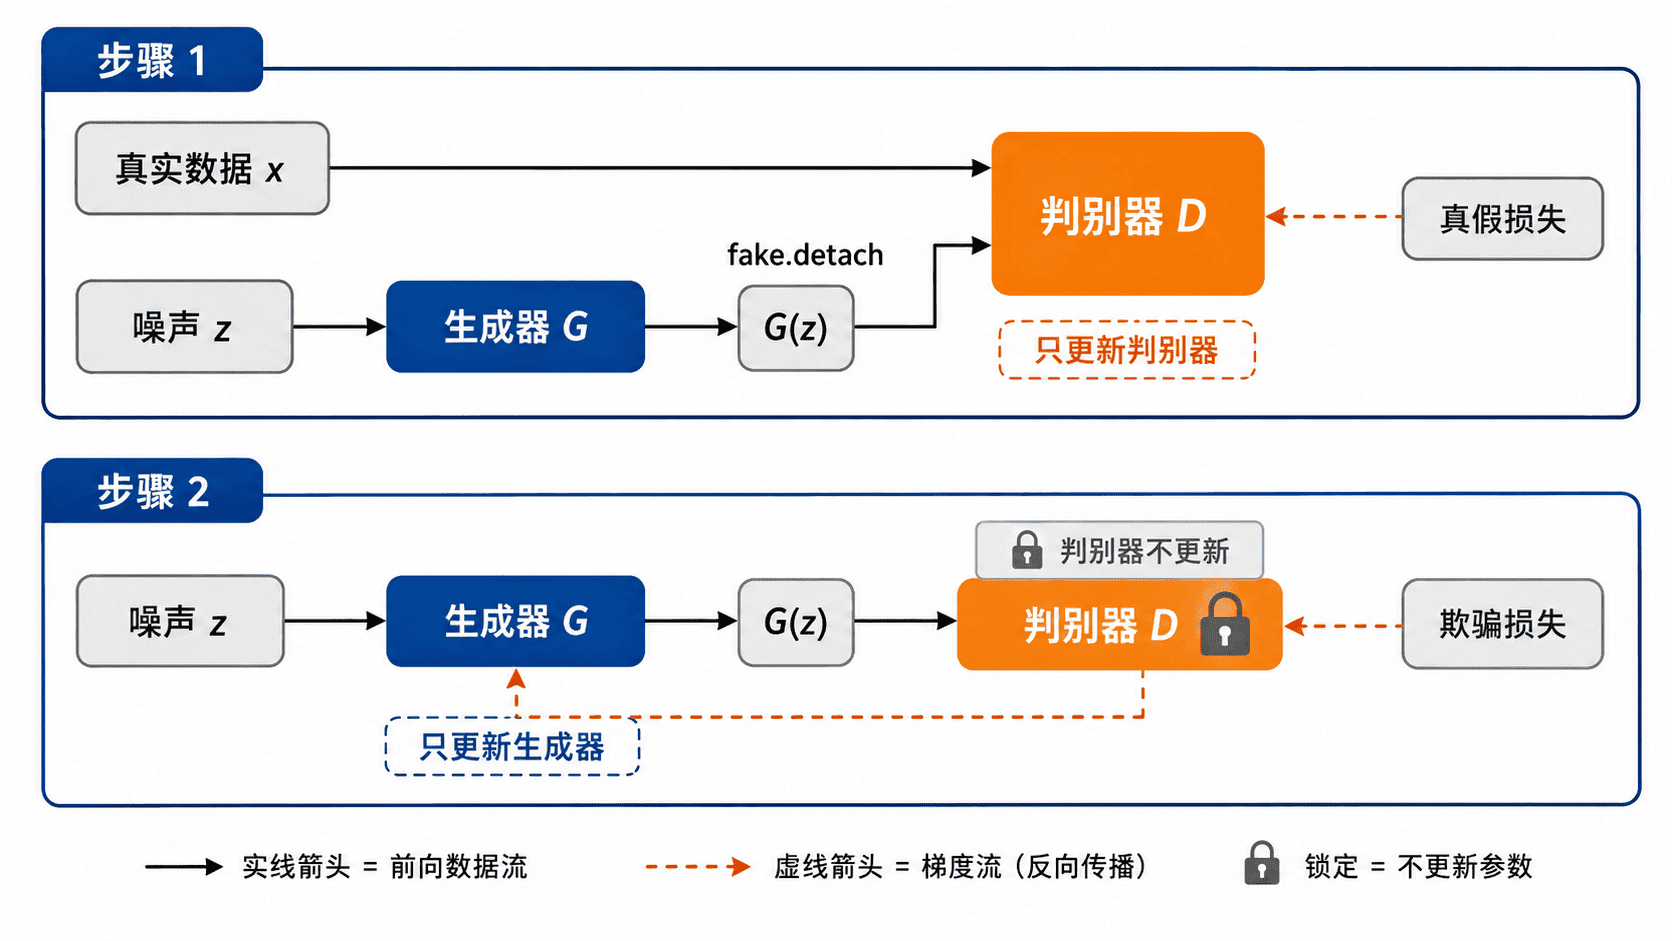
一轮对抗训练的执行顺序
第一步训练判别器。先计算真实样本的判别损失,再生成一批伪样本并计算伪样本损失。此时伪样本必须从生成器计算图中分离,否则判别器反向传播时也会把梯度传入生成器。
第二步训练生成器。重新生成伪样本并交给判别器,但不更新判别器参数。生成器把这些伪样本的目标标签设为“真实”,通过判别器反馈的梯度调整自身参数。
两个步骤必须分别清零梯度、反向传播和更新参数。若把两个优化器混在同一次反向传播中,容易产生重复计算、梯度污染或参数更新顺序错误。
最小可运行示例
下面使用一维高斯数据模拟真实分布。示例只执行一轮判别器更新和一轮生成器更新,并验证损失有限、生成器参数确实发生变化。
import torch
from torch import nn

class Generator(nn.Module):
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, 8),
            nn.ReLU(),
            nn.Linear(8, 1),
        )

    def forward(self, z: torch.Tensor) -> torch.Tensor:
        return self.net(z)

class Discriminator(nn.Module):
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(1, 8),
            nn.LeakyReLU(0.2),
            nn.Linear(8, 1),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.net(x)

torch.manual_seed(11)
generator = Generator()
discriminator = Discriminator()
g_optimizer = torch.optim.Adam(generator.parameters(), lr=1e-3)
d_optimizer = torch.optim.Adam(discriminator.parameters(), lr=1e-3)
criterion = nn.BCEWithLogitsLoss()

real = torch.randn(32, 1) * 0.4 + 2.0
noise = torch.randn(32, 3)
fake = generator(noise)

# 判别器更新时切断 fake 到生成器的梯度路径。
d_optimizer.zero_grad()
real_loss = criterion(discriminator(real), torch.ones(32, 1))
fake_loss = criterion(discriminator(fake.detach()), torch.zeros(32, 1))
d_loss = real_loss + fake_loss
d_loss.backward()
d_optimizer.step()

before = [parameter.detach().clone() for parameter in generator.parameters()]

# 生成器借助判别器的梯度学习,但只更新自身参数。
g_optimizer.zero_grad()
new_fake = generator(torch.randn(32, 3))
g_loss = criterion(discriminator(new_fake), torch.ones(32, 1))
g_loss.backward()
g_optimizer.step()

changed = any(
    not torch.equal(old, new)
    for old, new in zip(before, generator.parameters())
)

print("d_step_finite:", bool(torch.isfinite(d_loss)))
print("g_step_finite:", bool(torch.isfinite(g_loss)))
print("generator_changed:", changed)
预期输出:
d_step_finite: True
g_step_finite: True
generator_changed: True
generator_changed 为 True 说明第二阶段确实更新了生成器。示例没有打印具体损失值,因为它们会随 PyTorch 版本和硬件实现产生轻微差异,但是否为有限值以及参数是否更新应保持一致。
训练为什么容易不稳定
模式坍塌是最典型的问题。生成器可能只找到少数几类最容易欺骗判别器的输出,导致不同噪声产生高度相似的样本。此时判别器损失看似正常,生成结果却缺乏多样性。
若判别器学习过快,它会轻易识别所有伪样本,生成器收到的有效梯度会变弱;若生成器学习过快,判别器又无法提供可靠反馈。两个网络的目标随对方更新不断变化,因此 GAN 优化的不是一个静态损失面,而是一个动态博弈过程。
损失震荡也不一定意味着训练失败。GAN 的损失值通常不能像分类任务那样直接代表样本质量,需要结合固定噪声生成结果、样本多样性以及 FID 等指标共同判断。
稳定训练的基本策略
首先保证数据归一化范围与生成器输出激活匹配,例如生成器末层使用 Tanh 时,真实图像通常缩放到 。其次可以降低判别器容量、调整两个优化器的学习率,避免一方长期压制另一方。
经典 GAN 常把生成器损失改成最大化 ,等价实现为让伪样本标签取 1 并最小化二元交叉熵,这能在训练早期提供更强梯度。更复杂任务还可使用谱归一化、梯度惩罚或 Wasserstein 距离,但应先确认基础训练流程与数据预处理无误。
本课总结
- GAN 由生成器和判别器组成,两者通过相反目标交替更新
- 判别器阶段需要分离伪样本计算图,生成器阶段只更新生成器参数
- 模式坍塌、梯度变弱和双方能力失衡是训练不稳定的主要来源
下一课预告
下一课将继续比较不同生成模型的建模方式,重点理解扩散模型如何通过逐步加噪与去噪生成高质量样本。