
机器学习与深度学习 / 系统课时
构建多层感知机
构建多层感知机
本课将用 PyTorch 搭建一个可直接运行的多层感知机,把输入特征依次送入隐藏层和输出层,并通过形状与参数量验证网络结构是否正确。
学习目标
- 理解输入层、隐藏层和输出层在前馈网络中的职责
- 使用
nn.Module、nn.Linear和激活函数搭建多层感知机 - 通过输出形状与参数量检查模型是否符合设计
从网络结构到 PyTorch 模块
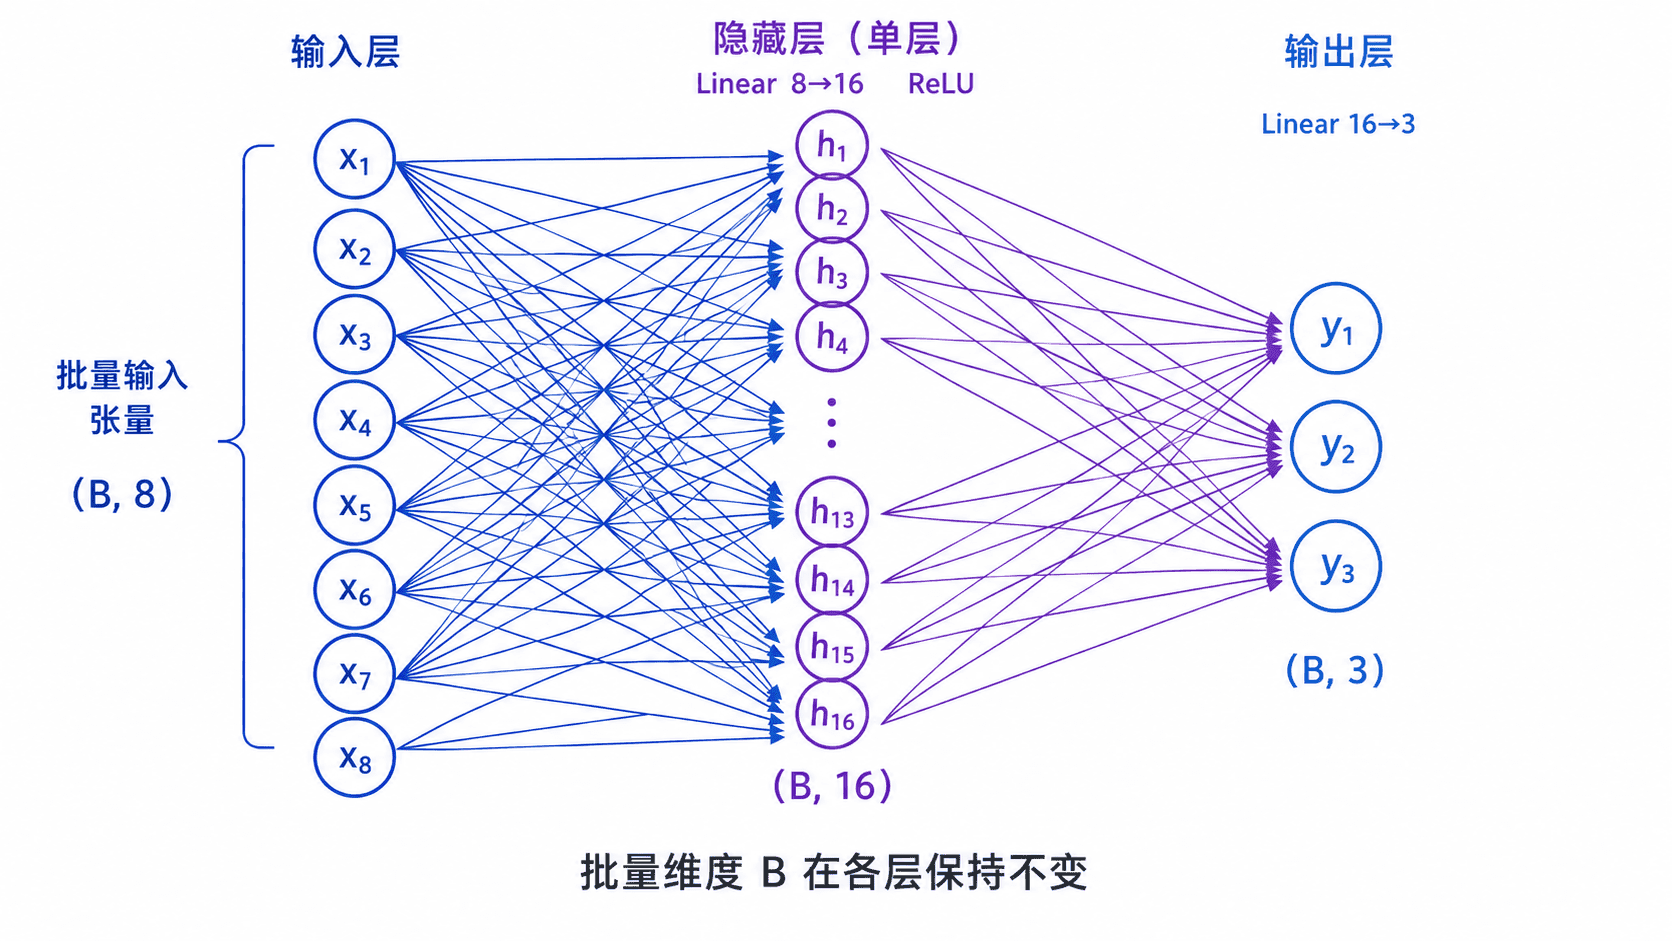
多层感知机(MLP)接收一批固定长度的特征,经过一个或多个全连接隐藏层,再生成最终输出。输入层只是数据入口,通常不需要单独声明;真正参与计算的第一层是接收输入特征的 nn.Linear。
假设每个样本有 8 个特征,隐藏层包含 16 个神经元,任务需要输出 3 个类别分数,则计算关系可以写成 ,再由 得到输出。
用 nn.Module 实现网络
继承 nn.Module 后,通常在 __init__ 中声明可训练层,在 forward 中定义数据流。nn.Sequential 适合按固定顺序执行的前馈网络,可以减少样板代码。
python
import torch
from torch import nn

class MLP(nn.Module):
    def __init__(self, input_dim: int, hidden_dim: int, output_dim: int):
        super().__init__()
        # Sequential 按声明顺序完成线性变换、激活和输出映射
        self.network = nn.Sequential(
            nn.Linear(input_dim, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, output_dim),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.network(x)

def main() -> None:
    torch.manual_seed(0)
    model = MLP(input_dim=8, hidden_dim=16, output_dim=3)

    # 4 表示批量大小,8 表示每个样本的特征数
    x = torch.randn(4, 8)
    logits = model(x)

    parameter_count = sum(p.numel() for p in model.parameters())
    print(f'输入形状: {tuple(x.shape)}')
    print(f'输出形状: {tuple(logits.shape)}')
    print(f'可训练参数量: {parameter_count}')

    # 输出必须保留批量大小,并转换为 3 个类别分数
    assert logits.shape == (4, 3)

if __name__ == '__main__':
    main()
预期输出
text
输入形状: (4, 8)
输出形状: (4, 3)
可训练参数量: 195
读懂参数量
第一层参数量为 ,其中矩阵权重占 128 个参数,偏置占 16 个参数。第二层参数量为 ,因此总参数量是 195。
隐藏层宽度决定模型能够组合多少中间特征,但宽度越大,参数量、显存占用和过拟合风险也会增加。初学阶段应先保证输入维度与输出维度正确,再逐步调整隐藏层数量和宽度。
输出层的关键边界
若后续使用 nn.CrossEntropyLoss 完成多分类训练,输出层应直接返回未归一化的 logits,不要在模型末尾手动添加 Softmax。该损失函数内部已经包含数值更稳定的归一化计算。
如果任务是回归,输出维度通常等于目标变量数量,最后一层是否添加激活函数取决于目标范围。例如目标必须非负时,可以根据业务约束选择合适的输出变换。
本课总结
- 多层感知机由线性层和非线性激活按前馈顺序组成
nn.Module负责组织参数与计算流程,nn.Sequential适合固定顺序的网络- 输出形状和参数量是验证模型结构最直接的两个指标
下一课预告
下一课将逐层跟踪前向传播中的张量形状,重点理解批量维度为何保持不变,以及特征维度如何随线性层发生变化。
按自己的节奏,确认真正理解。