
机器学习与深度学习 / 系统课时
损失函数的选择
损失函数的选择
损失函数决定模型“错了多少”以及梯度如何推动参数更新。本课从标签形式、输出层和损失函数三者的匹配关系出发,建立回归、二分类和多分类任务的选择规则,并用 PyTorch 验证常见组合。
学习目标
- 根据任务类型和标签形式选择损失函数
- 正确匹配输出层维度、激活函数与损失输入
- 避免重复使用 Sigmoid 或 Softmax 等常见错误
先看任务与标签
选择损失函数时,先判断模型要预测什么,而不是先看网络结构。回归输出连续数值;二分类判断一个样本是否属于某类;多分类则从多个互斥类别中选择一个。
| 任务 | 标签示例 | 输出形状 | 常用损失 |
|---|---|---|---|
| 回归 | 3.7、-1.2 |
[batch, 1] 或与目标一致 |
MSELoss、L1Loss |
| 二分类 | 0 或 1 |
[batch, 1] |
BCEWithLogitsLoss |
| 多分类 | 类别编号 0...C-1 |
[batch, C] |
CrossEntropyLoss |
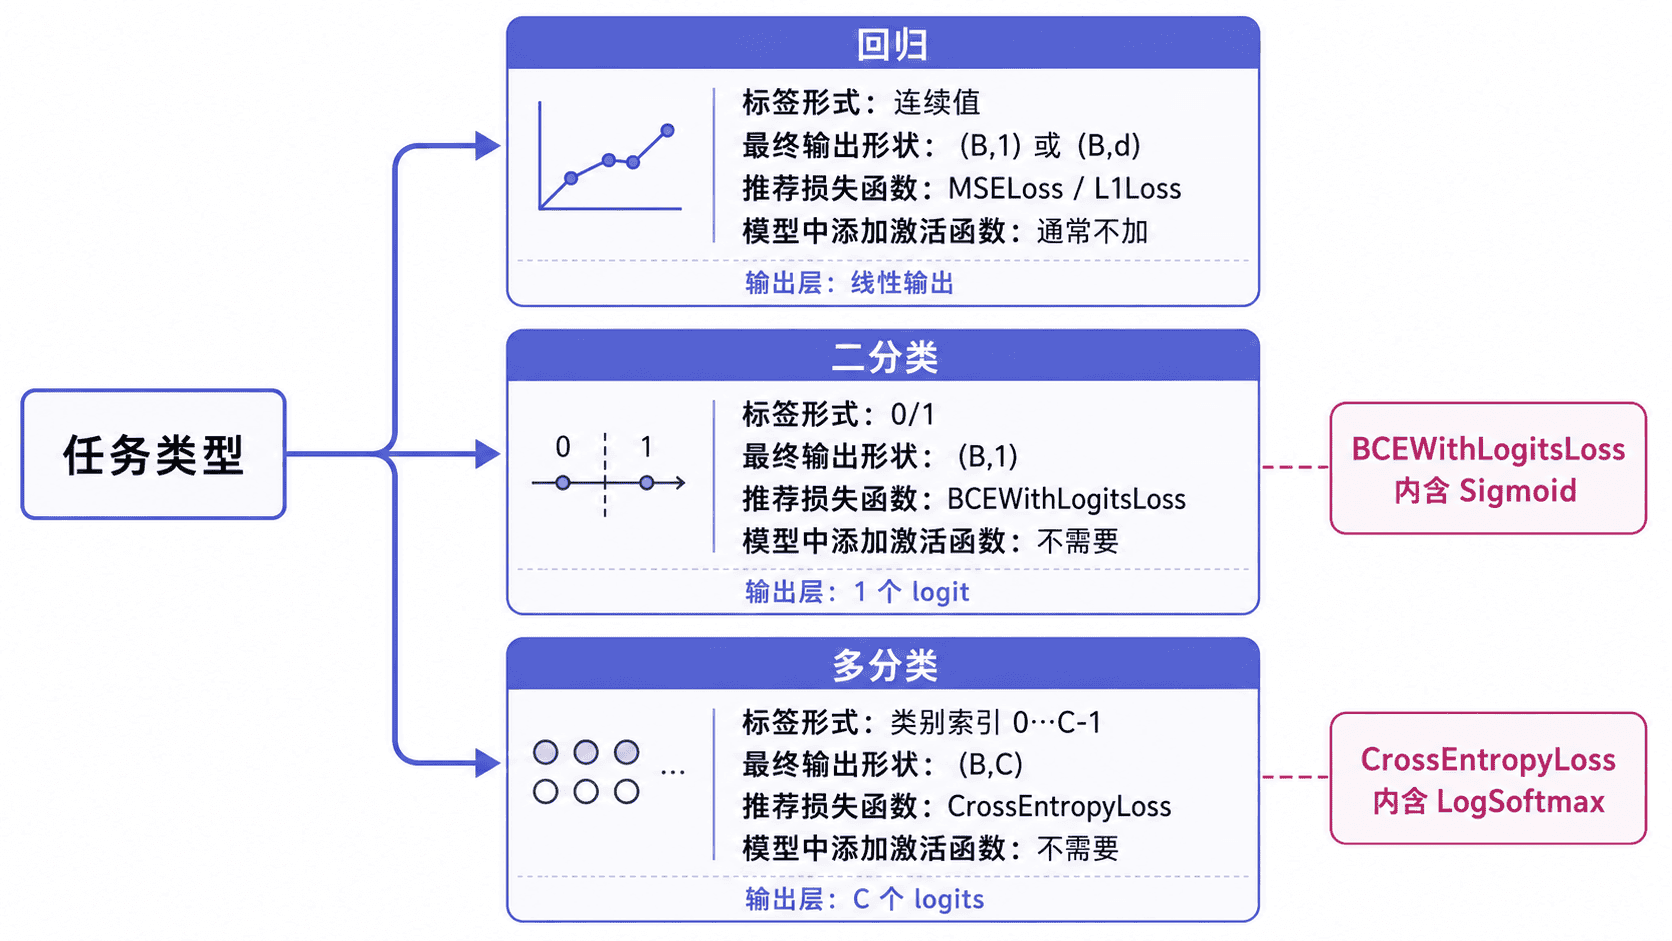
三类任务的标准组合
回归通常直接输出实数。均方误差衡量预测值与目标值的平方差:
MSELoss 对较大误差惩罚更强,适合误差近似对称且异常值不多的场景。L1Loss 使用绝对误差,对异常值更稳健,但在零点附近的梯度不如均方误差平滑。
二分类推荐让模型输出一个未经 Sigmoid 的 logit,再交给 BCEWithLogitsLoss。该损失把 Sigmoid 与二元交叉熵合并计算,数值稳定性优于先调用 sigmoid() 再使用 BCELoss。
多分类任务让模型输出 个 logits,标签使用类别编号。CrossEntropyLoss 内部已经包含 LogSoftmax 与负对数似然,因此训练前不要手动调用 softmax()。
用 PyTorch 验证三种损失
下面的程序分别计算回归、二分类和三分类损失。示例使用固定张量,因此输出可重复。
import torch
from torch import nn

# 回归:预测值和目标值形状一致
reg_pred = torch.tensor([2.5, 0.0])
reg_target = torch.tensor([3.0, -1.0])
reg_loss = nn.MSELoss()(reg_pred, reg_target)

# 二分类:直接传入 logits,不先做 Sigmoid
binary_logits = torch.tensor([0.0, 2.0])
binary_target = torch.tensor([0.0, 1.0])
binary_loss = nn.BCEWithLogitsLoss()(binary_logits, binary_target)

# 多分类:每行是各类别 logits,标签是类别编号
class_logits = torch.tensor([[2.0, 1.0, 0.0], [0.0, 1.0, 2.0]])
class_target = torch.tensor([0, 2])
class_loss = nn.CrossEntropyLoss()(class_logits, class_target)

print(f"regression: {reg_loss.item():.4f}")
print(f"binary: {binary_loss.item():.4f}")
print(f"multiclass: {class_loss.item():.4f}")
预期输出:
regression: 0.6250
binary: 0.4100
multiclass: 0.4076
这些数值只用于确认接口与输入形式正确。真实训练中,损失大小还会受到数据尺度、类别数量、样本难度和归约方式影响,不能跨任务直接比较。
关键边界与常见错误
使用 BCEWithLogitsLoss 时,目标通常应为浮点数,并与 logits 形状一致。使用 CrossEntropyLoss 时,目标应为 torch.long 类型的一维类别编号,而不是默认的独热向量。
最常见的错误是重复激活:模型末尾先做 Sigmoid,再传给 BCEWithLogitsLoss;或者先做 Softmax,再传给 CrossEntropyLoss。这样会改变梯度并降低数值稳定性。
类别极不平衡时,二分类可使用 pos_weight 提高正类权重,多分类可使用 weight 调整各类别贡献。加权前应先检查数据分布,避免仅凭损失值猜测问题。
选择时的最小检查清单
- 标签是连续值、二元标记,还是互斥类别编号
- 模型输出维度是否与损失函数预期一致
- 损失函数是否已经内置 Sigmoid 或 Softmax 相关计算
- 标签的数据类型与形状是否正确
- 类别不平衡是否需要权重,而不是直接更换任务定义
本课总结
- 回归、二分类和多分类必须分别匹配输出形状与损失函数
BCEWithLogitsLoss和CrossEntropyLoss都应直接接收 logits- 选择损失后仍要检查标签类型、形状和类别分布
下一课预告
下一课将构建一个只有少量参数的小型网络,手工计算前向结果和局部梯度,再与 PyTorch 自动微分得到的梯度逐项对照。