
机器学习与深度学习 / 系统课时
序列数据与时间依赖
序列数据与时间依赖
本课解决两个核心问题:序列数据与普通表格数据有什么不同,以及怎样把时间顺序转换成模型可学习的输入与目标。完成后,你能识别文本、时间序列和事件序列中的依赖,并正确构造滑动窗口样本。
学习目标
- 区分文本序列、时间序列和事件序列的输入形式
- 理解顺序、间隔和上下文对预测结果的影响
- 使用滑动窗口构造基础监督学习样本
序列数据是什么
序列数据由按某种顺序排列的元素组成。每个元素不仅具有自身取值,还可能受到前面元素、后面元素或时间间隔的影响,因此不能随意打乱。
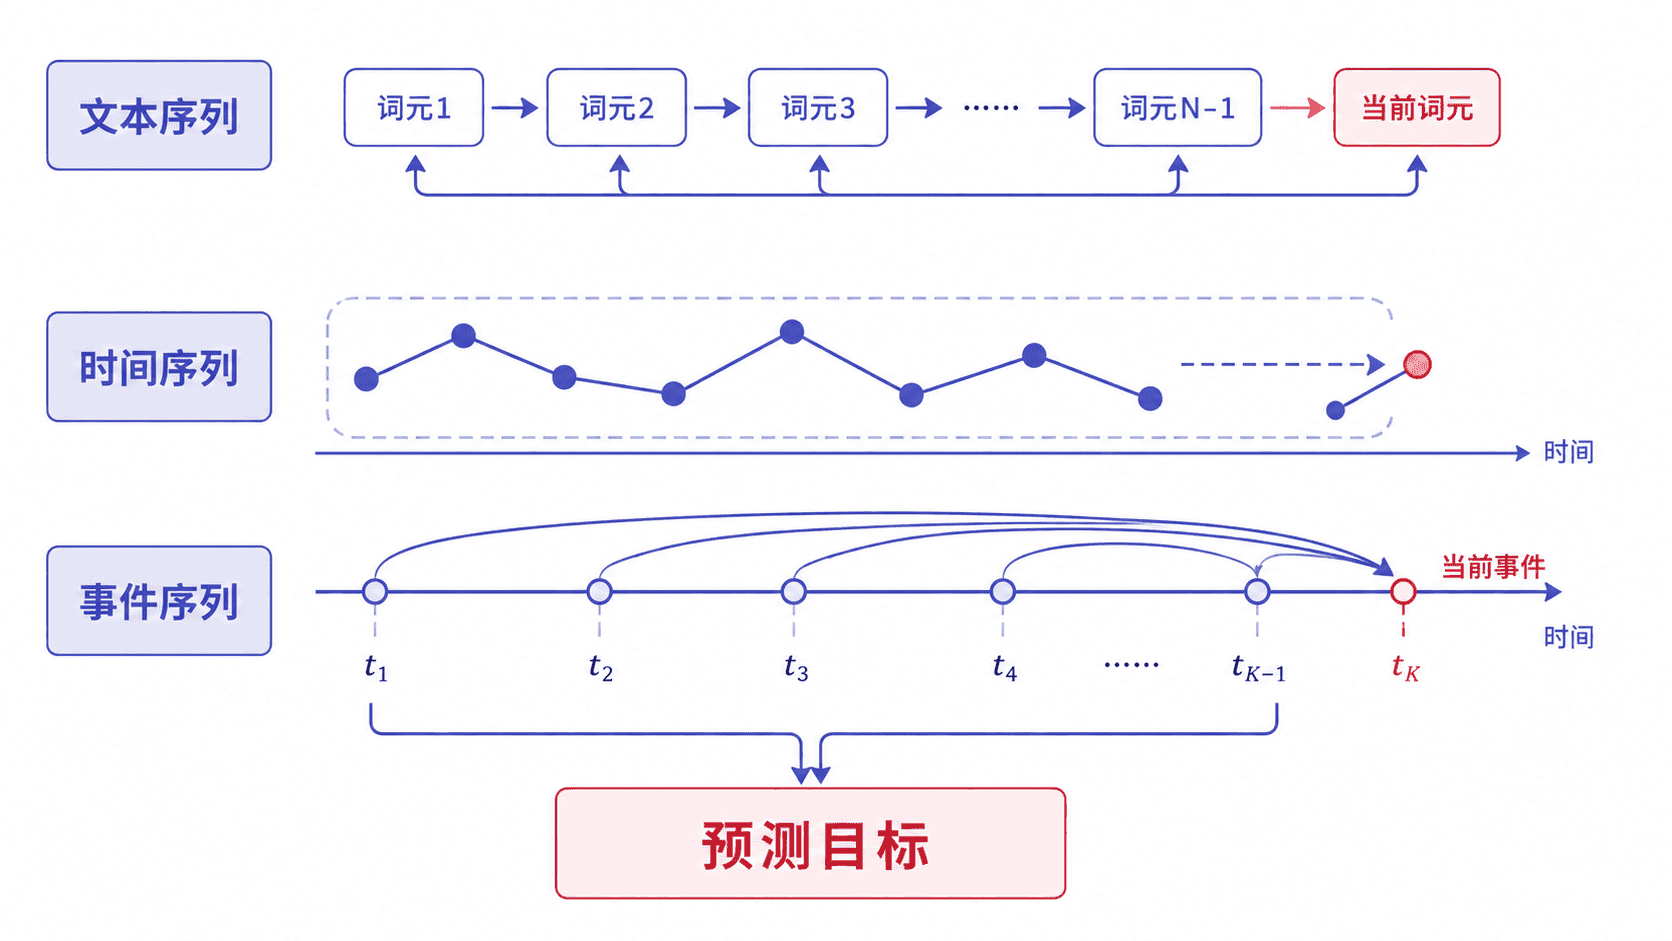
文本序列通常由字符、子词或单词组成,例如“深度学习”可表示为依次排列的多个词元。模型需要利用前文判断词义、语法关系或下一个词元。
时间序列是在连续或固定时间点采集的数值,例如每小时温度、每日销量和服务器负载。事件序列则记录不规则发生的行为,例如点击、支付、登录和设备告警,并可能同时包含事件类型与发生时间。
时间依赖为何重要
普通表格中的每一行通常可以独立解释,而序列中的当前位置需要结合上下文。例如,同一个词在不同语句中的含义可能不同;同样是销量 100,处于持续上升阶段和持续下降阶段时,下一时刻的预测也会不同。
时间依赖主要包含三种信息:元素出现的先后顺序、相邻元素之间的距离,以及较早历史对当前结果的影响。若训练前直接随机打乱所有时间点,这些信息会被破坏,模型只能学习单点取值,无法学习变化规律。
序列依赖也可能跨越较长距离。例如,一段文章末尾的代词可能指向开头出现的人物,设备当前故障也可能与数小时前的异常升温有关。这类现象称为长期依赖,是循环网络需要重点处理的问题。
构造监督学习样本
处理数值序列时,常用滑动窗口把连续历史值转换成输入和目标。窗口长度决定模型每次能够直接观察多少个历史位置。
下面的程序使用连续 3 个数值预测下一个数值。示例只负责构造样本,不包含模型训练。
def build_windows(values, window_size):
    samples = []
    for end in range(window_size, len(values)):
        start = end - window_size
        # 保留原始时间顺序,窗口后的第一个值作为预测目标
        samples.append((values[start:end], values[end]))
    return samples

series = [10, 12, 15, 14, 18]

for features, target in build_windows(series, window_size=3):
    print(f"input={features}, target={target}")
预期输出:
input=[10, 12, 15], target=14
input=[12, 15, 14], target=18
第一个样本使用前三个时间点预测第四个时间点,窗口随后向右移动一个位置。真实任务中还可以同时加入星期、天气、事件类型等附加特征,但这些特征必须与对应时间点准确对齐。
建模时的关键边界
训练集、验证集和测试集应优先按照时间先后切分。若随机切分窗口,相邻窗口可能共享大量数据,使未来信息间接进入训练集,最终得到虚高的评估结果。
不同序列长度不一致时,通常需要补齐到统一长度,并用掩码标记补齐位置,避免模型把填充值当成真实输入。事件发生间隔不规则时,还应显式保留时间戳、持续时间或相邻事件间隔。
窗口越长,模型获得的历史信息越多,但计算量和无关噪声也会增加。窗口长度应结合业务周期、有效依赖范围和验证集结果选择,而不是简单设置得越大越好。
本课总结
- 序列数据的核心特征是元素之间存在顺序、间隔和上下文依赖
- 滑动窗口可以把连续序列转换成可训练的输入与目标
- 时间切分、变长掩码和信息泄漏是序列建模中的关键边界
下一课预告
下一课将处理文本等离散序列,依次完成词元切分、词表编号,并使用嵌入层把离散编号转换为可学习的稠密向量。