
机器学习与深度学习 / 系统课时
变分自编码器
变分自编码器
变分自编码器把“压缩后再还原”改造成“学习一个可采样的潜在概率空间”。本课将从概率潜变量、重参数化和证据下界三个核心概念出发,并用一个最小 PyTorch 示例验证完整前向与损失计算。
学习目标
- 理解编码器为何输出潜变量分布参数,而不是单个确定向量
- 掌握重参数化技巧如何让随机采样参与反向传播
- 能解释证据下界中重构项与 KL 散度项的作用
为什么普通自编码器不擅长生成
普通自编码器把输入压缩成一个确定向量,再由解码器重构原始数据。它能学习压缩表示,却不会主动约束潜在空间的整体形状,因此不同样本的编码结果可能形成彼此分离、分布不规则的区域。
生成新样本时,我们希望从潜在空间随机取一点,再交给解码器。若采样点落在训练数据从未覆盖的空隙中,解码器往往只能输出无意义结果。变分自编码器的关键改动,就是把每个输入映射成一个概率分布,并让这些分布整体接近一个简单先验。
概率潜变量与重参数化
编码器不直接输出潜变量 ,而是输出均值 和对数方差 ,由它们定义近似后验分布:
训练时需要从该分布采样。直接采样会让随机节点阻断梯度,因此使用重参数化技巧:先从标准正态分布采样噪声 ,再通过可微运算得到 。
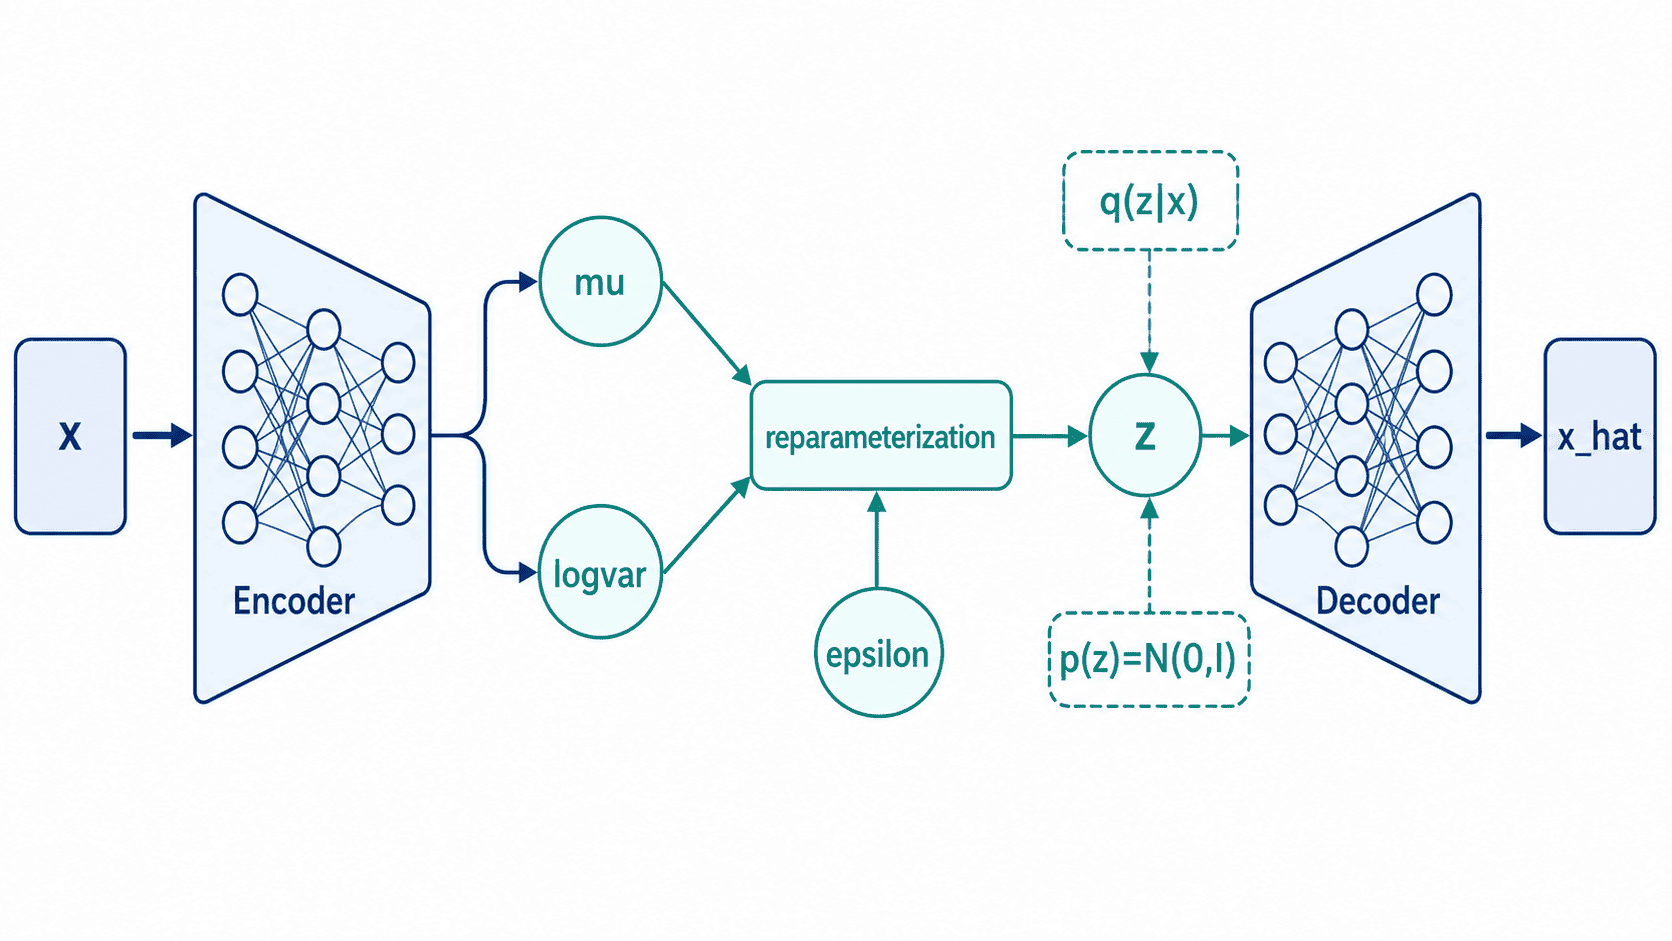
这样一来,随机性被隔离在与参数无关的 中,梯度仍可沿着 回传到 和 ,编码器便能通过梯度下降学习分布参数。
证据下界如何约束潜在空间
变分自编码器通常最小化两个部分之和:重构损失负责让输出接近输入,KL 散度负责让近似后验接近标准正态先验。对应的证据下界可写为:
实现时常把它改写为需要最小化的负值。重构项过强而 KL 项过弱,潜在空间会不规则;KL 项过强,编码器可能忽略输入差异,出现“后验坍塌”。两项的平衡决定了重构质量与可采样性的取舍。
当近似后验是对角高斯、先验是标准正态时,KL 散度可以直接计算:
最小可运行示例
下面的示例使用随机生成的二值向量模拟一个批次,只验证编码、重参数化、解码和损失计算是否连通,不承担真实数据建模效果。
import torch
from torch import nn
from torch.nn import functional as F

class VAE(nn.Module):
    def __init__(self, input_dim: int = 16, hidden_dim: int = 12, latent_dim: int = 4):
        super().__init__()
        self.encoder = nn.Sequential(
            nn.Linear(input_dim, hidden_dim),
            nn.ReLU(),
        )
        self.mu_layer = nn.Linear(hidden_dim, latent_dim)
        self.logvar_layer = nn.Linear(hidden_dim, latent_dim)
        self.decoder = nn.Sequential(
            nn.Linear(latent_dim, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, input_dim),
            nn.Sigmoid(),
        )

    def reparameterize(self, mu: torch.Tensor, logvar: torch.Tensor) -> torch.Tensor:
        # logvar 转为标准差后,把随机性隔离到 eps 中。
        std = torch.exp(0.5 * logvar)
        eps = torch.randn_like(std)
        return mu + std * eps

    def forward(self, x: torch.Tensor):
        hidden = self.encoder(x)
        mu = self.mu_layer(hidden)
        logvar = self.logvar_layer(hidden)
        z = self.reparameterize(mu, logvar)
        return self.decoder(z), mu, logvar

def vae_loss(recon: torch.Tensor, x: torch.Tensor,
             mu: torch.Tensor, logvar: torch.Tensor) -> torch.Tensor:
    reconstruction = F.binary_cross_entropy(recon, x, reduction="sum")
    kl = -0.5 * torch.sum(1 + logvar - mu.pow(2) - logvar.exp())
    return reconstruction + kl

torch.manual_seed(7)
model = VAE()
batch = torch.randint(0, 2, (8, 16), dtype=torch.float32)

recon, mu, logvar = model(batch)
loss = vae_loss(recon, batch, mu, logvar)

print("recon_shape:", tuple(recon.shape))
print("latent_shape:", tuple(mu.shape))
print("finite_loss:", bool(torch.isfinite(loss)))
预期输出:
recon_shape: (8, 16)
latent_shape: (8, 4)
finite_loss: True形状验证说明编码器与解码器维度匹配,finite_loss 为 True 说明重构项和 KL 项都能正常参与计算。真实训练时还需要加入优化器、训练循环和验证集,并根据数据类型选择合适的重构分布。
生成新样本与常见误区
训练完成后,生成阶段不再需要输入样本。直接从 采样潜变量,再调用解码器即可得到新样本。若只把编码器输出的均值送入解码器,模型会失去随机采样能力,退化为接近普通自编码器的确定性路径。
另一个常见误区是把 KL 散度理解成“越小越好”。KL 项确实要求后验接近先验,但若所有输入都被压到完全相同的分布,潜变量将不再携带有效信息。实践中常使用 KL 权重预热或 -VAE 调节两项比例。
本课总结
- 变分自编码器学习的是潜变量分布,使潜在空间能够被连续采样
- 重参数化把随机采样改写成可微计算,让分布参数能够参与反向传播
- 证据下界同时优化重构质量与先验约束,两者需要保持合理平衡
下一课预告
下一课将学习生成对抗网络,理解生成器与判别器如何通过对抗训练共同提升,以及这种训练为什么容易出现震荡和模式坍塌。