
机器学习与深度学习 / 系统课时
权重衰减与参数约束
权重衰减与参数约束
模型在训练集上持续降低损失时,参数可能变得过大并记住噪声。本课从目标函数和参数更新两条路径理解 L1、L2 与解耦权重衰减,并用 PyTorch 验证 AdamW 如何只衰减指定参数。
学习目标
- 解释 L1、L2 正则化如何限制参数规模
- 区分 L2 正则项与解耦权重衰减
- 在 PyTorch 中正确配置需要衰减和不应衰减的参数
参数约束解决什么问题
仅最小化训练损失时,模型会优先寻找能贴合当前样本的参数组合,其中可能包含绝对值很大的权重。大权重会放大输入扰动,使模型对训练数据中的偶然模式更敏感。参数约束通过偏好“更简单”的解,降低这种敏感性。
常见做法是在原始损失后增加惩罚项。L1 使用参数绝对值之和,L2 使用参数平方和:
其中, 控制约束强度。它越大,参数被压缩得越明显,但过大也会造成欠拟合。
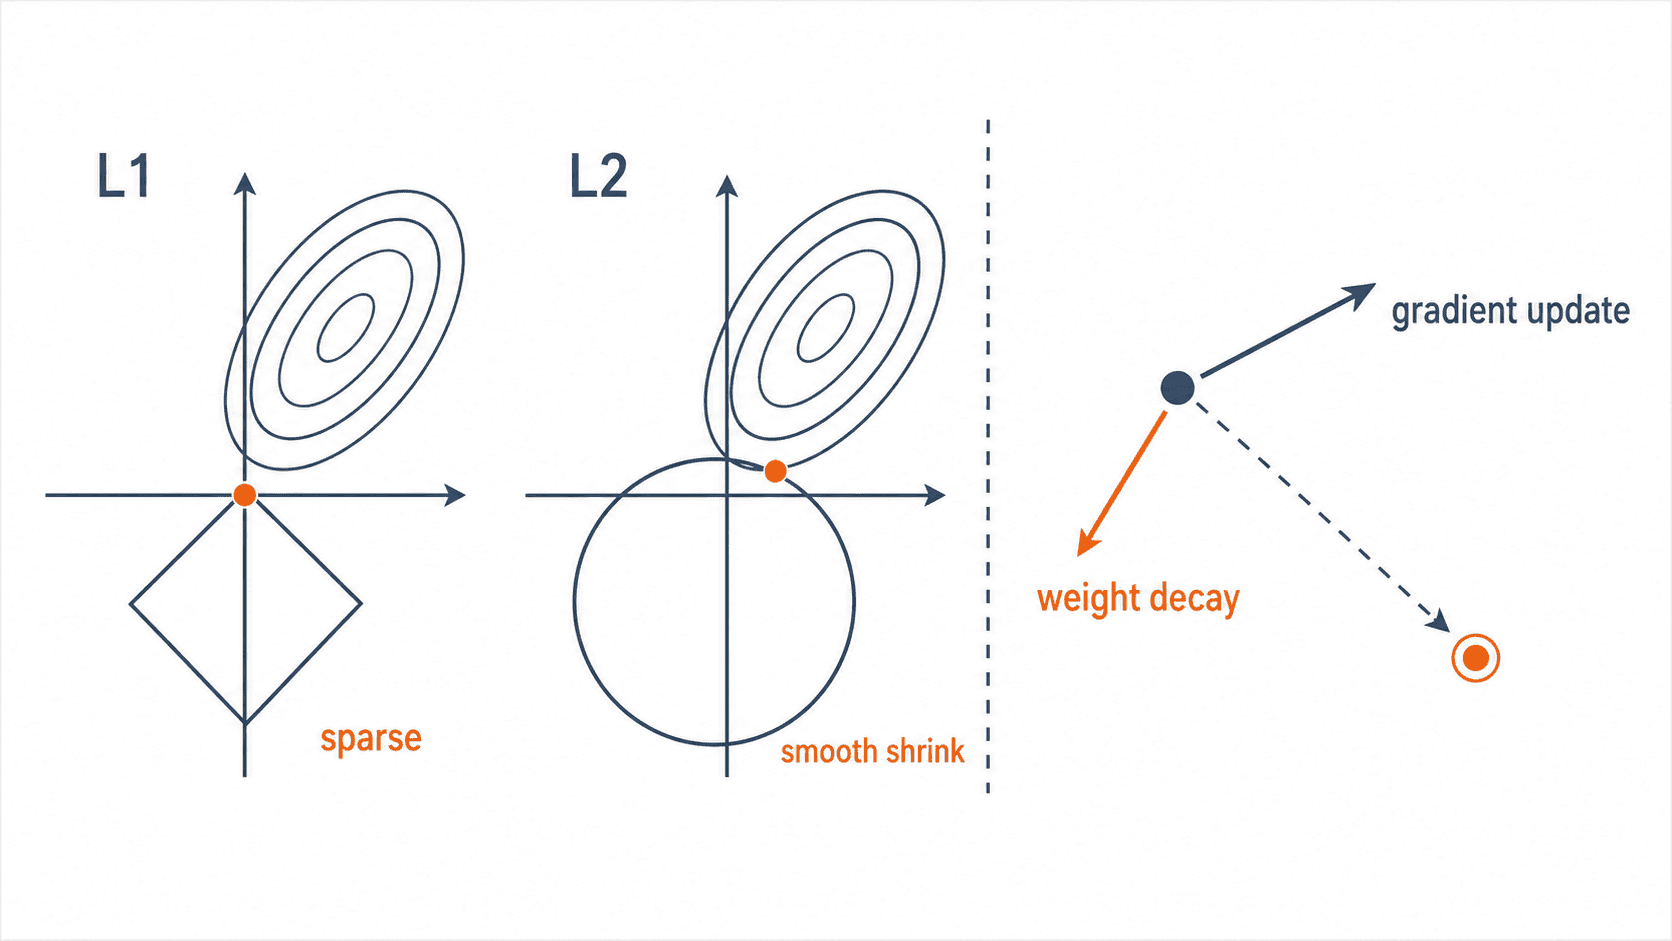
L1 与 L2 的差异
L1 的梯度在参数非零时主要取决于符号,因此会以近似固定力度把参数推向零,容易得到稀疏权重。它适合希望自动筛除部分特征的场景,但在零点不可导,优化时通常依赖次梯度。
L2 的梯度与参数值成正比:参数越大,受到的回拉越强;参数越小,回拉越弱。它通常不会直接产生大量精确零值,却能让参数分布更平滑,是神经网络中更常见的默认选择。
| 方法 | 主要效果 | 常见注意点 |
|---|---|---|
| L1 | 促进稀疏,部分参数变为零 | 可能让优化更不平滑 |
| L2 | 平滑压缩大参数 | 通常不会产生精确稀疏 |
| 解耦权重衰减 | 在优化器更新外直接缩小参数 | 衰减系数需与学习率共同调节 |
为什么要解耦权重衰减
在普通随机梯度下降中,把 L2 惩罚加入损失后,参数更新可写为:
它看起来等价于先按比例缩小参数,再执行梯度更新。但在 Adam 等自适应优化器中,梯度会被动量和二阶矩重新缩放,L2 惩罚产生的梯度也会一起被缩放,因此不再等价于直接衰减参数。
AdamW 将两件事分开:自适应梯度负责优化数据损失,权重衰减独立地按比例缩小参数。这样衰减含义更稳定,也更便于单独调节。
使用 PyTorch 配置 AdamW
下面用一个可运行的最小示例验证:权重组设置衰减,偏置组不设置衰减;即使梯度为零,权重仍会按比例缩小。
import torch
from torch import nn

weight = nn.Parameter(torch.tensor([2.0]))
bias = nn.Parameter(torch.tensor([1.0]))

optimizer = torch.optim.AdamW(
    [
        {"params": [weight], "weight_decay": 0.1},
        {"params": [bias], "weight_decay": 0.0},
    ],
    lr=0.01,
)

# 使用零梯度隔离出权重衰减本身的效果
weight.grad = torch.zeros_like(weight)
bias.grad = torch.zeros_like(bias)
optimizer.step()

print(f"weight={weight.item():.4f}")
print(f"bias={bias.item():.4f}")
print([group["weight_decay"] for group in optimizer.param_groups])
预期输出:
weight=1.9980
bias=1.0000
[0.1, 0.0]
实际模型通常把线性层和卷积层的权重放入衰减组,把偏置、归一化层的缩放参数与偏移参数放入不衰减组。这样可以避免对本就低维、承担校准作用的参数施加不必要约束。
选择与调参边界
优先从较小的衰减系数开始,并同时观察训练损失与验证损失。若训练损失明显升高且验证效果也变差,约束可能过强;若训练效果很好而验证差距持续扩大,才考虑增强衰减。
L1、L2 与 AdamW 的 weight_decay 不能只按数值直接比较。优化器、学习率、训练步数和参数分组都会改变实际作用强度,因此应在固定训练预算下通过验证集选择。
本课总结
- L1 倾向产生稀疏参数,L2 倾向平滑压缩大参数
- AdamW 将参数衰减与自适应梯度更新解耦,含义比直接加入 L2 更清晰
- 偏置和归一化参数通常不参与权重衰减,应使用参数分组控制
下一课预告
下一课将学习 Dropout 如何在训练阶段随机屏蔽神经元,并理解它为何必须在推理阶段关闭。