
机器学习与深度学习 / 系统课时
评估图像分类模型
评估图像分类模型
本课将把分类模型的预测结果转化为可解释的评估结论。除了总体准确率,还会使用混淆矩阵、精确率、召回率和错误样本清单,判断模型究竟把哪些类别混淆,以及下一步应优先补数据、调阈值还是改进模型。
学习目标
- 计算总体准确率以及各类别的精确率和召回率
- 按“真实类别为行、预测类别为列”解读混淆矩阵
- 从错误样本中识别数据质量、类别相似和分布偏差问题
准确率不能回答所有问题
准确率表示预测正确的样本比例:
当类别分布接近时,准确率能快速反映整体水平;当某个类别占比很高时,只预测多数类也可能得到看似不错的结果。因此,评估时还要分别观察每个类别的精确率和召回率。
精确率回答“预测为某类的样本中有多少是真的”,召回率回答“真实属于某类的样本中有多少被找出来”。二者分别关注误报和漏报。
用混淆矩阵定位混淆方向
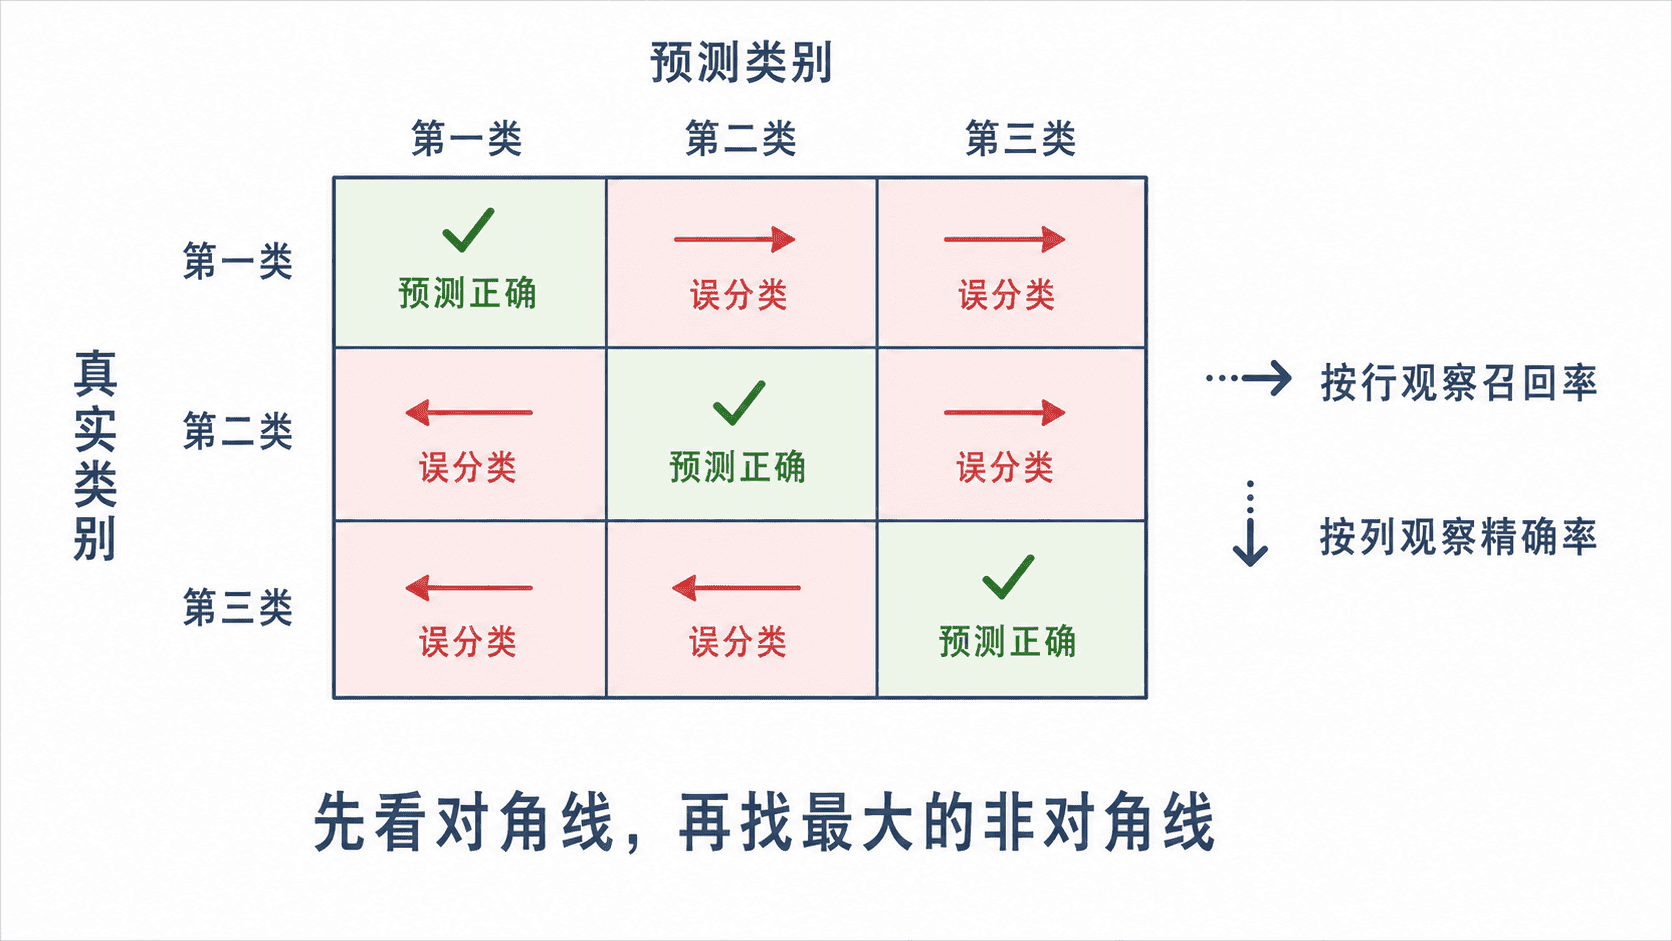
混淆矩阵中的第 行第 列,表示真实类别为 、却被预测成 的样本数。主对角线越大越好;最大的非对角线通常就是最值得优先处理的类别混淆。
必须固定类别顺序。若计算矩阵和显示名称时使用了不同顺序,图中的结论会被整体错配。
计算指标并导出错误样本
下面使用一组三分类预测结果完成完整评估。实际项目中,y_true 来自数据集标签,y_pred 来自模型输出最大概率对应的类别编号。
from pathlib import Path

import matplotlib.pyplot as plt
from sklearn.metrics import (
    ConfusionMatrixDisplay,
    accuracy_score,
    confusion_matrix,
    precision_recall_fscore_support,
)

class_names = ["cat", "dog", "bird"]
y_true = [0, 0, 1, 1, 1, 2, 2, 2, 2, 0]
y_pred = [0, 1, 1, 1, 2, 2, 0, 2, 2, 0]
sample_paths = [f"image_{index}.jpg" for index in range(len(y_true))]

accuracy = accuracy_score(y_true, y_pred)
precision, recall, _, support = precision_recall_fscore_support(
    y_true,
    y_pred,
    labels=[0, 1, 2],
    zero_division=0,
)
matrix = confusion_matrix(y_true, y_pred, labels=[0, 1, 2])

print(f"accuracy: {accuracy:.2f}")
for index, name in enumerate(class_names):
    print(
        f"{name}: precision={precision[index]:.2f}, "
        f"recall={recall[index]:.2f}, support={support[index]}"
    )

wrong_samples = [
    (path, class_names[truth], class_names[prediction])
    for path, truth, prediction in zip(sample_paths, y_true, y_pred)
    if truth != prediction
]
print("wrong samples:")
for path, truth_name, prediction_name in wrong_samples:
    print(f"- {path}: true={truth_name}, pred={prediction_name}")

# 保存矩阵图,行是真实类别,列是预测类别。
display = ConfusionMatrixDisplay(
    confusion_matrix=matrix,
    display_labels=class_names,
)
display.plot(cmap="Blues", values_format="d")
plt.tight_layout()
plt.savefig("confusion_matrix.png", dpi=150)
print("matrix saved:", Path("confusion_matrix.png"))
预期输出如下:
accuracy: 0.70
cat: precision=0.67, recall=0.67, support=3
dog: precision=0.67, recall=0.67, support=3
bird: precision=0.75, recall=0.75, support=4
wrong samples:
- image_1.jpg: true=cat, pred=dog
- image_4.jpg: true=dog, pred=bird
- image_6.jpg: true=bird, pred=cat
matrix saved: confusion_matrix.png
从指标进入错误样本分析
指标告诉你“哪里有问题”,原始样本才能解释“为什么出错”。应把错误样本按真实类别、预测类别和置信度排序,优先检查数量最多或置信度最高的误判。
若同一对类别反复混淆,可能是视觉特征相近或标签定义重叠;若错误集中在模糊、遮挡和极端角度,说明训练数据覆盖不足;若明显错误标签较多,应先清洗数据,而不是继续增加模型复杂度。
评估集必须与训练过程隔离。不要根据测试集反复调参,否则测试结果会逐渐变成调参结果,无法代表模型对新数据的真实泛化能力。
建立可执行的验收标准
模型上线前应同时设置整体指标和类别级指标。例如,要求总体准确率不低于某阈值,同时要求关键类别召回率达到业务底线。对于漏检代价更高的任务,应优先保证召回率;对于误报代价更高的任务,则应优先保证精确率。
每次评估还应保存类别顺序、样本版本和错误样本清单。只有输入数据与映射可追溯,不同训练版本之间的指标比较才有意义。
本课总结
- 准确率反映整体正确比例,但不能替代类别级精确率和召回率
- 混淆矩阵通过非对角线揭示具体的误分类方向
- 错误样本分析应连接指标与数据问题,并转化为补数据、清标签或改模型的行动
下一课预告
下一课将把卷积网络、图像数据管线和评估方法整合为完整训练项目,并加入模型保存、加载与推理验证。